# 面试高频手写题
建议优先掌握:
instanceof- 考察对原型链的理解new- 对创建对象实例过程的理解call/apply/bind- 对this指向的理解- 手写
promise- 对异步的理解 - 手写原生
ajax- 对ajax原理和http请求方式的理解,重点是get和post请求的实现
# 1 实现防抖函数(debounce)
⚡ 30 秒速记
- 防抖把连续触发合并成一次,核心是每次调用先清掉旧定时器再重新计时
- 面试基础版要保留
this和参数,返回值需求则要区分立即执行与延迟执行 - 完整版可补
leading、trailing、cancel、flush - 典型场景是搜索联想和输入校验,不适合要求固定频率反馈的滚动采样
防抖就是把一段时间内的连续触发合并为一次,基本实现是每次调用先清除旧定时器,再重新计时。 返回函数要保留调用时的 this 和参数,定时结束后通过 func.apply(this, args) 执行原函数。它和节流不同:防抖通常只执行连续操作的最后一次,节流则按固定间隔执行。搜索联想、输入校验适合防抖;如果业务需要持续、固定频率的反馈,就更适合节流,完整实现还可按需求增加 leading、trailing、cancel 和 flush。
防抖函数原理:把触发非常频繁的事件合并成一次去执行 在指定时间内只执行一次回调函数,如果在指定的时间内又触发了该事件,则回调函数的执行时间会基于此刻重新开始计算
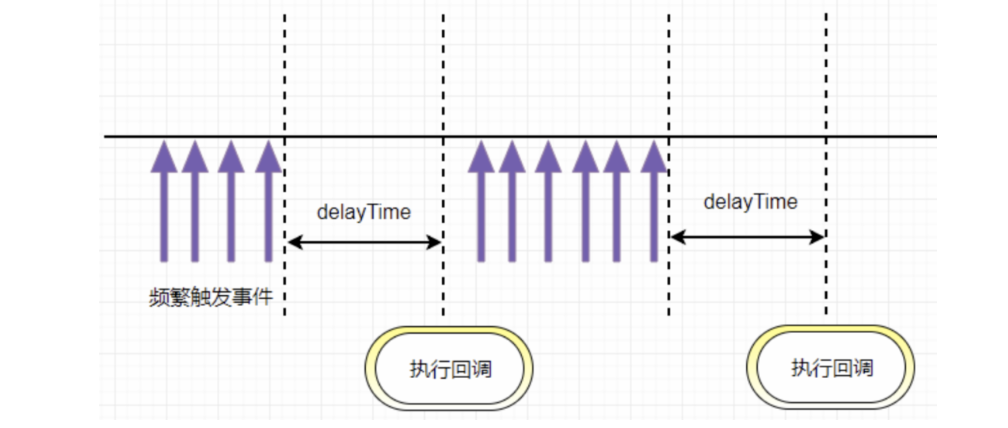
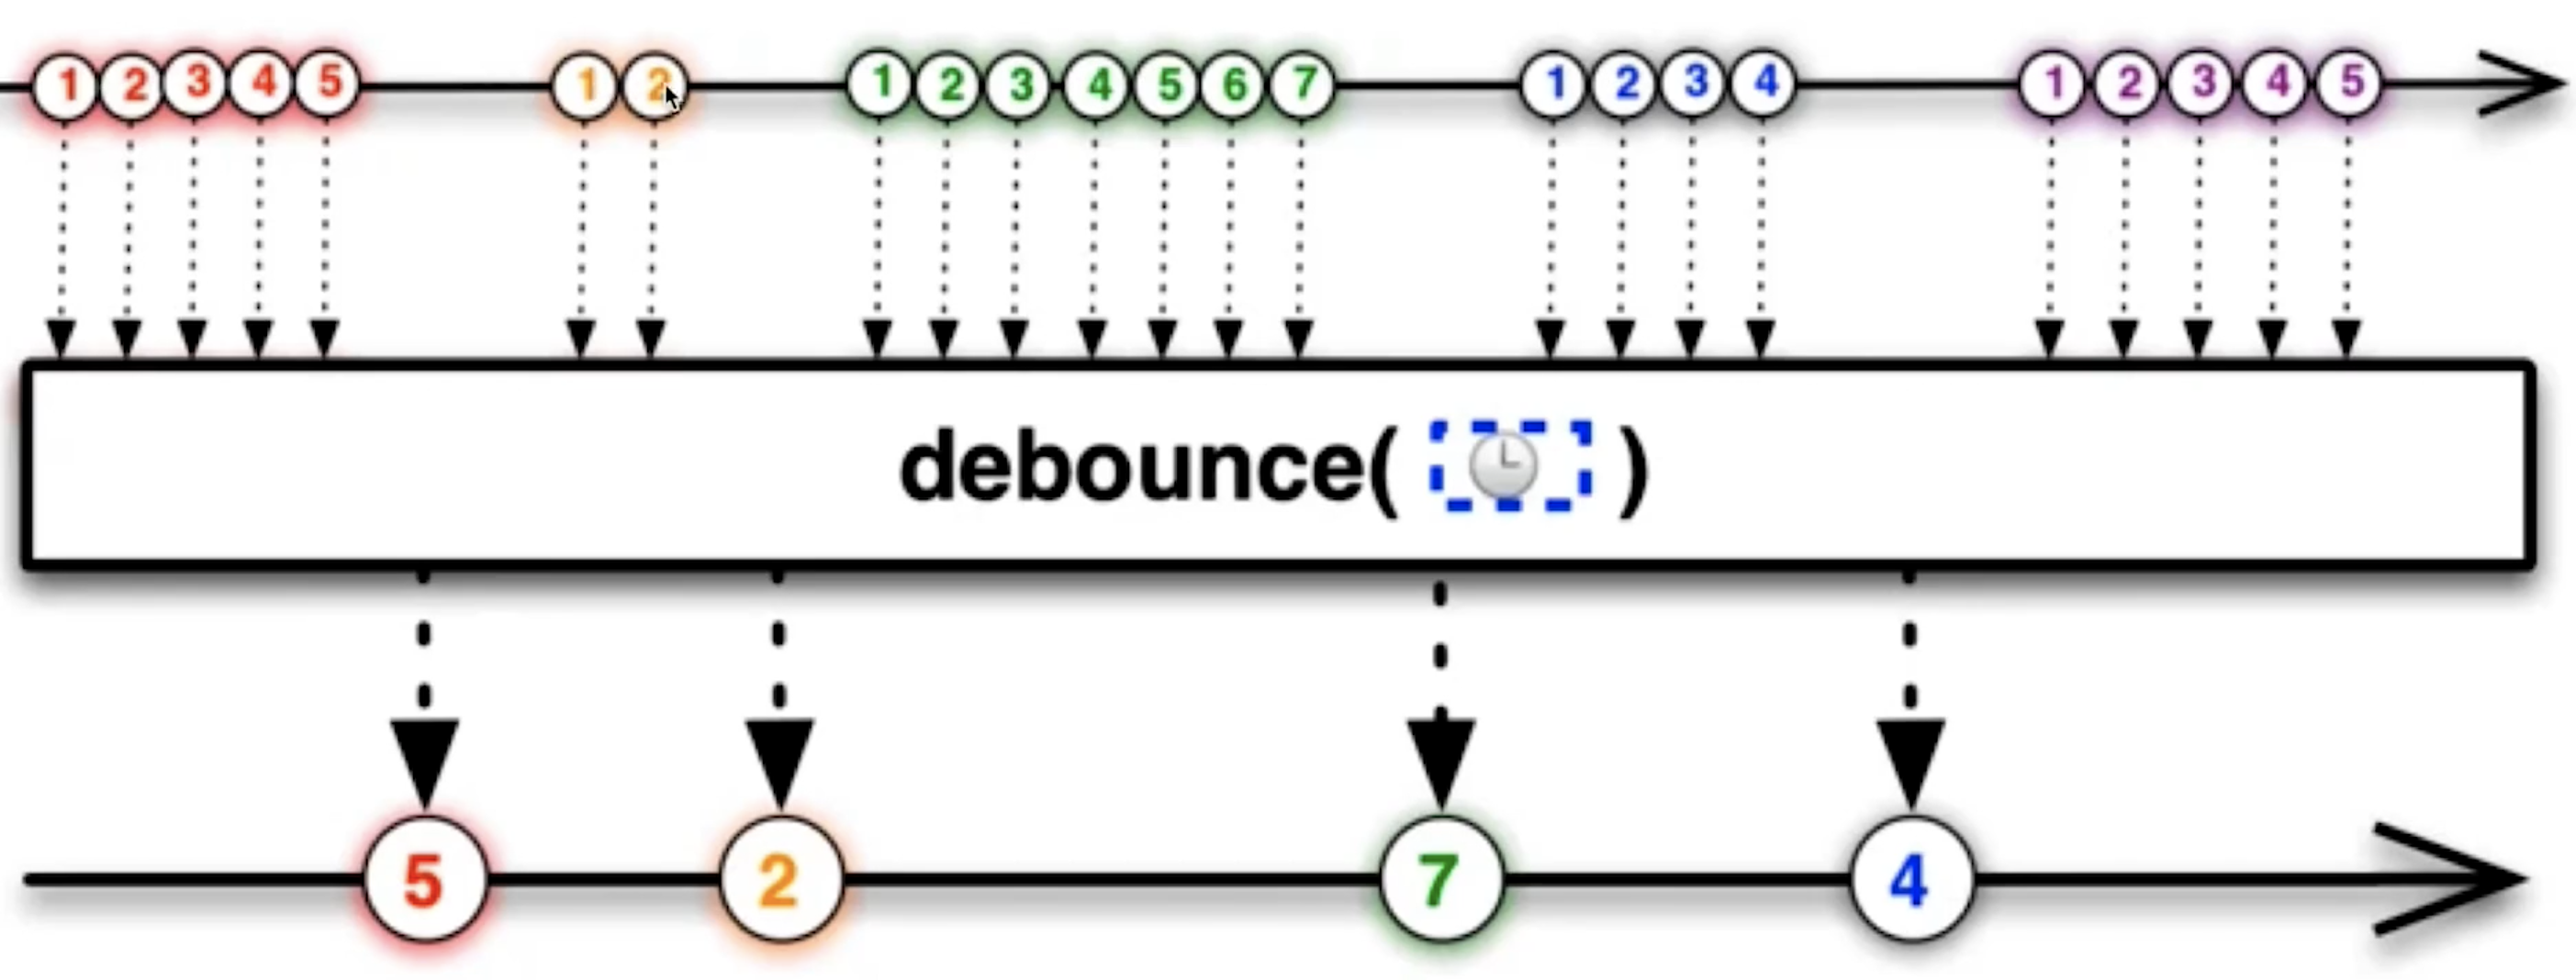
防抖动和节流本质是不一样的。防抖动是将多次执行变为最后一次执行,节流是将多次执行变成每隔一段时间执行
eg. 像百度搜索,就应该用防抖,当我连续不断输入时,不会发送请求;当我一段时间内不输入了,才会发送一次请求;如果小于这段时间继续输入的话,时间会重新计算,也不会发送请求。
手写简化版:
// func是用户传入需要防抖的函数
// wait是等待时间
const debounce = (func, wait = 50) => {
  // 缓存一个定时器id
  let timer = 0
  // 这里返回的函数是每次用户实际调用的防抖函数
  // 如果已经设定过定时器了就清空上一次的定时器
  // 开始一个新的定时器,延迟执行用户传入的方法
  return function(...args) {
    if (timer) clearTimeout(timer)
    timer = setTimeout(() => {
      func.apply(this, args)
    }, wait)
  }
}
适用场景:
- 文本输入的验证,连续输入文字后发送 AJAX 请求进行验证,验证一次就好
- 按钮提交场景:防止多次提交按钮,只执行最后提交的一次
- 服务端验证场景:表单验证需要服务端配合,只执行一段连续的输入事件的最后一次,还有搜索联想词功能类似
💬 面试官追问
搜索框连续输入“前端面试”时每次按键都发请求,而产品要求停顿一段时间后只查最后一次,你为什么不能用固定间隔节流?
这里应使用防抖,每次输入都清除旧定时器并重新计时,只有停止输入达到
wait后才执行最后一次回调。节流会在输入过程中按间隔持续触发请求,不符合合并为最后一次执行的目标,代价是防抖期间不会产生中间结果。表单用户名需要服务端校验,用户在
500ms内连续修改多次,你会怎样实现并保证回调拿到正确的参数和this?返回的包装函数应保存定时器,并在每次调用时执行
clearTimeout后重新设置setTimeout。回调触发时用func.apply(this, args)传递本次调用的上下文和最后一组参数;若调用环境依赖动态this,不能把包装函数随意改成箭头函数。产品把搜索联想从“停止输入后请求”改成“拖动过程中持续更新位置”,原来的防抖为什么会让页面显得卡顿?
防抖会持续推迟回调,拖动未停止时通常看不到位置更新,因此视觉上像卡住。此时应改用节流,让
mousemove在固定时间间隔内有节奏地执行;频率过高会增加计算压力,间隔过大又会降低跟手性。线上反馈搜索框停顿后偶尔执行两次请求,你检查代码时发现每次渲染都重新调用
debounce创建函数,故障原因是什么?每次创建都会产生独立的定时器闭包,旧包装函数的定时器无法被新包装函数清除,所以多个回调可能先后执行。应让同一交互周期复用同一个防抖函数,并检查事件监听是否重复绑定;仅在回调内部去重会掩盖生命周期问题。
提交按钮要求防止短时间重复提交,但业务又要求第一次点击立即反馈,直接使用仅尾部执行的简化防抖有什么冲突?
简化防抖只在最后一次触发后的
wait到期时执行,会延迟首次提交反馈,与立即响应的要求冲突。需要重新确认是禁用按钮、首次立即执行还是尾部合并;若仍采用尾部防抖,必须接受操作反馈延迟,且不能替代服务端幂等保护。
# 2 实现节流函数(throttle)
⚡ 30 秒速记
- 节流保证一段时间内最多执行一次,不会因为持续触发而无限延期
- 时间戳版偏向立即响应,定时器版容易保留最后一次调用,完整版要组合两者
- 实现时同样要透传
this与参数,并处理尾调用和取消 - 典型场景是滚动位置采样、拖拽和高频上报
节流函数会把高频触发限制为每隔一段时间最多执行一次。 时间戳方案首次触发会立即执行,但停止触发时不会补上最后一次;定时器方案首次需要等待,却能在停止后再执行一次。实现时要用 apply 透传调用时的 this 和参数。拖拽、resize、scroll 等持续触发的场景更适合节流,因为相比防抖,它能按固定节奏更新。
节流函数原理:指频繁触发事件时,只会在指定的时间段内执行事件回调,即触发事件间隔大于等于指定的时间才会执行回调函数。总结起来就是:事件,按照一段时间的间隔来进行触发。


像dom的拖拽,如果用消抖的话,就会出现卡顿的感觉,因为只在停止的时候执行了一次,这个时候就应该用节流,在一定时间内多次执行,会流畅很多
手写简版
使用时间戳的节流函数会在第一次触发事件时立即执行,以后每过 wait 秒之后才执行一次,并且最后一次触发事件不会被执行
时间戳方式:
// func是用户传入需要防抖的函数
// wait是等待时间
const throttle = (func, wait = 50) => {
  // 上一次执行该函数的时间
  let lastTime = 0
  return function(...args) {
    // 当前时间
    let now = +new Date()
    // 将当前时间和上一次执行函数时间对比
    // 如果差值大于设置的等待时间就执行函数
    if (now - lastTime > wait) {
      lastTime = now
      func.apply(this, args)
    }
  }
}

setInterval(
  throttle(() => {
    console.log(1)
  }, 500),
  1
)
定时器方式:
使用定时器的节流函数在第一次触发时不会执行,而是在 delay 秒之后才执行,当最后一次停止触发后,还会再执行一次函数
function throttle(func, delay){
  var timer = 0;
  return function(){
    var context = this;
    var args = arguments;
    if(timer) return // 当前有任务了,直接返回
    timer = setTimeout(function(){
      func.apply(context, args);
      timer = 0;
    },delay);
  }
}
适用场景:
- 拖拽场景:固定时间内只执行一次,防止超高频次触发位置变动。
DOM元素的拖拽功能实现(mousemove) - 缩放场景:监控浏览器
resize - 滚动场景:监听滚动
scroll事件判断是否到页面底部自动加载更多 - 动画场景:避免短时间内多次触发动画引起性能问题
总结
- 函数防抖:
限制执行次数,多次密集的触发只执行一次- 将几次操作合并为一次操作进行。原理是维护一个计时器,规定在
delay时间后触发函数,但是在delay时间内再次触发的话,就会取消之前的计时器而重新设置。这样一来,只有最后一次操作能被触发。
- 将几次操作合并为一次操作进行。原理是维护一个计时器,规定在
- 函数节流:
限制执行的频率,按照一定的时间间隔有节奏的执行- 使得一定时间内只触发一次函数。原理是通过判断是否到达一定时间来触发函数。
💬 面试官追问
页面监听
scroll判断是否触底,用户持续滚动十几秒;如果改成防抖,为什么可能直到停止滚动才加载下一页?防抖会在每次滚动时重新计时,持续触发期间回调一直被推迟,因此可能错过滚动过程中的及时加载。节流会按固定间隔检查位置,更适合连续滚动;检查间隔仍需结合交互及时性设置,不能保证每个滚动事件都被处理。
拖拽组件的
mousemove每秒触发大量事件,你会怎样用时间戳节流限制更新,并保留调用时的参数与上下文?闭包中记录
lastTime,每次触发比较当前时间与上次执行时间,达到wait后更新lastTime并调用func.apply(this, args)。这种实现首次触发可立即执行,但停止前未达到间隔的最后一次事件会被舍弃,可能丢失最终位置。设计要求拖拽开始时不要立即更新,但松手前的最后一个位置必须落地,时间戳实现还能直接使用吗?
时间戳方案首次会立即执行且不会补做最后一次,与要求相反,应改用定时器节流。定时器方案首次触发后延迟执行,停止触发后已安排的任务仍会运行;代价是首次反馈变慢,并且要确保同一时段只保留一个任务。
线上动画偶尔连续触发,排查发现定时器节流的回调抛错后
timer一直不是0,后续事件全部失效,你会怎么定位?先确认异常是否发生在
func.apply,因为异常会中断后续的timer = 0,让包装函数永久命中提前返回。应保证定时器状态能够在回调结束或异常路径中复位,同时保留错误上报;只吞掉异常虽然恢复触发,却会隐藏动画本身的故障。同一个
resize监听既要开始缩放时立即计算,又要结束后再校正一次,你会怎样评价源码中的两种简版节流?时间戳版满足首次立即执行,却不会执行停止前的最后一次;定时器版能够延后执行尾部任务,但首次不会立即响应。两者都不能单独完整满足要求,需要组合首部与尾部语义;组合后定时器和参数管理更复杂,也要避免同一时刻重复调用。
# 3 实现instanceOf
⚡ 30 秒速记
- 普通实现从对象原型开始,沿
Object.getPrototypeOf()向上查找构造函数的prototype - 左值是原始类型时直接返回
false,查到null表示链路结束 - 规范实现还要尊重构造函数自定义的
Symbol.hasInstance - 跨窗口对象会有不同的构造函数引用,内建类型判断不要盲信
instanceof
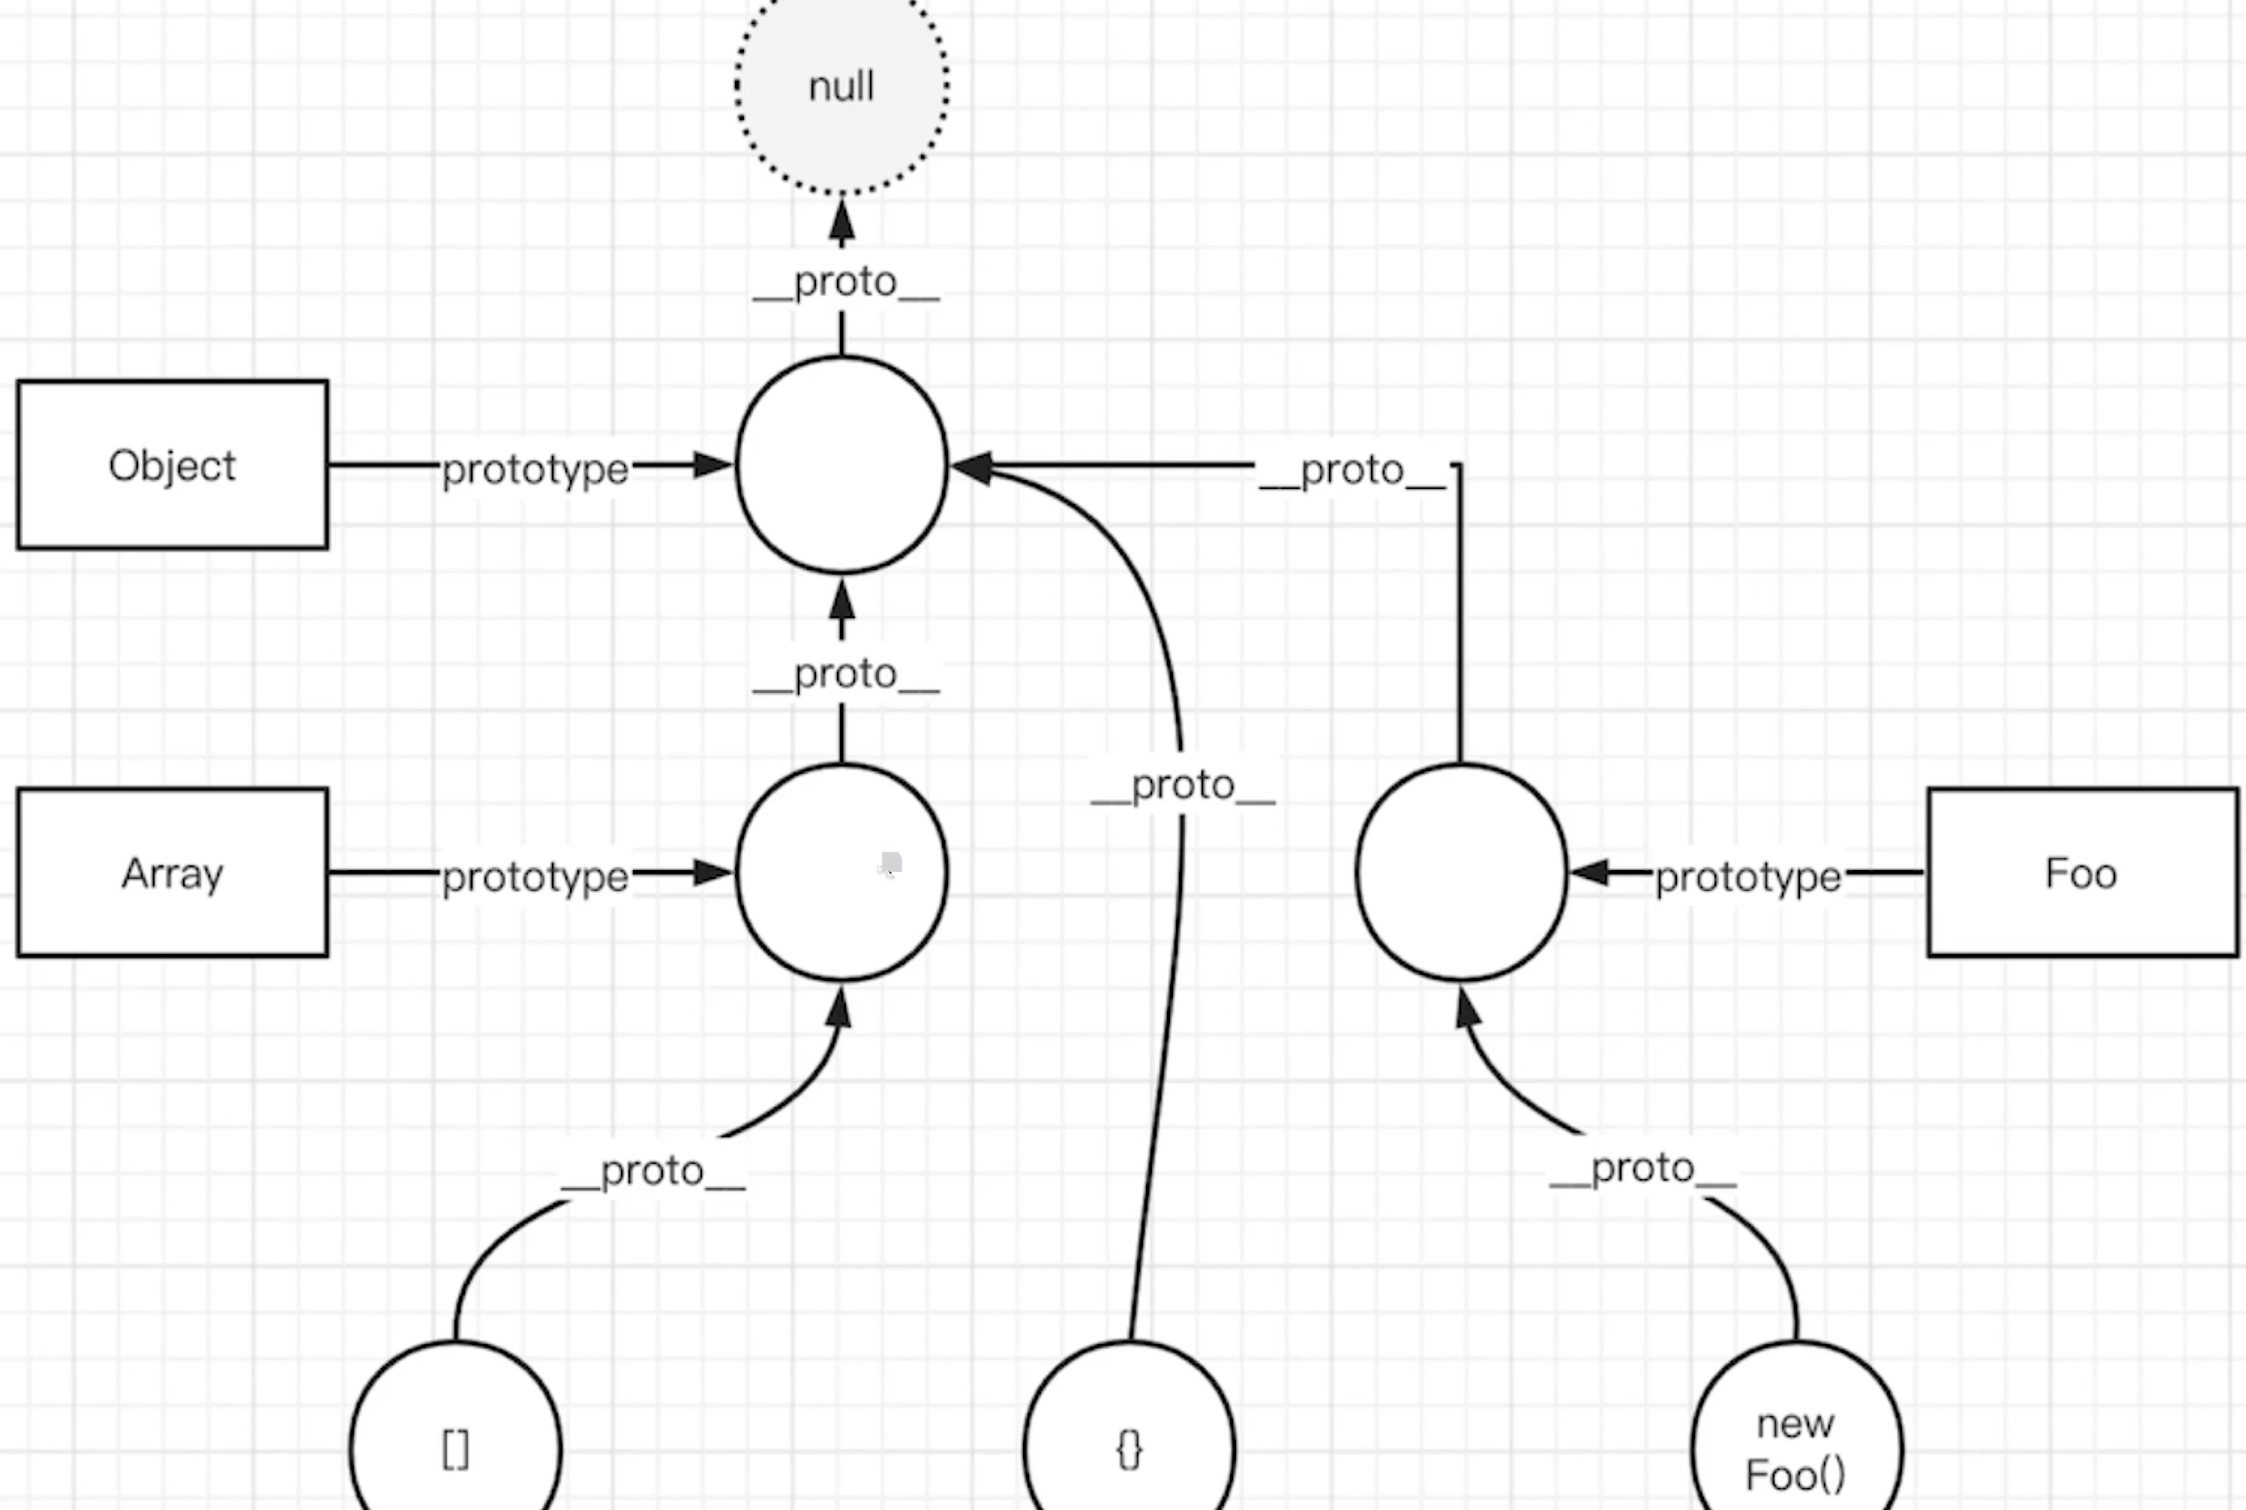
实现 instanceof 的核心,就是沿实例的原型链查找构造函数的 prototype。 先排除 null 和基本数据类型,再通过 Object.getPrototypeOf() 取得并逐层更新原型。只要某一层与 classOrFunc.prototype 相等就返回 true,一直查到 null 仍未命中则返回 false。这里不要直接依赖非标准的 __proto__,使用标准 API 会更稳妥。
思路:
- 步骤1:先取得当前类的原型,当前实例对象的原型链
- 步骤2:一直循环(执行原型链的查找机制)
- 取得当前实例对象原型链的原型链(
proto = proto.__proto__,沿着原型链一直向上查找) - 如果 当前实例的原型链
__proto__上找到了当前类的原型prototype,则返回true - 如果 一直找到
Object.prototype.__proto__ == null,Object的基类(null)上面都没找到,则返回false
- 取得当前实例对象原型链的原型链(
// 实例.__ptoto__ === 构造函数.prototype
function _instanceof(instance, classOrFunc) {
    // 由于instance要检测的是某对象,需要有一个前置判断条件
    //基本数据类型直接返回false
    if(typeof instance !== 'object' || instance == null) return false;

    let proto = Object.getPrototypeOf(instance); // 等价于 instance.__ptoto__
    while(proto) { // 当proto == null时,说明已经找到了Object的基类null 退出循环
        // 实例的原型等于当前构造函数的原型
        if(proto == classOrFunc.prototype) return true;
        // 沿着原型链__ptoto__一层一层向上查
        proto = Object.getPrototypeof(proto); // 等价于 proto.__ptoto__
    }

    return false
}

console.log('test', _instanceof(null, Array)) // false
console.log('test', _instanceof([], Array)) // true
console.log('test', _instanceof('', Array)) // false
console.log('test', _instanceof({}, Object)) // true
💬 面试官追问
控制台执行
_instanceof([], Array)得到true,但_instanceof('', Array)得到false,你的实现依据是什么?实现检查的是左侧对象的原型链中是否出现右侧构造函数的
prototype。数组对象从Object.getPrototypeOf(instance)开始可以找到Array.prototype,而字符串基本类型会被前置类型判断直接排除;这不是按变量内容或名称判断类型。组件库需要判断传入对象是否由某个构造函数创建,你会怎样沿原型链实现,为什么不直接读取多层
__proto__?先用
Object.getPrototypeOf(instance)取得当前原型,再循环向上查找并与classOrFunc.prototype比较。找到即返回true,走到null返回false;使用标准API能清楚表达原型链遍历,但手写版本仍需先限制输入范围。业务把待检测值从普通对象扩展到
null、数字和字符串,原型链循环前必须增加什么约束?在遍历前应判断左侧值是否为非空对象,
null和基本数据类型直接返回false。否则对null调用Object.getPrototypeOf会抛错,基本类型也偏离该简化实现的检测范围;边界判断必须放在任何原型读取之前。线上工具函数对所有对象都返回
false,代码里写成了Object.getPrototypeof(proto),你会怎样排查这个现象?先检查方法名大小写,标准调用应为
Object.getPrototypeOf(proto),源码示例中的getPrototypeof会导致运行时找不到函数。修正后再用数组、普通对象、null和基本类型做对照;若仍异常,就记录每轮proto验证链路是否正确推进。候选人提出用
instance.__proto__循环,另一位坚持用Object.getPrototypeOf,在这道手写题里你更认可哪种实现?两者都在表达沿原型链向上查找,但更适合使用
Object.getPrototypeOf,避免直接依赖__proto__写法。核心判断仍是某一层原型是否等于构造函数的prototype;无论选哪种,都必须保证最终在null处终止循环。
# 4 实现new的过程
⚡ 30 秒速记
- 创建一个以构造函数
prototype为原型的新对象 - 用新对象作为
this调用构造函数,并传入参数 - 构造函数显式返回对象或函数时采用该返回值,否则返回刚创建的对象
- 完整实现要拒绝不可构造的目标,不能把箭头函数当构造函数
模拟 new,本质上是创建对象、连接原型、执行构造函数并处理返回值。 可以用 Object.create(constructor.prototype) 建立新对象,再通过 constructor.apply(newObj, args) 让构造函数里的 this 指向它。构造函数返回对象时采用该返回值,否则返回刚创建的 newObj。因此一旦显式返回引用类型对象,实例就不再是原来那个新对象,也无法通过它访问构造函数原型上的方法。
new操作符做了这些事:
- 创建一个全新的对象
obj,继承构造函数的原型:这个对象的__proto__要指向构造函数的原型prototype - 执行构造函数,使用
call/apply改变this的指向(将obj作为this) - 返回值为
object类型则作为new方法的返回值返回,否则返回上述全新对象obj
function myNew(constructor, ...args) {
  // 1. 基于原型链 创建一个新对象,继承构造函数constructor的原型对象(Person.prototype)上的属性
  let newObj = Object.create(constructor.prototype);
  // 添加属性到新对象上 并获取obj函数的结果
  // 调用构造函数,将this调换为新对象,通过强行赋值的方式为新对象添加属性
  // 2. 将newObj作为this,执行 constructor ,传入参数
  let res = constructor.apply(newObj, args); // 改变this指向新创建的对象

  // 3. 如果函数的执行结果有返回值并且是一个对象, 返回执行的结果, 否则, 返回新创建的对象地址
  return typeof res === 'object' ? res: newObj;
}
// 用法
function Person(name, age) {
  this.name = name;
  this.age = age;

 // 如果构造函数内部,return 一个引用类型的对象,则整个构造函数失效,而是返回这个引用类型的对象,而不是返回this
  // 在实例中就没法获取Person原型上的getName方法
}
Person.prototype.say = function() {
  console.log(this.age);
};
let p1 = myNew(Person, "poety", 18);
console.log(p1.name);
console.log(p1);
p1.say();
💬 面试官追问
构造函数
Person给this写入name,但显式返回一个普通对象后,新实例拿不到Person.prototype.say,为什么?new会先创建继承Person.prototype的对象并以它作为this执行构造函数,但显式返回引用类型时最终结果会被该返回值替换。返回的普通对象若没有相同原型链,自然访问不到say;返回基本类型则仍使用新建对象。你要在工具库中实现
myNew(Person, 'poety', 18),创建对象、绑定this和处理返回值分别怎么落到代码里?先用
Object.create(constructor.prototype)创建继承构造函数原型的新对象,再通过constructor.apply(newObj, args)执行构造函数。若执行结果是应被采用的引用类型就返回它,否则返回newObj;这样实例属性和原型方法才能按预期组合。构造函数从传统
function改成没有可用prototype的调用形式,而调用方仍传给myNew,你会先加什么约束?应先确认传入值确实适合作为构造函数,并且能为
Object.create提供有效原型,再进入创建和调用流程。源码的简化实现默认这些条件成立,缺少校验时可能在创建对象或调用阶段抛错;不能把任意函数形式都视为可构造。线上发现构造函数执行后返回
null,myNew最终也返回了null,你检查到代码只写了typeof res === 'object',问题在哪里?typeof null也会得到object,因此该判断会错误地把null当作需要替换新对象的返回值。返回条件至少要排除null,否则会丢失已经创建并初始化的实例;修复后应分别覆盖未返回、返回基本类型、普通对象和null。团队有人建议所有实例都用
Object.create加apply替代原生new,这套手写实现更适合承担什么角色?它适合解释
new的三个核心步骤:连接构造函数原型、以新对象绑定this执行,以及按返回值决定最终结果。工程代码仍应优先使用原生new,因为简化实现依赖多项输入假设;自行维护会增加边界校验和行为一致性的成本。
# 5 实现call方法
⚡ 30 秒速记
- 实现
call的关键,是让目标函数临时成为指定对象的方法并立即调用。 - 因为通过
context.fn()执行时,函数内部的this会自然指向context,所以可以用Symbol作为临时属性名,避免覆盖已有属性。 - 调用时展开传入参数并保存返回值,随后删除临时属性,防止污染对象。
- 未传上下文时默认使用
window,值类型上下文则先用Object包装。
实现 call 的关键,是让目标函数临时成为指定对象的方法并立即调用。 因为通过 context.fn() 执行时,函数内部的 this 会自然指向 context,所以可以用 Symbol 作为临时属性名,避免覆盖已有属性。调用时展开传入参数并保存返回值,随后删除临时属性,防止污染对象。未传上下文时默认使用 window,值类型上下文则先用 Object 包装。
call做了什么:
- 将函数设为对象的属性
- 执行和删除这个函数
- 指定
this到函数并传入给定参数执行函数 - 如果不传入参数,默认指向
window
分析:如何在函数执行时绑定this
- 如
var obj = {x:100,fn() { this.x }} - 执行
obj.fn(),此时fn内部的this就指向了obj - 可借此来实现函数绑定
this
原生
call、apply传入的this如果是值类型,会被new Object(如fn.call('abc'))
//实现call方法

// 相当于在obj上调用fn方法,this指向obj
// var obj = {fn: function(){console.log(this)}}
// obj.fn() fn内部的this指向obj
// call就是模拟了这个过程
// context 相当于obj

Function.prototype.myCall = function(context = window, ...args) {
  if (typeof context !== 'object') context = new Object(context) // 值类型,变为对象

  // args 传递过来的参数
  // this 表示调用call的函数fn
  // context 是call传入的this

  // 在context上加一个唯一值,不会出现属性名称的覆盖
  let fnKey = Symbol()
  // 相等于 obj[fnKey] = fn
  context[fnKey] = this; // this 就是当前的函数

  // 绑定了this
  let result = context[fnKey](...args);// 相当于 obj.fn()执行 fn内部this指向context(obj)

  // 清理掉 fn ,防止污染(即清掉obj上的fnKey属性)
  delete context[fnKey];

  // 返回结果
  return result;
};
//用法:f.call(this,arg1)

function f(a,b){
 console.log(a+b)
 console.log(this.name)
}
let obj={
 name:1
}
f.myCall(obj,1,2) // 不传obj,this指向window
💬 面试官追问
商品详情页执行
getPrice.myCall('vip', skuId)时,this为什么不是原始字符串,页面代码若依赖this.length又会出现什么语义差异?值类型上下文会先被包装成对象,因此函数内的
this是字符串包装对象,但仍可读取length。若业务依赖严格相等、原始类型判断或对象身份,包装会改变判断结果;手写实现应明确这种转换只是在模拟原生call的上下文语义。埋点
SDK用myCall调用回调,回调抛异常后宿主对象残留一个Symbol属性;你会怎样修改这段实现?执行和清理应放进
try...finally,在try中调用临时方法并返回结果,在finally中删除context[fnKey]。这样异常仍按原路径传播,同时避免污染宿主对象;但对象不可扩展或属性写入受限时,这种模拟方案仍可能失败。服务端渲染页面复用这段
context = window的实现,运行到Node.js环境直接报错,你会如何处理默认上下文?不能把默认值直接写成只在浏览器存在的
window,应显式处理null、undefined,并依据运行环境选择全局对象,例如globalThis。默认上下文还受严格模式语义影响,因此手写版本必须声明模拟范围,不能承诺与原生行为完全一致。一个被冻结的权限对象传给
check.myCall(authContext)后,在写入context[fnKey]时失败;是继续修补临时属性方案,还是换实现?冻结或不可扩展对象无法可靠挂载临时函数,
Symbol只能避免重名,不能绕过写入限制。工程代码应直接使用原生Function.prototype.call;若面试要求手写,则说明该实现用于展示“方法调用决定this”的原理,并把不可扩展对象列为边界。代码评审中有人把
Symbol换成固定属性名__fn__,理由是调用结束后会删除;当页面对象原本就有同名字段时会发生什么?固定属性名会覆盖对象已有的
__fn__,调用后再删除还会把原属性一并丢失,造成难以定位的数据破坏。使用独立Symbol可规避常规键冲突,但仍需保证异常时清理,并注意代理对象可能拦截赋值、读取或删除操作。
# 6 实现apply方法
⚡ 30 秒速记
- 实现
apply的关键,是把待执行函数临时挂到目标对象上,再以对象方法的形式调用,从而改变this。 - 参数通过数组展开传入,这也是它和
call在传参方式上的主要区别。 - 目标是基本类型时要先包装成对象,并用
Symbol作为临时属性名,避免覆盖已有属性。 - 函数执行后删除临时属性并返回结果,防止污染原对象。
实现 apply 的关键,是把待执行函数临时挂到目标对象上,再以对象方法的形式调用,从而改变 this。 参数通过数组展开传入,这也是它和 call 在传参方式上的主要区别。目标是基本类型时要先包装成对象,并用 Symbol 作为临时属性名,避免覆盖已有属性。函数执行后删除临时属性并返回结果,防止污染原对象。
思路: 利用
this的上下文特性。apply其实就是改一下参数的问题
Function.prototype.myApply = function(context = window, args) {  // 这里传参和call传参不一样
  if (typeof context !== 'object') context = new Object(context) // 值类型,变为对象

  // args 传递过来的参数
  // this 表示调用call的函数
  // context 是apply传入的this

  // 在context上加一个唯一值,不会出现属性名称的覆盖
  let fnKey = Symbol()
  context[fnKey] = this; // this 就是当前的函数

  // 绑定了this
  let result = context[fnKey](...args);

  // 清理掉 fn ,防止污染
  delete context[fnKey];

  // 返回结果
  return result;
}
// 使用
function f(a,b){
 console.log(a,b)
 console.log(this.name)
}
let obj={
 name:'张三'
}
f.myApply(obj,[1,2])
💬 面试官追问
图表页调用
render.myApply(chart, [width, height])正常,但把第二个参数改成单个数字后在展开处报错;你会如何解释apply与call的参数差异?apply接收一组待展开的参数,而call接收逐个列出的参数,所以数字不能直接被...args展开。手写实现应校验或规范化参数容器;若允许缺省,还要单独处理args为undefined,否则主函数尚未执行就会报错。支付页通过
handler.myApply(order, params)调用回调,回调抛错后订单对象一直带着临时Symbol;故障修复应落在哪里?临时属性的删除必须由
finally保证,不能只写在正常返回路径之后。回调异常应继续向上传播,不能为了清理而吞掉;同时要保留原返回值语义,避免修复污染后又改变调用方的错误处理流程。同一套工具代码既跑浏览器主线程又跑
SSR,myApply()未传上下文时引用window失败;你会怎样收紧实现约束?默认上下文应避免绑定浏览器专有的
window,可使用环境通用的globalThis,并显式区分未传值与传入值类型。由于严格模式下原生上下文处理还有差异,面试实现应写清覆盖范围,生产环境则优先调用标准apply。风控对象通过
Object.preventExtensions禁止新增属性后,rule.myApply(context, args)无法工作;Symbol为什么没有解决这里的冲突?Symbol只保证临时键不容易与现有属性重名,并不赋予对象新增属性的能力。不可扩展、冻结或代理对象都可能使赋值失败,因此临时挂载方案存在结构性限制;线上代码没有理由替代原生apply。批处理模块拿到参数数组后,有人提议把
myApply改成myCall(context, ...args);这两种写法在职责和风险上如何取舍?若已有可靠的
myCall,展开参数后复用它能减少两套临时属性与清理逻辑,但仍要处理参数不可迭代和大参数集合的风险。面试中分别实现更能展示传参差异;工程中应直接使用原生API,避免维护重复模拟层。
# 7 实现bind方法
⚡ 30 秒速记
- 实现
bind要返回一个新函数,同时处理预置参数、普通调用和构造调用。 - 普通调用时,用
apply绑定传入的context,并把绑定时和执行时的参数合并。 - 通过
new调用时,this应指向新实例,因此要忽略原先绑定的对象。 - 还要用
Object.create关联原函数的原型,避免构造函数原型上的属性和方法丢失。
实现 bind 要返回一个新函数,同时处理预置参数、普通调用和构造调用。 普通调用时,用 apply 绑定传入的 context,并把绑定时和执行时的参数合并。通过 new 调用时,this 应指向新实例,因此要忽略原先绑定的对象。还要用 Object.create 关联原函数的原型,避免构造函数原型上的属性和方法丢失。
bind的实现对比其他两个函数略微地复杂了一点,涉及到参数合并(类似函数柯里化),因为bind需要返回一个函数,需要判断一些边界问题,以下是bind的实现
bind返回了一个函数,对于函数来说有两种方式调用,一种是直接调用,一种是通过new的方式,我们先来说直接调用的方式- 对于直接调用来说,这里选择了
apply的方式实现,但是对于参数需要注意以下情况:因为bind可以实现类似这样的代码f.bind(obj, 1)(2),所以我们需要将两边的参数拼接起来 - 最后来说通过
new的方式,对于new的情况来说,不会被任何方式改变this,所以对于这种情况我们需要忽略传入的this - 箭头函数的底层是
bind,无法改变this,只能改变参数
简洁版本
- 对于普通函数,绑定
this指向 - 对于构造函数,要保证原函数的原型对象上的属性不能丢失
Function.prototype.myBind = function(context = window, ...args) {
  // context 是 bind 传入的 this
  // args 是 bind 传入的各个参数
  // this表示调用bind的函数
  let self = this; // fn.bind(obj) self就是fn

  //返回了一个函数,...innerArgs为实际调用时传入的参数
  let fBound = function(...innerArgs) {
      //this instanceof fBound为true表示构造函数的情况。如new func.bind(obj)
      // 当作为构造函数时,this 指向实例,此时 this instanceof fBound 结果为 true,可以让实例获得来自绑定函数的值
      // 当作为普通函数时,this 默认指向 window,此时结果为 false,将绑定函数的 this 指向 context
      return self.apply( // 函数执行
        this instanceof fBound ? this : context,
        args.concat(innerArgs) // 拼接参数
      );
  }

  // 如果绑定的是构造函数,那么需要继承构造函数原型属性和方法:保证原函数的原型对象上的属性不丢失
  // 实现继承的方式: 使用Object.create
  fBound.prototype = Object.create(this.prototype);
  return fBound;
}
// 测试用例

function Person(name, age) {
  console.log('Person name:', name);
  console.log('Person age:', age);
  console.log('Person this:', this); // 构造函数this指向实例对象
}

// 构造函数原型的方法
Person.prototype.say = function() {
  console.log('person say');
}

// 普通函数
function normalFun(name, age) {
  console.log('普通函数 name:', name);
  console.log('普通函数 age:', age);
  console.log('普通函数 this:', this);  // 普通函数this指向绑定bind的第一个参数 也就是例子中的obj
}


var obj = {
  name: 'poetries',
  age: 18
}

// 先测试作为构造函数调用
var bindFun = Person.myBind(obj, 'poetry1') // undefined
var a = new bindFun(10) // Person name: poetry1、Person age: 10、Person this: fBound {}
a.say() // person say

// 再测试作为普通函数调用
var bindNormalFun = normalFun.myBind(obj, 'poetry2') // undefined
bindNormalFun(12)
// 普通函数name: poetry2
// 普通函数 age: 12
// 普通函数 this: {name: 'poetries', age: 18}
注意:
bind之后不能再次修改this的指向(箭头函数的底层实现原理依赖bind绑定this后不能再次修改this的特性),bind多次后执行,函数this还是指向第一次bind的对象
💬 面试官追问
列表页先执行
load.bind(user, 1),组件层又对返回函数调用.bind(admin, 2),最终执行时this和参数分别应怎样理解?第一次绑定确定的
this不会被第二次bind改成admin,后续绑定主要继续预置参数。实际调用时参数按各次预置值和调用参数依次合并;若业务希望动态切换上下文,就不应提前生成绑定函数。事件系统注册
button.addEventListener('click', view.onClick.bind(view)),卸载时再次写同样表达式却移除失败;你会怎样落地管理?每次
bind都会返回新的函数对象,卸载阶段重新绑定得到的引用与注册时不同。应把绑定结果保存到实例字段,并用同一引用完成注册和移除;代价是增加生命周期管理,遗漏清理仍可能造成监听器滞留。依赖注入容器把
Person.myBind(config, 'Alice')当构造器再执行new,为什么实例的this不能指向config?通过
new调用时,构造过程创建的实例应成为this,所以实现借助this instanceof fBound忽略已绑定的上下文。预置参数仍需与构造时参数合并,同时通过Object.create连接原函数原型,否则实例会丢失Person.prototype上的方法。监控显示某个绑定后的构造器能创建实例,却在调用原型方法时报
is not a function;你会沿哪条链路排查?先检查是否为
fBound.prototype建立了基于原函数prototype的原型对象,再确认实例确实通过new fBound()创建。若只处理了apply和参数拼接,普通调用会正常而原型方法缺失;绑定目标没有可用原型时也不能套用同一路径。工具库要同时支持普通函数、构造函数和箭头函数,有人主张统一按
fBound.prototype = Object.create(this.prototype)处理;冲突在哪里?普通可构造函数需要保留原型链,但箭头函数没有普通构造函数的
prototype,也不能因绑定而获得构造能力。实现应先限制目标类型或对原型存在性做判断;强行统一会在创建原型时失败,并掩盖箭头函数的词法this特性。搜索框把固定查询条件预置为
search.bind(store, tenantId),另一位同事建议每次调用都写search.call(store, tenantId, keyword);你如何选?需要长期复用同一上下文和前置参数时,
bind生成的稳定函数更适合回调注册与传递;只调用一次时,call更直接,也少创建一个包装函数。若上下文可能变化,提前绑定会失去灵活性,且再次绑定也不能覆盖第一次的this。
# 8 实现深拷贝
⚡ 30 秒速记
- 先确认需求边界:普通对象数组、循环引用、原型、属性描述符和内建对象是否都要保留
- 用
WeakMap记录“源对象 → 副本”解决循环引用,也避免重复拷贝同一对象 Date、RegExp、Map、Set、ArrayBuffer等要分类处理- 生产代码优先评估
structuredClone,手写题重点是展示边界意识而非堆分支
实现深拷贝前要先明确范围,因为普通对象、循环引用和特殊内建对象的处理方式并不一样。 核心做法是递归复制引用类型,并用 WeakMap 保存源对象和副本的关系,遇到循环引用或重复引用时直接复用副本。像 Date、RegExp、Map、Set 和 ArrayBuffer 需要分类处理;生产场景也可以先评估 structuredClone 是否满足需求。
# 1 简洁版本
⚡ 30 秒速记
- 简洁的深拷贝可以用递归实现:值类型和
null直接返回,对象或数组则逐项复制。 - 遍历时只处理对象自身的属性,属性值仍是引用类型就继续递归。
JSON.parse(JSON.stringify(obj))写法更短,但无法正确克隆函数、RegExp等特殊对象,还会丢失原构造函数信息,并在循环引用时抛错。- 进阶实现可用
WeakMap记录已复制对象,并单独处理Date和RegExp。
简洁的深拷贝可以用递归实现:值类型和 null 直接返回,对象或数组则逐项复制。 遍历时只处理对象自身的属性,属性值仍是引用类型就继续递归。JSON.parse(JSON.stringify(obj)) 写法更短,但无法正确克隆函数、RegExp 等特殊对象,还会丢失原构造函数信息,并在循环引用时抛错。进阶实现可用 WeakMap 记录已复制对象,并单独处理 Date 和 RegExp。
简单版:
const newObj = JSON.parse(JSON.stringify(oldObj));
局限性:
- 他无法实现对函数 、RegExp等特殊对象的克隆
- 会抛弃对象的
constructor,所有的构造函数会指向Object - 对象有循环引用,会报错
面试简版
function deepClone(obj) {
  // 如果是 值类型 或 null,则直接return
  if(typeof obj !== 'object' || obj === null) {
    return obj
  }

  // 定义结果对象
  let copy = {}

  // 如果对象是数组,则定义结果数组
  if(obj instanceof Array) {
    copy = []
  }

  // 遍历对象的key
  for(let key in obj) {
      // 如果key是对象的自有属性
      if(obj.hasOwnProperty(key)) {
        // 递归调用深拷贝方法
        copy[key] = deepClone(obj[key])
      }
  }

  return copy
}
调用深拷贝方法,若属性为值类型,则直接返回;若属性为引用类型,则递归遍历。这就是我们在解这一类题时的核心的方法。
进阶版
- 解决拷贝循环引用问题
- 解决拷贝对应原型问题
// 递归拷贝 (类型判断)
function deepClone(value,hash = new WeakMap){ // 弱引用,不用map,weakMap更合适一点
  // null 和 undefiend 是不需要拷贝的
  if(value == null){ return value;}
  if(value instanceof RegExp) { return new RegExp(value) }
  if(value instanceof Date) { return new Date(value) }
  // 函数是不需要拷贝
  if(typeof value != 'object') return value;
  let obj = new value.constructor(); // [] {}
  // 说明是一个对象类型
  if(hash.get(value)){
    return hash.get(value)
  }
  hash.set(value,obj);
  for(let key in value){ // in 会遍历当前对象上的属性 和 __proto__指代的属性
    // 补拷贝 对象的__proto__上的属性
    if(value.hasOwnProperty(key)){
      // 如果值还有可能是对象 就继续拷贝
      obj[key] = deepClone(value[key],hash);
    }
  }
  return obj
  // 区分对象和数组 Object.prototype.toString.call
}
// test

var o = {};
o.x = o;
var o1 = deepClone(o); // 如果这个对象拷贝过了 就返回那个拷贝的结果就可以了
console.log(o1);
💬 面试官追问
表单草稿含
Date、RegExp和校验函数,页面用JSON.parse(JSON.stringify(draft))复制后,哪些字段会失真或消失?这种方式不能正确克隆函数、
RegExp等特殊对象,并会丢失原构造关系,使结果趋向普通对象。它只适合明确由JSON可表示的数据;若草稿结构没有经过约束,复制成功也不代表语义仍然完整。组织架构树约有数万节点且某个节点通过
parent回指祖先,递归版deepClone上线后栈溢出;你会先改哪部分?先用
WeakMap记录源对象到克隆对象的映射,并在递归子属性前写入映射,遇到同一引用时返回对应克隆。仅记录“访问过”却返回源对象会破坏深拷贝;极深层级还可能触及调用栈边界,需要另行评估遍历方式。状态模块只保存普通对象和数组,有人要求直接上支持原型与循环引用的进阶版;你会接受这项复杂度吗?
若输入契约能保证只有无环的普通对象和数组,简版递归更容易审查和维护,不必为不存在的类型扩展复杂分支。契约一旦允许共享引用、循环结构、
Date或RegExp,就应升级实现并补对应测试,不能靠调用方自行避坑。克隆一个自定义
Model后,数据字段都在,但clone.save()不存在;从copy = {}这行如何定位原因?copy = {}只创建普通对象,没有继承Model.prototype,所以实例方法不会出现在克隆结果上。需要按源对象的构造或原型创建目标,再递归复制自有属性;但直接调用未知构造函数可能需要参数或产生副作用,不能无条件执行。评论缓存中两个字段原本指向同一个用户对象,简版递归克隆后变成两个独立对象;这算不算正确的深拷贝?
若目标是保留原对象图的引用关系,这个结果不正确,因为共享引用被拆成了两份。使用从源对象到目标对象的
WeakMap,不仅能处理环,也能让重复出现的同一源引用复用同一克隆;代价是实现和测试复杂度增加。
# 2 实现完整的深拷贝
⚡ 30 秒速记
- 完整的深拷贝需要递归处理普通对象,并额外兼顾循环引用、特殊对象和函数。
JSON.parse(JSON.stringify())虽然省事,但遇到循环引用会栈溢出,也无法正确复制Map、Set、Date、RegExp和函数。- 实现时可用
WeakMap记录访问过的对象,既终止重复递归,也避免键与对象形成强引用。 - 其他类型再通过
Object.prototype.toString分类处理,普通函数可重建,箭头函数则直接返回原引用。
完整的深拷贝需要递归处理普通对象,并额外兼顾循环引用、特殊对象和函数。 JSON.parse(JSON.stringify()) 虽然省事,但遇到循环引用会栈溢出,也无法正确复制 Map、Set、Date、RegExp 和函数。实现时可用 WeakMap 记录访问过的对象,既终止重复递归,也避免键与对象形成强引用。其他类型再通过 Object.prototype.toString 分类处理,普通函数可重建,箭头函数则直接返回原引用。
1. 简易版及问题
JSON.parse(JSON.stringify());
估计这个api能覆盖大多数的应用场景,没错,谈到深拷贝,我第一个想到的也是它。但是实际上,对于某些严格的场景来说,这个方法是有巨大的坑的。问题如下:
- 无法解决
循环引用的问题。举个例子:
const a = {val:2};
a.target = a;
拷贝
a会出现系统栈溢出,因为出现了无限递归的情况。
- 无法拷贝一些特殊的对象,诸如
RegExp, Date, Set, Map等 - 无法拷贝
函数(划重点)。
因此这个api先pass掉,我们重新写一个深拷贝,简易版如下:
const deepClone = (target) => {
  if (typeof target === 'object' && target !== null) {
    const cloneTarget = Array.isArray(target) ? []: {};
    for (let prop in target) {
      if (target.hasOwnProperty(prop)) {
          cloneTarget[prop] = deepClone(target[prop]);
      }
    }
    return cloneTarget;
  } else {
    return target;
  }
}
现在,我们以刚刚发现的三个问题为导向,一步步来完善、优化我们的深拷贝代码。
2. 解决循环引用
现在问题如下:
let obj = {val : 100};
obj.target = obj;

deepClone(obj);//报错: RangeError: Maximum call stack size exceeded
这就是循环引用。我们怎么来解决这个问题呢?
创建一个Map。记录下已经拷贝过的对象,如果说已经拷贝过,那直接返回它行了。
const isObject = (target) => (typeof target === 'object' || typeof target === 'function') && target !== null;

const deepClone = (target, map = new Map()) => {
  if(map.get(target))
    return target;


  if (isObject(target)) {
    map.set(target, true);
    const cloneTarget = Array.isArray(target) ? []: {};
    for (let prop in target) {
      if (target.hasOwnProperty(prop)) {
          cloneTarget[prop] = deepClone(target[prop],map);
      }
    }
    return cloneTarget;
  } else {
    return target;
  }
}
现在来试一试:
const a = {val:2};
a.target = a;
let newA = deepClone(a);
console.log(newA)//{ val: 2, target: { val: 2, target: [Circular] } }
好像是没有问题了, 拷贝也完成了。但还是有一个潜在的坑, 就是map 上的 key 和 map 构成了强引用关系,这是相当危险的。我给你解释一下与之相对的弱引用的概念你就明白了
在计算机程序设计中,弱引用与强引用相对,
被弱引用的对象可以在任何时候被回收,而对于强引用来说,只要这个强引用还在,那么对象无法被回收。拿上面的例子说,map 和 a一直是强引用的关系, 在程序结束之前,a 所占的内存空间一直不会被释放。
怎么解决这个问题?
很简单,让 map 的 key 和 map 构成弱引用即可。ES6给我们提供了这样的数据结构,它的名字叫WeakMap,它是一种特殊的Map, 其中的键是弱引用的。其键必须是对象,而值可以是任意的
稍微改造一下即可:
const deepClone = (target, map = new WeakMap()) => {
  //...
}
3. 拷贝特殊对象
可继续遍历
对于特殊的对象,我们使用以下方式来鉴别:
Object.prototype.toString.call(obj);
梳理一下对于可遍历对象会有什么结果:
["object Map"]
["object Set"]
["object Array"]
["object Object"]
["object Arguments"]
以这些不同的字符串为依据,我们就可以成功地鉴别这些对象。
const getType = Object.prototype.toString.call(obj);

const canTraverse = {
  '[object Map]': true,
  '[object Set]': true,
  '[object Array]': true,
  '[object Object]': true,
  '[object Arguments]': true,
};

const deepClone = (target, map = new Map()) => {
  if(!isObject(target))
    return target;
  let type = getType(target);
  let cloneTarget;
  if(!canTraverse[type]) {
    // 处理不能遍历的对象
    return;
  }else {
    // 这波操作相当关键,可以保证对象的原型不丢失!
    let ctor = target.prototype;
    cloneTarget = new ctor();
  }

  if(map.get(target))
    return target;
  map.put(target, true);

  if(type === mapTag) {
    //处理Map
    target.forEach((item, key) => {
      cloneTarget.set(deepClone(key), deepClone(item));
    })
  }

  if(type === setTag) {
    //处理Set
    target.forEach(item => {
      target.add(deepClone(item));
    })
  }

  // 处理数组和对象
  for (let prop in target) {
    if (target.hasOwnProperty(prop)) {
        cloneTarget[prop] = deepClone(target[prop]);
    }
  }
  return cloneTarget;
}
不可遍历的对象
const boolTag = '[object Boolean]';
const numberTag = '[object Number]';
const stringTag = '[object String]';
const dateTag = '[object Date]';
const errorTag = '[object Error]';
const regexpTag = '[object RegExp]';
const funcTag = '[object Function]';
对于不可遍历的对象,不同的对象有不同的处理。
const handleRegExp = (target) => {
  const { source, flags } = target;
  return new target.constructor(source, flags);
}

const handleFunc = (target) => {
  // 待会的重点部分
}

const handleNotTraverse = (target, tag) => {
  const Ctor = targe.constructor;
  switch(tag) {
    case boolTag:
    case numberTag:
    case stringTag:
    case errorTag:
    case dateTag:
      return new Ctor(target);
    case regexpTag:
      return handleRegExp(target);
    case funcTag:
      return handleFunc(target);
    default:
      return new Ctor(target);
  }
}
4. 拷贝函数
- 虽然函数也是对象,但是它过于特殊,我们单独把它拿出来拆解。
- 提到函数,在JS种有两种函数,一种是普通函数,另一种是箭头函数。每个普通函数都是
- Function的实例,而箭头函数不是任何类的实例,每次调用都是不一样的引用。那我们只需要
- 处理普通函数的情况,箭头函数直接返回它本身就好了。
那么如何来区分两者呢?
答案是: 利用原型。箭头函数是不存在原型的。
const handleFunc = (func) => {
  // 箭头函数直接返回自身
  if(!func.prototype) return func;
  const bodyReg = /(?<={)(.|\n)+(?=})/m;
  const paramReg = /(?<=\().+(?=\)\s+{)/;
  const funcString = func.toString();
  // 分别匹配 函数参数 和 函数体
  const param = paramReg.exec(funcString);
  const body = bodyReg.exec(funcString);
  if(!body) return null;
  if (param) {
    const paramArr = param[0].split(',');
    return new Function(...paramArr, body[0]);
  } else {
    return new Function(body[0]);
  }
}
5. 完整代码展示
const getType = obj => Object.prototype.toString.call(obj);

const isObject = (target) => (typeof target === 'object' || typeof target === 'function') && target !== null;

const canTraverse = {
  '[object Map]': true,
  '[object Set]': true,
  '[object Array]': true,
  '[object Object]': true,
  '[object Arguments]': true,
};
const mapTag = '[object Map]';
const setTag = '[object Set]';
const boolTag = '[object Boolean]';
const numberTag = '[object Number]';
const stringTag = '[object String]';
const symbolTag = '[object Symbol]';
const dateTag = '[object Date]';
const errorTag = '[object Error]';
const regexpTag = '[object RegExp]';
const funcTag = '[object Function]';

const handleRegExp = (target) => {
  const { source, flags } = target;
  return new target.constructor(source, flags);
}

const handleFunc = (func) => {
  // 箭头函数直接返回自身
  if(!func.prototype) return func;
  const bodyReg = /(?<={)(.|\n)+(?=})/m;
  const paramReg = /(?<=\().+(?=\)\s+{)/;
  const funcString = func.toString();
  // 分别匹配 函数参数 和 函数体
  const param = paramReg.exec(funcString);
  const body = bodyReg.exec(funcString);
  if(!body) return null;
  if (param) {
    const paramArr = param[0].split(',');
    return new Function(...paramArr, body[0]);
  } else {
    return new Function(body[0]);
  }
}

const handleNotTraverse = (target, tag) => {
  const Ctor = target.constructor;
  switch(tag) {
    case boolTag:
      return new Object(Boolean.prototype.valueOf.call(target));
    case numberTag:
      return new Object(Number.prototype.valueOf.call(target));
    case stringTag:
      return new Object(String.prototype.valueOf.call(target));
    case symbolTag:
      return new Object(Symbol.prototype.valueOf.call(target));
    case errorTag:
    case dateTag:
      return new Ctor(target);
    case regexpTag:
      return handleRegExp(target);
    case funcTag:
      return handleFunc(target);
    default:
      return new Ctor(target);
  }
}

const deepClone = (target, map = new WeakMap()) => {
  if(!isObject(target))
    return target;
  let type = getType(target);
  let cloneTarget;
  if(!canTraverse[type]) {
    // 处理不能遍历的对象
    return handleNotTraverse(target, type);
  }else {
    // 这波操作相当关键,可以保证对象的原型不丢失!
    let ctor = target.constructor;
    cloneTarget = new ctor();
  }

  if(map.get(target))
    return target;
  map.set(target, true);

  if(type === mapTag) {
    //处理Map
    target.forEach((item, key) => {
      cloneTarget.set(deepClone(key, map), deepClone(item, map));
    })
  }

  if(type === setTag) {
    //处理Set
    target.forEach(item => {
      cloneTarget.add(deepClone(item, map));
    })
  }

  // 处理数组和对象
  for (let prop in target) {
    if (target.hasOwnProperty(prop)) {
        cloneTarget[prop] = deepClone(target[prop], map);
    }
  }
  return cloneTarget;
}
💬 面试官追问
缓存对象
a.target = a,当前实现命中map.get(target)后直接返回target;克隆结果为什么仍可能引用原对象?映射表若只保存布尔值,命中时返回源
target,会让克隆对象重新连回原对象,而不是连回对应副本。应先创建cloneTarget,再执行map.set(target, cloneTarget),后续命中直接返回该副本,才能正确还原循环和共享引用。数据同步任务长期复用同一个映射表克隆大量临时对象,评审在
Map与WeakMap之间发生冲突;你会怎样判断?源对象只用于去重和回环定位时,
WeakMap更贴合需求,因为键不会阻止对象被回收,且键本来就是对象。若确实需要枚举、统计或长期读取映射记录,WeakMap不适用;本题的克隆过程通常不需要这些能力。权限配置包含嵌套
Map和Set,克隆后发现原Set被追加了新成员,而副本仍为空;你会检查哪一行?应检查
Set分支是否误写成target.add(deepClone(item)),正确目标应是向cloneTarget添加克隆值。Map的键和值也要递归,并共享同一个映射表,否则内部循环或公共引用仍会被错误拆分。克隆
RegExp后正则模式与标志正确,但依赖当前匹配位置的解析器行为变化;实现还漏了哪个状态?通过
source和flags重建只能恢复正则定义,若调用方依赖有状态匹配,还应考虑复制lastIndex。这属于对象可变运行状态而非模式本身;不需要保留该状态时也应在克隆契约中明确,避免调用方误判。安全评审否决了用
func.toString()配合new Function克隆业务函数,尽管普通示例能运行;这一取舍有什么依据?重新拼接函数体无法可靠保留闭包环境、原型关系和完整语法语义,
new Function还会执行动态生成代码。更保守的策略是把函数视为不可克隆值并保留原引用,或明确拒绝含函数的输入;代价是结果并非所有成员都拥有新身份。对象带有不可枚举字段、
Symbol键和访问器,当前for...in加hasOwnProperty克隆后线上配置缺项;完整实现应如何扩展?for...in主要覆盖可枚举字符串属性,不能完整保留Symbol、不可枚举属性及其描述符。若克隆契约要求这些语义,应读取自有键和属性描述符,再在目标上定义并递归处理数据属性;访问器通常保留函数引用,执行它们可能产生副作用。
# 9 实现类的继承
⚡ 30 秒速记
ES5手写继承优先答寄生组合继承:借用父构造函数复制实例属性,再连接父类原型复用方法Parent.call(this)只能继承实例属性,Object.create(Parent.prototype)才负责原型方法- 不要让子类直接共用父类原型,也不要用
new Parent()建子类原型,前者会相互污染,后者会多执行一次父构造函数 - 连接原型后要把
Child.prototype.constructor修正为Child;现代业务代码直接使用class extends
手写继承时,我会实现寄生组合继承。 子构造函数先用 Parent.call(this) 获得独立的实例属性,再用 Object.create(Parent.prototype) 继承原型方法,最后修正 constructor。这样既避免多个实例共享引用属性,也不会像 new Parent() 那样额外执行父构造函数;实际项目中则优先使用语义更清晰的 class extends。
# 1 实现类的继承-简版
⚡ 30 秒速记
- 简版继承可以使用寄生组合继承:构造函数中通过
Parent.call(this)继承实例属性,再用Object.create(Parent.prototype)继承原型方法。 - 不能直接共用父类原型,否则两边会共享同一个原型对象;也不建议用
new Parent()设置原型,因为父类构造函数会被额外调用。 - 最后要把
Child.prototype.constructor改回Child。 - 在
ES6已普及的场景中,了解这一种相对理想的写法通常就够用了。
简版继承可以使用寄生组合继承:构造函数中通过 Parent.call(this) 继承实例属性,再用 Object.create(Parent.prototype) 继承原型方法。 不能直接共用父类原型,否则两边会共享同一个原型对象;也不建议用 new Parent() 设置原型,因为父类构造函数会被额外调用。最后要把 Child.prototype.constructor 改回 Child。在 ES6 已普及的场景中,了解这一种相对理想的写法通常就够用了。
类的继承在几年前是重点内容,有n种继承方式各有优劣,es6普及后越来越不重要,那么多种写法有点『回字有四样写法』的意思,如果还想深入理解的去看红宝书即可,我们目前只实现一种最理想的继承方式。
// 寄生组合继承
function Parent(name) {
  this.name = name
}
Parent.prototype.say = function() {
  console.log(this.name + ` say`);
}
Parent.prototype.play = function() {
  console.log(this.name + ` play`);
}

function Child(name, parent) {
  // 将父类的构造函数绑定在子类上
  Parent.call(this, parent)
  this.name = name
}

/**
 1. 这一步不用Child.prototype = Parent.prototype的原因是怕共享内存,修改父类原型对象就会影响子类
 2. 不用Child.prototype = new Parent()的原因是会调用2次父类的构造方法(另一次是call),会存在一份多余的父类实例属性
3. Object.create是创建了父类原型的副本,与父类原型完全隔离
*/
Child.prototype = Object.create(Parent.prototype);
Child.prototype.say = function() {
  console.log(this.name + ` say`);
}

// 注意记得把子类的构造指向子类本身
Child.prototype.constructor = Child;
// 测试
var parent = new Parent('parent');
parent.say()

var child = new Child('child');
child.say()
child.play(); // 继承父类的方法
💬 面试官追问
用户中心里
Child.prototype = Parent.prototype后,子类重写say,为什么父类实例的say也变了?两者引用了同一个原型对象,给
Child.prototype.say赋值等于直接修改Parent.prototype.say。应使用Object.create(Parent.prototype)建立独立的子类原型,同时保留到父类原型的委托链;代价是还要显式修复constructor。表单模型有上万次
Child实例化,父构造函数负责写入实例字段,继承代码怎样避免重复执行父构造函数?在
Child内用Parent.call(this, parent)初始化每个实例,再用Object.create(Parent.prototype)连接方法继承。不要执行Child.prototype = new Parent(),否则定义原型时就会额外调用一次父构造函数,并产生一份无用的父类实例属性。组件库要求子类覆盖
say,同时继续复用父类的play,这段寄生组合继承如何满足两个约束?先让
Child.prototype委托到Parent.prototype,再把say定义为子类自己的原型方法,因此查找say时命中子类,查找play时沿原型链命中父类。若直接共享父类原型,覆盖行为就会污染所有父类实例。线上埋点显示
child.play()正常,但调试工具里child.constructor === Parent,你会先查哪一行?先检查替换
Child.prototype后是否执行了Child.prototype.constructor = Child。Object.create(Parent.prototype)生成的新对象会沿原型链取得父类的constructor,不修复虽不妨碍play查找,却会让依赖构造器标识的诊断或分支判断产生误导。老项目准备从手写寄生组合继承迁移到
class extends,评审会上有人坚持保留原实现以便精确控制,你怎么取舍?新代码通常应优先采用语言提供的继承语法,手写版本更适合解释构造函数借用与原型链委托。若旧代码依赖
Parent.call的传参或原型替换时机,迁移前必须用实例字段、方法覆盖和constructor行为做对照;直接改写可能暴露隐含兼容风险。
# 2 ES5实现继承-详细
⚡ 30 秒速记
ES5中更推荐寄生组合继承,也就是Parent.call(this)配合Object.create(Parent.prototype)。- 单独用
call只能拿到父类实例属性,继承不到原型方法;单独使用原型链又会让多个子类实例共享父类中的引用类型属性。 - 把两者直接组合虽然解决了共享问题,却会多执行一次父类构造函数。
- 最终还要将
Child.prototype.constructor指回Child,避免子类实例的构造函数标识错误。
ES5 中更推荐寄生组合继承,也就是 Parent.call(this) 配合 Object.create(Parent.prototype)。 单独用 call 只能拿到父类实例属性,继承不到原型方法;单独使用原型链又会让多个子类实例共享父类中的引用类型属性。把两者直接组合虽然解决了共享问题,却会多执行一次父类构造函数。最终还要将 Child.prototype.constructor 指回 Child,避免子类实例的构造函数标识错误。
第一种方式是借助call实现继承
function Parent1(){
    this.name = 'parent1';
}
function Child1(){
    Parent1.call(this);
    this.type = 'child1'
}
console.log(new Child1);
这样写的时候子类虽然能够拿到父类的属性值,但是问题是父类中一旦存在方法那么子类无法继承。那么引出下面的方法
第二种方式借助原型链实现继承:
  function Parent2() {
    this.name = 'parent2';
    this.play = [1, 2, 3]
  }
  function Child2() {
    this.type = 'child2';
  }
  Child2.prototype = new Parent2();

  console.log(new Child2());
看似没有问题,父类的方法和属性都能够访问,但实际上有一个潜在的不足。举个例子:
  var s1 = new Child2();
  var s2 = new Child2();
  s1.play.push(4);
  console.log(s1.play, s2.play); // [1,2,3,4] [1,2,3,4]
明明我只改变了s1的play属性,为什么s2也跟着变了呢?很简单,因为两个实例使用的是同一个原型对象
第三种方式:将前两种组合:
function Parent3 () {
    this.name = 'parent3';
    this.play = [1, 2, 3];
  }
  function Child3() {
    Parent3.call(this);
    this.type = 'child3';
  }
  Child3.prototype = new Parent3();
  var s3 = new Child3();
  var s4 = new Child3();
  s3.play.push(4);
  console.log(s3.play, s4.play); // [1,2,3,4] [1,2,3]
之前的问题都得以解决。但是这里又徒增了一个新问题,那就是Parent3的构造函数会多执行了一次(
Child3.prototype = new Parent3();)。这是我们不愿看到的。那么如何解决这个问题?
第四种方式: 组合继承的优化1
  function Parent4 () {
    this.name = 'parent4';
    this.play = [1, 2, 3];
  }
  function Child4() {
    Parent4.call(this);
    this.type = 'child4';
  }
  Child4.prototype = Parent4.prototype;
这里让将父类原型对象直接给到子类,父类构造函数只执行一次,而且父类属性和方法均能访问,但是我们来测试一下
  var s3 = new Child4();
  var s4 = new Child4();
  console.log(s3)
子类实例的构造函数是Parent4,显然这是不对的,应该是Child4。
第五种方式(最推荐使用):优化2
  function Parent5 () {
    this.name = 'parent5';
    this.play = [1, 2, 3];
  }
  function Child5() {
    Parent5.call(this);
    this.type = 'child5';
  }
  Child5.prototype = Object.create(Parent5.prototype);
  Child5.prototype.constructor = Child5;
这是最推荐的一种方式,接近完美的继承。
💬 面试官追问
购物车创建了两个
Child2实例,只对s1.play.push(4),为什么s2.play也出现了4?play数组来自Child2.prototype = new Parent2()产生的同一个父类实例,两个子实例都通过原型链读到该数组。可变数据应由Parent2.call(this)写入各自实例;否则任一实例的原地修改都会泄漏到其他实例。批量创建订单模型时既要继承父类方法,又要让每个订单拥有独立数组,
ES5代码应怎样组合?在子构造函数中执行
Parent.call(this),让数组等实例属性按对象初始化;再用Object.create(Parent.prototype)承接父类原型方法。最后恢复Child.prototype.constructor = Child,否则构造器标识会沿原型链落到父类。父构造函数后来加入日志上报,组合继承仍使用
Child.prototype = new Parent(),发布后每次加载模块就多一条上报,原因是什么?定义子类原型时的
new Parent()已执行一次父构造函数,真正创建子实例时Parent.call(this)又执行一次。应改为Object.create(Parent.prototype),只建立原型委托而不运行构造逻辑;若父构造函数有副作用,重复调用的影响会比多一份属性更严重。代码审查中一方提出
Child.prototype = Parent.prototype来省掉一次构造调用,另一方担心继承隔离,你支持哪一方?不能用直接赋值换取这项优化,因为父子构造函数会共享同一个原型对象,子类新增或覆盖方法会同步污染父类。
Object.create(Parent.prototype)同样不会调用父构造函数,却能提供独立的子类原型;额外成本是修复constructor。测试里
new Child4()能访问父类方法,但打印实例时构造器显示为Parent4,怎样区分是方法继承失败还是原型设计错误?先验证方法能否沿原型链访问,再检查
Child4.prototype是否直接指向Parent4.prototype。当前现象说明方法查找可用,但父子原型没有隔离,constructor也指向父类;改用Object.create并恢复构造器,才能同时修正两个问题。面试现场要求比较
call继承、原型链继承和寄生组合继承,你会用哪两个可观察现象快速证明差异?用父类原型方法验证纯
call继承的缺口,再用两个实例共同修改原型上的数组验证纯原型链继承的共享风险。寄生组合继承让构造函数负责独立实例属性、原型链负责共享方法,但实现时仍必须处理原型隔离与constructor。
# 10 实现Promise相关方法
⚡ 30 秒速记
- 组合方法先分清结束条件:
all等全部成功,allSettled等全部结束,race取第一个落定结果 - 输入项统一经
Promise.resolve吸收普通值和thenable,输出结果必须保持原输入顺序 all遇到首个失败立即拒绝,allSettled不短路;空输入时两者都立即以空数组完成- 实现
then、finally或完整Promises/A+时,还要保证状态不可逆、链式返回新实例并正确解析返回值
手写 Promise 方法不能只让示例跑通,还要还原各方法的状态和顺序语义。 resolve 负责吸收普通值与 thenable;all、allSettled 和 race 的区别在等待条件与失败策略,但都不能因完成先后打乱结果顺序。继续实现实例方法时,还要保证状态只能落定一次、链式调用返回新实例,并按 Promises/A+ 规则解析回调返回值。
# 1 实现Promise的resolve
⚡ 30 秒速记
- 实现
Promise.resolve时,要根据参数是Promise、thenable还是普通值分别处理。 - 已经是
Promise的参数可以直接返回;遇到带then函数的对象,新建的Promise要通过then(resolve, reject)跟随它的最终状态。 - 其他值直接交给
resolve,得到一个以该值为成功结果的Promise。
实现 Promise.resolve 时,要根据参数是 Promise、thenable 还是普通值分别处理。 已经是 Promise 的参数可以直接返回;遇到带 then 函数的对象,新建的 Promise 要通过 then(resolve, reject) 跟随它的最终状态。其他值直接交给 resolve,得到一个以该值为成功结果的 Promise。
实现 resolve 静态方法有三个要点:
- 传参为一个
Promise, 则直接返回它。 - 传参为一个
thenable对象,返回的Promise会跟随这个对象,采用它的最终状态作为自己的状态。 - 其他情况,直接返回以该值为成功状态的
promise对象。
Promise.resolve = (param) => {
  if(param instanceof Promise) return param;
  return new Promise((resolve, reject) => {
    if(param && param.then && typeof param.then === 'function') {
      // param 状态变为成功会调用resolve,将新 Promise 的状态变为成功,反之亦然
      param.then(resolve, reject);
    }else {
      resolve(param);
    }
  })
}
💬 面试官追问
支付页把一个已经存在的
Promise传给手写Promise.resolve,调用方要求对象引用不变,你的实现能否再包一层?不能;当参数已经是当前实现识别的
Promise时,应直接返回原对象,保证引用不变。若无条件new Promise,最终状态或许仍能跟随,但对象身份已经改变,依赖严格相等判断的代码会出现偏差。SDK返回{ then(resolve, reject) { ... } }而不是真正的Promise,业务层调用Promise.resolve后应该观察到什么?返回的新
Promise应调用该对象的then(resolve, reject),并采用它最终兑现或拒绝的状态。判断前要确保参数非空且then是函数;若只认instanceof Promise,这种跨库提供的thenable就会被错误地当作普通值。列表页把
null、数字0和普通配置对象分别交给Promise.resolve,为什么不能统一尝试调用.then?这些值都应直接成为成功态结果,只有非空且具有函数型
then的参数才按thenable处理。无保护地读取或调用.then会让null抛错,也可能把普通非函数属性误当异步协议;类型分支必须先于调用。线上接入第三方对象后,
Promise.resolve(value)一直不结束,你会怎样判断问题在包装逻辑还是第三方then?先确认它是否被识别为
thenable,再观察其then是否实际调用了传入的resolve或reject。包装后的状态完全跟随该对象;若第三方永远不调用任一回调,新Promise就会持续等待,包装层无法凭空推断最终状态。团队有人主张所有输入都
resolve(param),另一人要求专门展开thenable,在兼容多个异步库时应选哪种?应保留
thenable分支,使返回的Promise跟随外部对象的最终状态,而不是把它当作普通成功值交给后续逻辑。普通值仍可直接resolve;代价是实现必须谨慎识别并调用then,第三方实现异常也会成为兼容边界。
# 2 实现 Promise.reject
⚡ 30 秒速记
Promise.reject的实现就是创建一个新的Promise,并立即用传入的reason调用reject。- 这里不需要判断参数类型,也不会像
Promise.resolve那样尝试跟随thenable的状态,而是把参数原封不动作为失败原因。 - 即使传入的是一个
Promise,它也只是当前拒绝结果的reason。
Promise.reject 的实现就是创建一个新的 Promise,并立即用传入的 reason 调用 reject。 这里不需要判断参数类型,也不会像 Promise.resolve 那样尝试跟随 thenable 的状态,而是把参数原封不动作为失败原因。即使传入的是一个 Promise,它也只是当前拒绝结果的 reason。
Promise.reject 中传入的参数会作为一个 reason 原封不动地往下传, 实现如下:
Promise.reject = function (reason) {
    return new Promise((resolve, reject) => {
        reject(reason);
    });
}
💬 面试官追问
接口层执行
Promise.reject(existingPromise),下游为什么拿到的是这个对象本身,而不是跟随它的最终状态?Promise.reject会把传入参数原封不动作为拒绝原因,不会像Promise.resolve那样吸收Promise或thenable的状态。因此拒绝处理器接收到的就是existingPromise;若业务想跟随其结果,应重新审视调用方选错静态方法的可能。批量导入页面要把服务端返回的错误对象继续交给统一错误处理器,手写
reject时怎样避免丢失字段?直接创建新的
Promise,并在执行器中调用reject(reason),不要改写、包装或字符串化reason。这样错误对象的字段与引用都能继续传递;若为了日志提前转换成字符串,下游将失去状态码和业务上下文。调用方传入
undefined作为拒绝原因,监控负责人要求手写实现自动补一个Error,你会接受吗?若目标是复现
Promise.reject语义,就不应自动补值,而应以undefined原样拒绝。补充Error可以作为业务封装层的规范,但会改变静态方法的可观察结果;两种职责应分开,否则兼容测试和错误判断都会失真。线上日志显示拒绝原因从对象变成了
{ message: ... },而源代码调用的是Promise.reject(error),你会排查哪类改写?先检查手写
Promise.reject是否在调用reject前重新构造、序列化或解构了参数。标准目标是把reason原封不动传下去,任何包装都会改变引用或字段;也要继续检查后续错误处理器,因为变形未必发生在静态方法内部。代码评审中有人想用
Promise.resolve().then(() => { throw reason })代替直接构造拒绝态,你如何取舍?表达“立即得到一个以
reason拒绝的Promise”时,直接new Promise((_, reject) => reject(reason))更贴合实现目标。通过额外的then抛出也能形成拒绝,但引入了不必要的中间链路;若要验证静态方法语义,越少附加行为越容易判断。
# 3 实现 Promise.prototype.finally
⚡ 30 秒速记
Promise.prototype.finally无论前一个Promise成功还是失败都会执行回调,并在回调正常完成后保留原来的结果或错误。- 它本质上仍通过
then返回新的Promise,所以后面可以继续链式调用,而且callback不会收到前一步的数据。 - 若回调返回异步任务,需要先用
Promise.resolve等它结束;任务成功后继续传递原状态,任务失败时则改为向后传递这个新的失败原因。 - 实现时,成功分支返回原值,失败分支重新抛出原错误。
Promise.prototype.finally 无论前一个 Promise 成功还是失败都会执行回调,并在回调正常完成后保留原来的结果或错误。 它本质上仍通过 then 返回新的 Promise,所以后面可以继续链式调用,而且 callback 不会收到前一步的数据。若回调返回异步任务,需要先用 Promise.resolve 等它结束;任务成功后继续传递原状态,任务失败时则改为向后传递这个新的失败原因。实现时,成功分支返回原值,失败分支重新抛出原错误。
前面的
promise不管成功还是失败,都会走到finally中,并且finally之后,还可以继续then(说明它还是一个then方法是关键),并且会将初始的promise值原封不动的传递给后面的then.
Promise.prototype.finally最大的作用
finally里的函数,无论如何都会执行,并会把前面的值原封不动传递给下一个then方法中- 如果
finally函数中有promise等异步任务,会等它们全部执行完毕,再结合之前的成功与否状态,返回值
Promise.prototype.finally六大情况用法
// 情况1
Promise.resolve(123).finally((data) => { // 这里传入的函数,无论如何都会执行
  console.log(data); // undefined
})

// 情况2 (这里,finally方法相当于做了中间处理,起一个过渡的作用)
Promise.resolve(123).finally((data) => {
  console.log(data); // undefined
}).then(data => {
  console.log(data); // 123
})

// 情况3 (这里只要reject,都会走到下一个then的err中)
Promise.reject(123).finally((data) => {
  console.log(data); // undefined
}).then(data => {
  console.log(data);
}, err => {
  console.log(err, 'err'); // 123 err
})

// 情况4 (一开始就成功之后,会等待finally里的promise执行完毕后,再把前面的data传递到下一个then中)
Promise.resolve(123).finally((data) => {
  console.log(data); // undefined
  return new Promise((resolve, reject) => {
    setTimeout(() => {
      resolve('ok');
    }, 3000)
  })
}).then(data => {
  console.log(data, 'success'); // 123 success
}, err => {
  console.log(err, 'err');
})

// 情况5 (虽然一开始成功,但是只要finally函数中的promise失败了,就会把其失败的值传递到下一个then的err中)
Promise.resolve(123).finally((data) => {
  console.log(data); // undefined
  return new Promise((resolve, reject) => {
    setTimeout(() => {
      reject('rejected');
    }, 3000)
  })
}).then(data => {
  console.log(data, 'success');
}, err => {
  console.log(err, 'err'); // rejected err
})

// 情况6 (虽然一开始失败,但是也要等finally中的promise执行完,才能把一开始的err传递到err的回调中)
Promise.reject(123).finally((data) => {
  console.log(data); // undefined
  return new Promise((resolve, reject) => {
    setTimeout(() => {
      resolve('resolve');
    }, 3000)
  })
}).then(data => {
  console.log(data, 'success');
}, err => {
  console.log(err, 'err'); // 123 err
})
源码实现
Promise.prototype.finally = function (callback) {
  return this.then((data) => {
    // 让函数执行 内部会调用方法,如果方法是promise,需要等待它完成
    // 如果当前promise执行时失败了,会把err传递到,err的回调函数中
    return Promise.resolve(callback()).then(() => data); // data 上一个promise的成功态
  }, err => {
    return Promise.resolve(callback()).then(() => {
      throw err; // 把之前的失败的err,抛出去
    });
  })
}
💬 面试官追问
保存页面先
Promise.resolve(123),清理函数finally(data)里打印参数却是undefined,随后then又收到123,这是实现错误吗?不是,
finally的回调不接收前序成功值或失败原因,因此形参得到undefined;前序的123应在清理成功后继续传给后面的then。实现可在成功分支执行Promise.resolve(callback()).then(() => data),不能用清理函数的返回值替换原值。上传任务成功后要异步释放锁,
finally返回一个三秒后完成的Promise,结果处理器应该何时执行?后续处理应等待释放锁的
Promise完成,再接收到上传任务原来的成功值。用Promise.resolve(callback())吸收清理函数返回值即可兼容同步与异步清理;若清理一直不结束,整条链也会持续等待。订单请求已成功,但
finally中的资源回收返回拒绝态,产品坚持后续仍展示下单成功,你会指出什么语义冲突?原生语义下,
finally返回的Promise一旦拒绝,后续链会转为该清理失败原因,而不会继续传递原成功值。若业务必须展示原结果,应在清理逻辑内部明确消化并记录异常;这样做会隐藏资源回收失败,需要另设监控。接口原本以
123拒绝,finally的异步清理成功完成后,下游却进入成功回调,你会检查实现中的哪一处?检查失败分支在等待
callback()后是否重新throw err。只写Promise.resolve(callback()).then(() => err)会把原拒绝原因当作成功值返回,从而错误地切换链路状态;清理成功只能恢复原拒绝,不能将其吞掉。关闭弹窗时
finally回调同步抛出异常,线上看到原请求错误被覆盖,这是否符合这份实现的推导?符合;
callback()在成功或失败分支中执行,若它同步抛错,当前then返回的Promise会以该新异常拒绝。原状态只有在清理正常完成时才继续传递,因此清理代码应尽量可控,并对可能抛错的操作明确处理。团队争论用
then(successCleanup, failureCleanup)还是抽成finally做加载态复位,哪种更不容易破坏原链路?成功与失败都执行同一清理且需要保持原状态时,
finally更直接,因为它统一等待清理完成并透传原值或原错误。手写时仍需分别处理成功返回与失败重抛;若清理结果本身要参与业务分支,显式then反而更清晰。
# 4 实现 Promise.all
⚡ 30 秒速记
- 实现
Promise.all的关键,是按原顺序收集结果,并在全部成功后统一resolve。 - 遍历时用
Promise.resolve包装每一项,因为传入值不一定都是Promise,每完成一项就记录到对应下标并累加计数。 - 只要其中一项失败,就立即调用
reject;如果传入的是空集合,则直接以空数组完成。
实现 Promise.all 的关键,是按原顺序收集结果,并在全部成功后统一 resolve。 遍历时用 Promise.resolve 包装每一项,因为传入值不一定都是 Promise,每完成一项就记录到对应下标并累加计数。只要其中一项失败,就立即调用 reject;如果传入的是空集合,则直接以空数组完成。
对于 all 方法而言,需要完成下面的核心功能:
- 传入参数为一个空的可迭代对象,则直接进行
resolve。 - 如果参数中有一个
promise失败,那么Promise.all返回的promise对象失败。 - 在任何情况下,
Promise.all返回的promise的完成状态的结果都是一个数组
Promise.all = function(promises) {
  return new Promise((resolve, reject) => {
    let result = [];
    let index = 0;
    let len = promises.length;
    if(len === 0) {
      resolve(result);
      return;
    }

    for(let i = 0; i < len; i++) {
      // 为什么不直接 promise[i].then, 因为promise[i]可能不是一个promise
      Promise.resolve(promise[i]).then(data => {
        result[i] = data;
        index++;
        if(index === len) resolve(result);
      }).catch(err => {
        reject(err);
      })
    }
  })
}
💬 面试官追问
商品详情页同时请求价格、库存和优惠券,三个请求完成顺序每次不同;如果你实现的
Promise.all直接按完成顺序push,页面会出现什么错误,应该怎样改?返回值会错位,调用方可能把库存当成价格,因为
Promise.all要保持输入顺序,而不是完成顺序。遍历时保存索引,将结果写入result[i],再用独立计数判断是否全部完成;数组长度或push次数都不适合代替完成计数。初始化后台页面时传入
[用户请求, 主题配置对象, 权限请求],实现里直接调用item.then后配置对象导致白屏,你会怎样修正?每一项都应先经过
Promise.resolve(item),让普通值与Promise使用同一条处理链。成功后按原索引写入结果,失败则拒绝外层Promise;若只判断原值是否存在then,还可能遗漏或错误处理类Promise值。批量导入页面可能传入空任务数组,你写的
Promise.all([])一直处于pending,进度弹窗无法关闭,根因和修复是什么?根因是循环不会执行,完成计数也永远没有机会触发
resolve。进入循环前应判断输入长度,空集合立即以空数组[]完成;缺少这个分支会让依赖.then或await的后续流程永久等待。订单页并行加载五个模块,其中评论接口最先失败,但其余请求稍后仍在服务端出现;产品认为
Promise.all应该自动停掉它们,你怎么解释并落地?外层
Promise会在首个拒绝到来时快速失败,但已经启动的异步任务不会因此自动取消。若请求确实需要终止,任务本身必须支持类似AbortSignal的取消机制,并由业务层触发;仅调用reject只能改变聚合结果,不能撤销底层副作用。数据看板有两种诉求:任一核心指标失败就整页报错,或保留成功卡片并展示失败项;你会在
Promise.all与Promise.allSettled间怎样选?核心数据缺一不可时选
Promise.all,首个失败即可让整体进入拒绝分支。允许部分展示时选Promise.allSettled,逐项检查状态后渲染;代价是调用方必须明确处理每个失败,不能把聚合成功误认为所有任务都成功。
# 5 实现promise.allsettle
⚡ 30 秒速记
Promise.allSettled会等待所有任务结束,再返回每一项的执行状态和结果。- 它和
Promise.all最大的区别是不短路,即使某个任务失败,其他任务仍会继续处理。 - 实现时按原下标保存
{ status: 'fulfilled', value }或{ status: 'rejected', value },完成数量等于输入长度后再统一resolve。 - 它适合多个任务彼此独立,并且调用方需要查看每项结果的场景。
Promise.allSettled 会等待所有任务结束,再返回每一项的执行状态和结果。 它和 Promise.all 最大的区别是不短路,即使某个任务失败,其他任务仍会继续处理。实现时按原下标保存 { status: 'fulfilled', value } 或 { status: 'rejected', value },完成数量等于输入长度后再统一 resolve。它适合多个任务彼此独立,并且调用方需要查看每项结果的场景。
MDN:
Promise.allSettled()方法返回一个在所有给定的promise都已经fulfilled或rejected后的promise,并带有一个对象数组,每个对象表示对应的promise`结果
当您有多个彼此不依赖的异步任务成功完成时,或者您总是想知道每个promise的结果时,通常使用它。
【译】
Promise.allSettled跟Promise.all类似, 其参数接受一个Promise的数组, 返回一个新的Promise, 唯一的不同在于, 其不会进行短路, 也就是说当Promise全部处理完成后我们可以拿到每个Promise的状态, 而不管其是否处理成功。
用法 | 测试用例
let fs = require('fs').promises;

let getName = fs.readFile('./name.txt', 'utf8'); // 读取文件成功
let getAge = fs.readFile('./age.txt', 'utf8');

Promise.allSettled([1, getName, getAge, 2]).then(data => {
    console.log(data);
});
// 输出结果
/*
    [
    { status: 'fulfilled', value: 1 },
    { status: 'fulfilled', value: 'zf' },
    { status: 'fulfilled', value: '11' },
    { status: 'fulfilled', value: 2 }
    ]
*/

let getName = fs.readFile('./name123.txt', 'utf8'); // 读取文件失败
let getAge = fs.readFile('./age.txt', 'utf8');
// 输出结果
/*
    [
    { status: 'fulfilled', value: 1 },
    {
      status: 'rejected',
      value: [Error: ENOENT: no such file or directory, open './name123.txt'] {
        errno: -2,
        code: 'ENOENT',
        syscall: 'open',
        path: './name123.txt'
      }
    },
    { status: 'fulfilled', value: '11' },
    { status: 'fulfilled', value: 2 }
  ]
*/
实现
function isPromise (val) {
  return typeof val.then === 'function'; // (123).then => undefined
}

Promise.allSettled = function(promises) {
  return new Promise((resolve, reject) => {
    let arr = [];
    let times = 0;
    const setData = (index, data) => {
      arr[index] = data;
      if (++times === promises.length) {
        resolve(arr);
      }
      console.log('times', times)
    }

    for (let i = 0; i < promises.length; i++) {
      let current = promises[i];
      if (isPromise(current)) {
        current.then((data) => {
          setData(i, { status: 'fulfilled', value: data });
        }, err => {
          setData(i, { status: 'rejected', value: err })
        })
      } else {
        setData(i, { status: 'fulfilled', value: current })
      }
    }
  })
}
💬 面试官追问
文件管理页并行读取四个文件,其中一个路径不存在;如果你的
allSettled在首个reject时直接拒绝外层Promise,页面会丢掉哪些信息,正确结果应是什么?页面会拿不到其余文件最终是成功还是失败,这违背了收集全部结果的用途。外层
Promise应等待每一项落定,并在对应位置写入{ status: 'fulfilled', value }或{ status: 'rejected', reason };单项失败不能让聚合过程短路。设置页提交
[本地配置对象, 保存请求, 主题字符串],实现只处理带.then的值,最终一直不返回,你会怎样统一这三类输入?将每一项交给
Promise.resolve后再注册成功和失败处理,可让普通值直接成为fulfilled结果,也能统一处理异步项。每个分支都必须调用同一个记录函数并增加完成计数,否则任一普通值或失败分支漏计都会使外层永久pending。空选批量操作调用
Promise.allSettled([])后加载状态一直不结束,而实现中的完成判断只写在循环回调里,应该补哪条边界?空输入不会进入循环,因此必须在遍历前直接以
[]完成。不能期待计数器自然达到长度,因为没有任何回调会执行;这个边界与Promise.all([])类似,遗漏后会形成稳定可复现的挂起故障。监控面板的结果数组偶尔把第十个探针状态显示到第三行,代码使用回调结束时
arr.push(result),你会如何定位和修改?异步任务完成顺序不等于输入顺序,
push会让结果随网络时序漂移。遍历时捕获当前索引,通过arr[index] = result固定位置,再用独立计数决定何时resolve;只预设数组长度并不能证明所有槽位已经写入。风控负责人要求二十项校验全部跑完以生成审计报告,交互负责人则希望首项失败就立即提示;你会怎样拆分选型?
审计报告需要每项状态,应使用
allSettled并在全部落定后汇总;即时阻断更符合Promise.all的快速失败语义。若两种体验都要,需把早期提示与最终汇总分成两层流程,但已经启动的任务仍会继续,不能把聚合策略当作取消机制。
# 6 实现 Promise.race
⚡ 30 秒速记
- 实现
Promise.race,本质上是谁最先完成,就用谁的结果决定返回值。 - 遍历输入后,用
Promise.resolve包装每一项,再分别把成功结果交给resolve、失败原因交给reject。 - 返回的
Promise状态一旦确定,后续任务即使继续完成也不会改变结果。 - 输入为空时没有任务胜出,因此返回值会一直保持等待状态。
实现 Promise.race,本质上是谁最先完成,就用谁的结果决定返回值。 遍历输入后,用 Promise.resolve 包装每一项,再分别把成功结果交给 resolve、失败原因交给 reject。返回的 Promise 状态一旦确定,后续任务即使继续完成也不会改变结果。输入为空时没有任务胜出,因此返回值会一直保持等待状态。
race 的实现相比之下就简单一些,只要有一个 promise 执行完,直接 resolve 并停止执行
Promise.race = function(promises) {
  return new Promise((resolve, reject) => {
    let len = promises.length;
    if(len === 0) return;
    for(let i = 0; i < len; i++) {
      Promise.resolve(promise[i]).then(data => {
        resolve(data);
        return;
      }).catch(err => {
        reject(err);
        return;
      })
    }
  })
}
💬 面试官追问
搜索页同时请求两个镜像接口,较快的那个返回
reject,较慢的随后成功;候选人说Promise.race应采用首个成功结果,你会怎样纠正?Promise.race采用的是最先落定的结果,不是最先成功的结果,因此先到的拒绝会让外层直接拒绝。若业务要“首个成功”,需要另行设计失败计数与聚合逻辑;把失败忽略掉会改变race的既定语义。图片预览页把缓存字符串和远程加载
Promise一起交给race,实现直接调用每项的.then后报错,应该如何兼容?遍历项应先用
Promise.resolve(item)归一化,普通值会成为可参与竞争的已完成结果。随后同时注册成功和失败处理,任一项最先落定就决定外层状态;普通值通常会很快胜出,因此混入它是否符合业务意图也要先确认。任务调度器偶尔调用
Promise.race([]),值班同学看到调用一直没有后续日志,应该判断为异常实现还是预期边界?空集合没有任何参与者能够触发
resolve或reject,因此返回值会一直保持pending,这与代码中的直接返回一致。调用方若不能接受永久等待,应在调用前拒绝空输入或提供兜底任务;不能擅自让它以[]完成,那会混淆all的语义。上传页用
race([upload, timeout])做超时控制,超时提示出现后服务端仍收到了文件,产品认定上传逻辑失效,你会怎样排查?race只让超时任务率先决定外层结果,不会停止仍在执行的上传任务。应确认上传实现是否接收取消信号,并在超时分支主动中止;若底层不支持取消,只能忽略迟到结果,网络传输和服务端副作用仍可能发生。多机房读取配置时,架构师想用
race降低等待,但运维要求任一机房瞬时失败不能拖垮页面,这个冲突怎么处理?直接使用
race时,最快的失败同样会成为最终结果,无法保证拿到最快成功值。若必须容忍局部失败,应使用专门的首个成功策略,或在任务层把可恢复失败转换为继续等待的信号;代价是所有候选都失败时还要汇总并明确最终错误。
# 7 实现一个简版Promise
⚡ 30 秒速记
- 简版
Promise可以用状态、结果值和两组回调队列来实现。 - 初始状态是
PENDING,调用resolve或reject后只能单向变为RESOLVED或REJECTED,这样能避免结果被重复修改。 - 调用
then时,如果状态已确定就直接执行对应回调;如果仍在等待,就先把成功和失败回调存入队列。 - 构造函数执行异常时还要调用
reject,而示例实现只覆盖了基础状态与回调处理。
简版 Promise 可以用状态、结果值和两组回调队列来实现。 初始状态是 PENDING,调用 resolve 或 reject 后只能单向变为 RESOLVED 或 REJECTED,这样能避免结果被重复修改。调用 then 时,如果状态已确定就直接执行对应回调;如果仍在等待,就先把成功和失败回调存入队列。构造函数执行异常时还要调用 reject,而示例实现只覆盖了基础状态与回调处理。
// 使用
var promise = new Promise((resolve,reject) => {
    if (操作成功) {
        resolve(value)
    } else {
        reject(error)
    }
})
promise.then(function (value) {
    // success
},function (value) {
    // failure
})
function myPromise(constructor) {
    let self = this;
    self.status = "pending"   // 定义状态改变前的初始状态
    self.value = undefined;   // 定义状态为resolved的时候的状态
    self.reason = undefined;  // 定义状态为rejected的时候的状态
    function resolve(value) {
       if(self.status === "pending") {
          self.value = value;
          self.status = "resolved";
       }
    }
    function reject(reason) {
       if(self.status === "pending") {
          self.reason = reason;
          self.status = "rejected";
       }
    }
    // 捕获构造异常
    try {
       constructor(resolve,reject);
    } catch(e) {
       reject(e);
    }
}
// 添加 then 方法
myPromise.prototype.then = function(onFullfilled,onRejected) {
   let self = this;
   switch(self.status) {
      case "resolved":
        onFullfilled(self.value);
        break;
      case "rejected":
        onRejected(self.reason);
        break;
      default:
   }
}

var p = new myPromise(function(resolve,reject) {
    resolve(1)
});
p.then(function(x) {
    console.log(x) // 1
})
使用class实现
class MyPromise {
  constructor(fn) {
    this.resolvedCallbacks = [];
    this.rejectedCallbacks = [];

    this.state = 'PENDING';
    this.value = '';

    fn(this.resolve.bind(this), this.reject.bind(this));

  }

  resolve(value) {
    if (this.state === 'PENDING') {
      this.state = 'RESOLVED';
      this.value = value;

      this.resolvedCallbacks.map(cb => cb(value));
    }
  }

  reject(value) {
    if (this.state === 'PENDING') {
      this.state = 'REJECTED';
      this.value = value;

      this.rejectedCallbacks.map(cb => cb(value));
    }
  }

  then(onFulfilled, onRejected) {
    if (this.state === 'PENDING') {
      this.resolvedCallbacks.push(onFulfilled);
      this.rejectedCallbacks.push(onRejected);

    }

    if (this.state === 'RESOLVED') {
      onFulfilled(this.value);
    }

    if (this.state === 'REJECTED') {
      onRejected(this.value);
    }
  }
}
💬 面试官追问
登录页创建
myPromise后先保持pending,接口返回时调用resolve,但此前注册的.then永远不执行;对照这份简版实现,缺了什么机制?仅在
.then调用当下检查状态无法覆盖异步落定,pending时必须保存成功和失败回调。resolve或reject首次改变状态后再依次执行对应队列;若不做队列,只有构造器内同步落定的示例能够工作。支付回调代码连续调用
resolve('ok')、reject(error)和再次resolve,页面状态应该由哪次调用决定,代码里如何保证?只有第一次从
pending发起的状态迁移有效,后续调用都应被忽略。resolve与reject内部先检查当前状态,再写入值和目标状态;缺少这道检查会让成功与失败相互覆盖,破坏状态一旦落定不可改变的约束。构造
new MyPromise(() => { throw new Error('bad') })时页面直接抛出未捕获异常,而预期走失败回调,你会修改哪里?执行传入函数时要包在
try...catch中,并把捕获到的异常交给reject。这样构造阶段的同步异常才能转换为拒绝状态;该处理只覆盖执行器同步抛错,之后异步回调里的异常不会被外层这段try...catch自动捕获。一个
pending请求同时被列表、角标和日志模块各调用一次.then,简版类实现只保存单个回调时会出现什么线上现象?后注册的处理可能覆盖先注册者,导致部分模块永远收不到结果。应分别维护成功与失败回调数组,
pending时追加而非替换,落定后遍历对应数组;回调执行中的异常与链式返回仍不属于这个最简队列模型自动解决的范围。代码评审中有人要求这个简版
.then支持p.then(fn).then(fn2),但当前.then没有返回值;这是补一行return this就能解决吗?不能返回原实例,因为原实例落定后状态不可再次改变,后续链条也无法承接前一个回调的结果。完整链式调用需要
.then创建新的Promise,并根据回调返回值决定新实例状态;这已经超出只演示状态与回调队列的简版范围。
# 8 Promise 实现-详细
⚡ 30 秒速记
- 实现
Promise的核心,是维护一个只能从pending变为resolved或rejected的状态机。 - 构造函数立即执行,并用两个队列暂存
then注册的成功和失败回调,状态确定后再异步触发。 then必须返回新的Promise,这样才能接住回调返回值并继续链式调用,本质上类似flatMap。- 如果
resolve收到另一个Promise,还要递归采用它最终的状态和值。
实现 Promise 的核心,是维护一个只能从 pending 变为 resolved 或 rejected 的状态机。 构造函数立即执行,并用两个队列暂存 then 注册的成功和失败回调,状态确定后再异步触发。then 必须返回新的 Promise,这样才能接住回调返回值并继续链式调用,本质上类似 flatMap。如果 resolve 收到另一个 Promise,还要递归采用它最终的状态和值。
- 可以把
Promise看成一个状态机。初始是pending状态,可以通过函数resolve和reject,将状态转变为resolved或者rejected状态,状态一旦改变就不能再次变化。 then函数会返回一个Promise实例,并且该返回值是一个新的实例而不是之前的实例。因为Promise规范规定除了pending状态,其他状态是不可以改变的,如果返回的是一个相同实例的话,多个then调用就失去意义了。- 对于
then来说,本质上可以把它看成是flatMap
// 三种状态
const PENDING = "pending";
const RESOLVED = "resolved";
const REJECTED = "rejected";
// promise 接收一个函数参数,该函数会立即执行
function MyPromise(fn) {
  let _this = this;
  _this.currentState = PENDING;
  _this.value = undefined;
  // 用于保存 then 中的回调,只有当 promise
  // 状态为 pending 时才会缓存,并且每个实例至多缓存一个
  _this.resolvedCallbacks = [];
  _this.rejectedCallbacks = [];

  _this.resolve = function (value) {
    if (value instanceof MyPromise) {
      // 如果 value 是个 Promise,递归执行
      return value.then(_this.resolve, _this.reject)
    }
    setTimeout(() => { // 异步执行,保证执行顺序
      if (_this.currentState === PENDING) {
        _this.currentState = RESOLVED;
        _this.value = value;
        _this.resolvedCallbacks.forEach(cb => cb());
      }
    })
  };

  _this.reject = function (reason) {
    setTimeout(() => { // 异步执行,保证执行顺序
      if (_this.currentState === PENDING) {
        _this.currentState = REJECTED;
        _this.value = reason;
        _this.rejectedCallbacks.forEach(cb => cb());
      }
    })
  }
  // 用于解决以下问题
  // new Promise(() => throw Error('error))
  try {
    fn(_this.resolve, _this.reject);
  } catch (e) {
    _this.reject(e);
  }
}

MyPromise.prototype.then = function (onResolved, onRejected) {
  var self = this;
  // 规范 2.2.7,then 必须返回一个新的 promise
  var promise2;
  // 规范 2.2.onResolved 和 onRejected 都为可选参数
  // 如果类型不是函数需要忽略,同时也实现了透传
  // Promise.resolve(4).then().then((value) => console.log(value))
  onResolved = typeof onResolved === 'function' ? onResolved : v => v;
  onRejected = typeof onRejected === 'function' ? onRejected : r => throw r;

  if (self.currentState === RESOLVED) {
    return (promise2 = new MyPromise(function (resolve, reject) {
      // 规范 2.2.4,保证 onFulfilled,onRjected 异步执行
      // 所以用了 setTimeout 包裹下
      setTimeout(function () {
        try {
          var x = onResolved(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (reason) {
          reject(reason);
        }
      });
    }));
  }

  if (self.currentState === REJECTED) {
    return (promise2 = new MyPromise(function (resolve, reject) {
      setTimeout(function () {
        // 异步执行onRejected
        try {
          var x = onRejected(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (reason) {
          reject(reason);
        }
      });
    }));
  }

  if (self.currentState === PENDING) {
    return (promise2 = new MyPromise(function (resolve, reject) {
      self.resolvedCallbacks.push(function () {
        // 考虑到可能会有报错,所以使用 try/catch 包裹
        try {
          var x = onResolved(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (r) {
          reject(r);
        }
      });

      self.rejectedCallbacks.push(function () {
        try {
          var x = onRejected(self.value);
          resolutionProcedure(promise2, x, resolve, reject);
        } catch (r) {
          reject(r);
        }
      });
    }));
  }
};
// 规范 2.3
function resolutionProcedure(promise2, x, resolve, reject) {
  // 规范 2.3.1,x 不能和 promise2 相同,避免循环引用
  if (promise2 === x) {
    return reject(new TypeError("Error"));
  }
  // 规范 2.3.2
  // 如果 x 为 Promise,状态为 pending 需要继续等待否则执行
  if (x instanceof MyPromise) {
    if (x.currentState === PENDING) {
      x.then(function (value) {
        // 再次调用该函数是为了确认 x resolve 的
        // 参数是什么类型,如果是基本类型就再次 resolve
        // 把值传给下个 then
        resolutionProcedure(promise2, value, resolve, reject);
      }, reject);
    } else {
      x.then(resolve, reject);
    }
    return;
  }
  // 规范 2.3.3.3.3
  // reject 或者 resolve 其中一个执行过得话,忽略其他的
  let called = false;
  // 规范 2.3.3,判断 x 是否为对象或者函数
  if (x !== null && (typeof x === "object" || typeof x === "function")) {
    // 规范 2.3.3.2,如果不能取出 then,就 reject
    try {
      // 规范 2.3.3.1
      let then = x.then;
      // 如果 then 是函数,调用 x.then
      if (typeof then === "function") {
        // 规范 2.3.3.3
        then.call(
          x,
          y => {
            if (called) return;
            called = true;
            // 规范 2.3.3.3.1
            resolutionProcedure(promise2, y, resolve, reject);
          },
          e => {
            if (called) return;
            called = true;
            reject(e);
          }
        );
      } else {
        // 规范 2.3.3.4
        resolve(x);
      }
    } catch (e) {
      if (called) return;
      called = true;
      reject(e);
    }
  } else {
    // 规范 2.3.4,x 为基本类型
    resolve(x);
  }
}
💬 面试官追问
详情页执行
Promise.resolve(4).then().then(render),自研实现因第一个.then没传回调而报错;依据详细实现,默认处理函数应该怎样设置?成功处理缺失时应使用
v => v透传值,失败处理缺失时应使用会继续抛出原因的函数。只有参数确实是函数才调用它,否则忽略并采用默认处理;若把缺失的失败处理写成返回错误,拒绝会被错误地转成成功。订单处理链写成
p.then(validate).then(save),评审提议每次.then都返回原来的p以减少对象创建,你为什么会否决?.then必须返回新的Promise,让validate的返回值或异常决定下一段链的状态。原实例一旦由pending变为已完成就不能再变化,复用它会使多个链式步骤无法独立传递结果;代价是每个链节点都要维护自己的状态与回调。构造器里立即
resolve(1),随后代码才注册.then,自研实现却在当前调用栈内同步执行回调,导致日志顺序与原生行为不同,你会改哪一层?状态落定后的处理回调仍需异步执行,详细实现用
setTimeout包裹状态迁移或回调调度来保证顺序。排查时先打印执行器、同步语句和.then回调的先后;这只是简化调度,不能据此声称完全等同于原生微任务机制。接口层执行
resolve(anotherMyPromise)后,消费方收到的却是MyPromise对象本身,而不是它最终的数据,详细实现如何处理这种值?当
resolve接收到另一个MyPromise时,应接管其最终状态,通过value.then(this.resolve, this.reject)继续解析。直接把该对象当普通值保存会破坏链式展开;若要兼容任意类Promise对象,还需要更完整的解析流程,不能只依赖instanceof MyPromise。线上偶发
new MyPromise(executor)直接中断渲染,日志显示executor同步抛错;状态机实现应怎样把它纳入统一失败路径?构造器调用
executor时应使用try...catch,捕获异常后调用内部reject。reject仍需检查状态,仅允许从pending迁移到拒绝,并通知已登记的失败回调;如果此前已经完成,后续抛错不能再次改写结果。前端负责人只想实现可用状态机,另一位要求严格支持回调返回新
Promise、值透传和异常传播;两种目标会怎样影响实现范围?可用状态机只需处理三种状态、一次性迁移和待定回调队列,适合作为原理演示。链式语义则要求
.then返回新实例、补齐默认处理,并解析回调返回值;范围明显更大,若解析不完整,嵌套Promise与异常传播仍会出现不一致。
# 9 实现Promisify
⚡ 30 秒速记
promisify就是把遵循错误优先回调的函数,包装成返回Promise的函数。- 调用时先透传原参数,再追加回调;有
err就执行reject,否则用data执行resolve。 - 如果要批量处理,可以通过
Reflect.ownKeys遍历目标对象,把函数包装后挂成带Async后缀的方法。 - 这个实现适合示例中的
NodeAPI,但依赖回调签名为(err, data),并不覆盖其他回调约定。
promisify 就是把遵循错误优先回调的函数,包装成返回 Promise 的函数。 调用时先透传原参数,再追加回调;有 err 就执行 reject,否则用 data 执行 resolve。如果要批量处理,可以通过 Reflect.ownKeys 遍历目标对象,把函数包装后挂成带 Async 后缀的方法。这个实现适合示例中的 Node API,但依赖回调签名为 (err, data),并不覆盖其他回调约定。
const fs = require('fs')
const path = require('path')

// node中使用
// const fs = require('fs').promises 12.18版
// const promisify = require('util').promisify

// 包装node api promise化 典型的高级函数
const promisify = fn=>{
  return (...args)=>{
    return new Promise((resolve,reject)=>{
      fn(...args, (err,data)=>{
        if(err) {
          reject(err)
        }
        resolve(data)
      })
    })
  }
}

// const read = promisify(fs.readFile)

// read(path.join(__dirname, './promise.js'), 'utf8').then(d=>{
//   console.log(d)
// })

// promise化node所有api
const promisifyAll = target=>{
  Reflect.ownKeys(target).forEach(key=>{
    if(typeof target[key] === 'function') {
      target[key+'Async'] = promisify(target[key])
    }
  })
  return target
}

// promise化fs下的函数
const promisifyNew = promisifyAll(fs)

promisifyNew.readFileAsync(path.join(__dirname, './promise.js'), 'utf8').then(d=>{
  console.log(d)
})

module.exports = {
  promisify,
  promisifyAll
}
💬 面试官追问
文件预览页调用
readFileAsync时底层回调先传入err,代码随后又执行resolve(data),页面会不会从失败变成成功?不会,
Promise一旦被reject,后续resolve不会改变状态,但继续执行会掩盖实现意图。应在reject(err)后立即return,并用成功、失败各调用一次的桩函数验证;底层若重复回调,仍只能采用第一次结果。批量上传模块把对象方法交给
promisify后,线上报错显示方法内部的this.client为undefined,包装器该怎么改?当前
fn(...args)丢失了调用方上下文,应在返回函数中保留动态this,再用fn.call(this, ...args, callback)调用。若传入的原函数已经被单独解构,上下文仍无法恢复,需要显式绑定实例或让promisify接收目标对象。数据库驱动的回调是
(err, rows, fields),列表页既要数据也要字段信息,当前实现只返回rows,你会怎样约定结果?当前包装只接收一个
data,不能无损表示多个成功值,可将回调剩余参数收集为数组,或为该驱动定制{ rows, fields }。通用promisify不宜擅自改变返回语义,否则调用方难以判断单值和多值;选型应以原API契约为准。监控显示某个旧
SDK会同步throw,而不是通过回调返回错误,使用这版promisify后为什么仍可能形成拒绝态?fn在new Promise的执行器内同步运行,因此同步抛出的异常会被构造器捕获并转成拒绝态。异步定时器里抛出的异常不在该调用栈内,包装器无法接住;SDK必须通过错误优先回调报告,或在其异步边界自行捕获。你准备对
fs执行promisifyAll,但对象上已有readFileAsync,还可能存在访问器属性;直接遍历并赋值有什么风险?当前实现会原地修改目标对象,可能覆盖已有同名成员,而且读取
target[key]时可能触发访问器。应先检查属性描述符和目标键冲突,只处理明确的函数值,并决定跳过还是报错;冻结对象、不可写属性及符号键命名都需要单独约束。
# 10 完整实现Promises/A+规范
⚡ 30 秒速记
- 完整实现
Promises/A+,关键是状态不可逆、then返回新实例,以及按规范解析回调返回值。 - 等待态下要用成功和失败队列保存多次
then的订阅,状态确定后统一发布。 resolvePromise需要识别普通值、对象、函数和thenable,递归取得最终结果,同时用called防止重复成功或失败。- 还要拦截
promise2返回自身的循环引用,并把读取或调用then时的异常交给reject。
完整实现 Promises/A+,关键是状态不可逆、then 返回新实例,以及按规范解析回调返回值。 等待态下要用成功和失败队列保存多次 then 的订阅,状态确定后统一发布。resolvePromise 需要识别普通值、对象、函数和 thenable,递归取得最终结果,同时用 called 防止重复成功或失败。还要拦截 promise2 返回自身的循环引用,并把读取或调用 then 时的异常交给 reject。
/**
* Promises/A+规范 实现一个promise
* https://promisesaplus.com/
*/
const EMUM = {
PENDING: 'PENDING',
FULFILLED: 'FULFILLED',
REJECTED: 'REJECTED'
}
// x 返回值
// promise2 then的时候new的promise
// promise2的resolve, reject
const resolvePromise = (x, promise2, resolve, reject)=>{
// 解析promise的值解析promise2是成功还是失败 传递到下层then
if(x === promise2) {
reject(new TypeError('类型错误'))
}
// 这里的x如果是一个promise的话 可能是其他的promise,可能调用了成功 又调用了失败
// 防止resolve的时候 又throw err抛出异常到reject了
let called
// 如果x是promise 那么就采用他的状态
// 有then方法是promise
if(typeof x === 'object' && typeof x!== null || typeof x === 'function') {
// x是对象或函数
try {
let then = x.then // 缓存,不用多次取值
if(typeof then === 'function') {
// 是promise,调用then方法里面有this,需要传入this为x才能取到then方法里面的值this.value
then.call(x, y=>{// 成功
// y值可能也是一个promise 如resolve(new Promise()) 此时的y==new Promise()
// 递归解析y,直到拿到普通的值resolve(x出去)
if(called) return;
called = true;
resolvePromise(y, promise2, resolve, reject)
},r=>{// 一旦失败直接失败
if(called) return;
called = true;
reject(r)
})
} else {
// 普通对象不是promise
resolve(x)
}
} catch (e) {
// 对象取值可能报错,用defineProperty定义get 抛出异常
if(called) return;
called = true;
reject(e)
}
} else {
// x是普通值
resolve(x) // 直接成功
}
}
class myPromise {
constructor(executor) {
this.status = EMUM.PENDING // 当前状态
this.value = undefined // resolve接收值
this.reason = undefined // reject失败返回值
/**
* 同一个promise可以then多次(发布订阅模式)
* 调用then时 当前状态是等待态,需要将当前成功或失败的回调存放起来(订阅)
* 调用resolve时 将订阅函数进行执行(发布)
*/
// 成功队列
this.onResolvedCallbacks = []
// 失败队列
this.onRejectedCallbacks = []
const resolve = value =>{
// 如果value是一个promise,需要递归解析
// 如 myPromise.resolve(new myPromise()) 需要解析value
if(value instanceof myPromise) {
// 不停的解析 直到值不是promise
return value.then(resolve,reject)
}
if(this.status === EMUM.PENDING) {
this.status = EMUM.FULFILLED
this.value = value
this.onResolvedCallbacks.forEach(fn=>fn())
}
}
const reject = reason =>{
if(this.status === EMUM.PENDING) {
this.status = EMUM.REJECTED
this.reason = reason
this.onRejectedCallbacks.forEach(fn=>fn())
}
}
try {
executor(resolve,reject)
} catch(e) {
reject(e)
}
}
then(onFulFilled, onRejected) {
// 透传 处理默认不传的情况
// new Promise((resolve,reject)=>{
// resolve(1)
// }).then().then().then(d=>{})
// new Promise((resolve,reject)=>{
// resolve(1)
// }).then(v=>v).then(v=>v).then(d=>{})
// new Promise((resolve,reject)=>{
// reject(1)
// }).then().then().then(null, e=>{console.log(e)})
// new Promise((resolve,reject)=>{
// reject(1)
// }).then(null,e=>{throw e}).then(null,e=>{throw e}).then(null,e=>{console.log(e)})
onFulFilled = typeof onFulFilled === 'function' ? onFulFilled : v => v
onRejected = typeof onRejected === 'function' ? onRejected : err => {throw err}
// 调用then 创建一个新的promise
let promise2 = new myPromise((resolve,reject)=>{
// 根据value判断是resolve 还是reject value也可能是promise
if(this.status === EMUM.FULFILLED) {
setTimeout(() => {
try {
// 成功回调结果
let x = onFulFilled(this.value)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
}, 0);
}
if(this.status === EMUM.REJECTED) {
setTimeout(() => {
try {
let x = onRejected(this.reason)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
}, 0);
}
// 用户还未调用resolve或reject方法
if(this.status === EMUM.PENDING) {
this.onResolvedCallbacks.push(()=>{
try {
let x = onFulFilled(this.value)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
})
this.onRejectedCallbacks.push(()=>{
try {
let x = onRejected(this.reason)
// 解析promise
resolvePromise(x, promise2,resolve,reject)
} catch (error) {
reject(error)
}
})
}
})
return promise2
}
catch(errCallback) {
// 等同于没有成功,把失败放进去而已
return this.then(null, errCallback)
}
// myPromise.resolve 具备等待功能的 如果参数的promise会等待promise解析完毕在向下执行
static resolve(val) {
return new myPromise((resolve,reject)=>{
resolve(val)
})
}
// myPromise.reject 直接将值返回
static reject(reason) {
return new myPromise((resolve,reject)=>{
reject(reason)
})
}
// finally传入的函数 无论成功或失败都执行
// Promise.reject(100).finally(()=>{console.log(1)}).then(d=>console.log('success',d)).catch(er=>console.log('faild',er))
// Promise.reject(100).finally(()=>new Promise()).then(d=>console.log(d)).catch(er=>)
finally(callback) {
return this.then((val)=>{
return myPromise.resolve(callback()).then(()=>val)
},(err)=>{
return myPromise.resolve(callback()).then(()=>{throw err})
})
}
// Promise.all
static all(values) {
return new myPromise((resolve,reject)=>{
let resultArr = []
let orderIndex = 0
const processResultByKey = (value,index)=>{
resultArr[index] = value
// 处理完全部
if(++orderIndex === values.length) {
resolve(resultArr) // 处理完成的结果返回去
}
}
for (let i = 0; i < values.length; i++) {
const value = values[i];
// 是promise
if(value && typeof value.then === 'function') {
value.then((val)=>{
processResultByKey(val,i)
},reject)
} else {
// 不是promise情况
processResultByKey(value,i)
}
}
})
}
static race(promises) {
// 采用最新成功或失败的作为结果
return new myPromise((resolve,reject)=>{
for (let i = 0; i < promises.length; i++) {
let val = promises[i]
if(val && typeof val.then === 'function') {
// 任何一个promise先调用resolve或reject就返回结果了 也就是返回执行最快的那个promise的结果
val.then(resolve,reject)
}else{
// 普通值
resolve(val)
}
}
})
}
}
/**
* =====测试用例-====
*/
// let promise1 = new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve('成功')
// }, 900);
// })
// promise1.then(val=>{
// console.log('success', val)
// },reason=>{
// console.log('fail', reason)
// })
/**
* then的使用方式 普通值意味不是promise
*
* 1、then中的回调有两个方法 成功或失败 他们的结果返回(普通值)会传递给外层的下一个then中
* 2、可以在成功或失败中抛出异常,走到下一次then的失败中
* 3、返回的是一个promsie,那么会用这个promise的状态作为结果,会用promise的结果向下传递
* 4、错误处理,会默认先找离自己最新的错误处理,找不到就向下查找,找打了就执行
*/
// read('./name.txt').then(data=>{
// return '123'
// }).then(data=>{
// }).then(null,err=>{
// })
// // .catch(err=>{ // catch就是没有成功的promise
// // })
/**
* promise.then实现原理:通过每次返回一个新的promise来实现(promise一旦成功就不能失败,失败就不能成功)
*
*/
// function read(data) {
// return new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve(new myPromise((resolve,reject)=>resolve(data)))
// }, 1000);
// })
// }
// let promise2 = read({name: 'poetry'}).then(data=>{
// return data
// }).then().then().then(data=>{
// console.log(data,'-data-')
// },(err)=>{
// console.log(err,'-err-')
// })
// finally测试
// myPromise
// .resolve(100)
// .finally(()=>{
// return new myPromise((resolve,reject)=>setTimeout(() => {
// resolve(100)
// }, 100))
// })
// .then(d=>console.log('finally success',d))
// .catch(er=>console.log(er, 'finally err'))
/**
* promise.all 测试
*
* myPromise.all 解决并发问题 多个异步并发获取最终的结果
*/
// myPromise.all([1,2,3,4,new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve('ok1')
// }, 1000);
// }),new myPromise((resolve,reject)=>{
// setTimeout(() => {
// resolve('ok2')
// }, 1000);
// })]).then(d=>{
// console.log(d,'myPromise.all.resolve')
// }).catch(err=>{
// console.log(err,'myPromise.all.reject')
// })
// 实现promise中断请求
let promise = new Promise((resolve,reject)=>{
setTimeout(() => {
// 模拟接口调用 ajax调用超时
resolve('成功')
}, 10000);
})
function promiseWrap(promise) {
// 包装一个promise 可以控制原来的promise是成功 还是失败
let abort
let newPromsie = new myPromise((resolve,reject)=>{
abort = reject
})
// 只要控制newPromsie失败,就可以控制被包装的promise走向失败
// Promise.race 任何一个先成功或者失败 就可以获得结果
let p = myPromise.race([promise, newPromsie])
p.abort = abort
return p
}
let newPromise = promiseWrap(promise)
setTimeout(() => {
// 超过3秒超时
newPromise.abort('请求超时')
}, 3000);
newPromise.then(d=>{
console.log('d',d)
}).catch(err=>{
console.log('err',err)
})
// 使用promises-aplus-tests 测试写的promise是否规范
// 全局安装 cnpm i -g promises-aplus-tests
// 命令行执行 promises-aplus-tests promise.js
// 测试入口 产生延迟对象
myPromise.defer = myPromise.deferred = function () {
let dfd = {}
dfd.promise = new myPromise((resolve,reject)=>{
dfd.resolve = resolve
dfd.reject = reject
})
return dfd
}
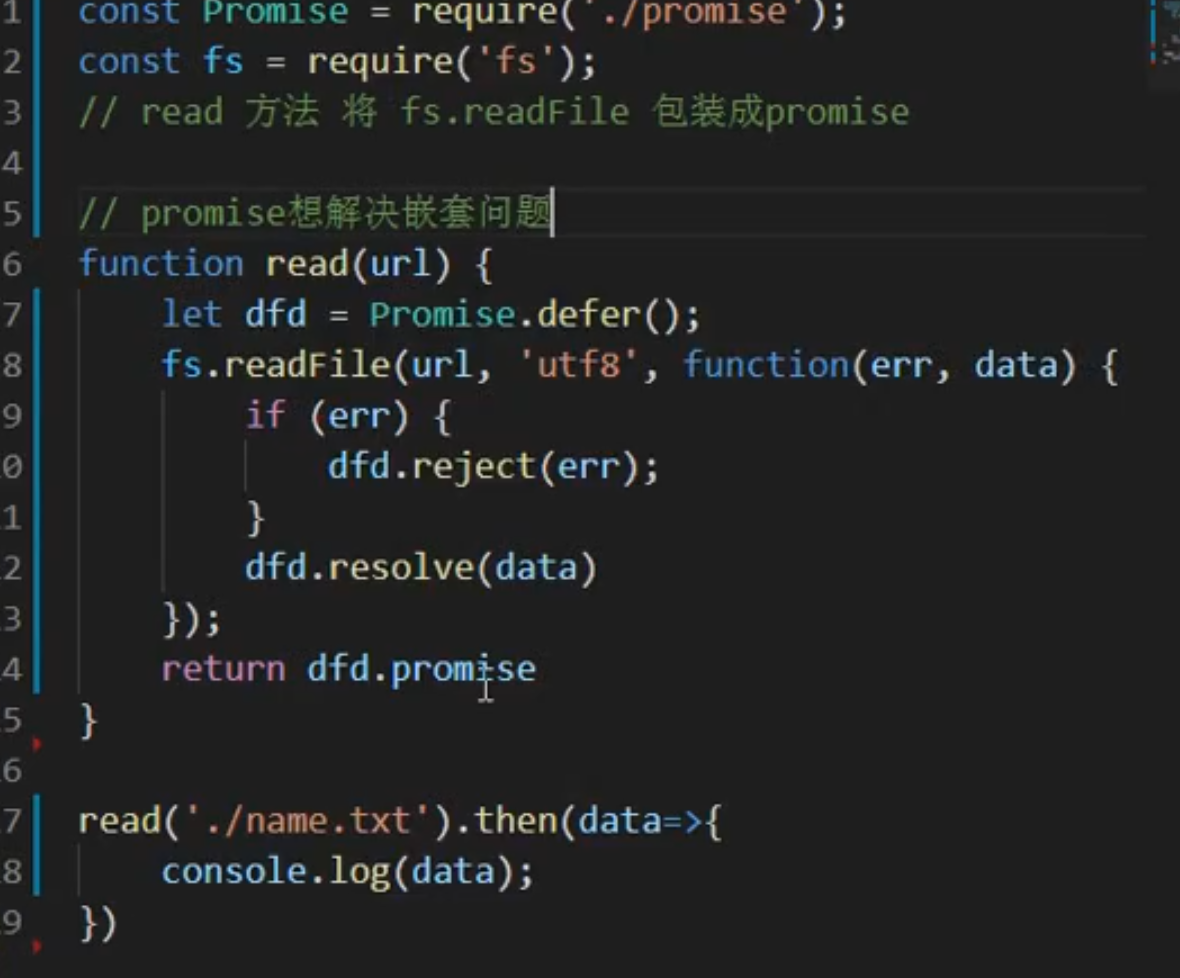
// 延迟对象用户
// 
// promise解决嵌套问题
// function readData(url) {
// let dfd = myPromise.defer()
// fs.readFile(url, 'utf8', function (err,data) {
// if(err) {
// dfd.reject()
// }
// dfd.resolve(data)
// })
// return dfd.promise
// }
// readData().then(d=>{
// return d
// })
module.exports = myPromise
💬 面试官追问
支付页的
then回调返回了它自己正在生成的promise2,如果没有x === promise2检查,链路会出现什么现象?这会形成无法解析的自引用,后续链式回调既不能正常成功,也不能得到明确失败。解析过程必须以
TypeError拒绝promise2;这里只防直接自引用,更复杂的恶意递归结构仍要依赖解析过程和测试约束。第三方登录
SDK返回一个thenable,它先调用成功回调又调用失败回调,随后还抛异常,你的实现如何保证页面只跳转一次?应以共享的
called标记锁定第一次调用,成功、失败和捕获异常三条路径都先检查它。第一次成功后还要递归解析其值,之后的拒绝或异常全部忽略;若过早设置或遗漏标记,就可能产生重复决议。风控对象把
then定义成会抛错的getter,订单页执行Promise.resolve式同化时,为什么要先缓存let then = x.then?读取
then本身就可能抛异常,因此取值必须位于try...catch内,失败时拒绝新Promise。缓存还能保证只读取一次,避免带副作用的getter前后返回不同结果;若已被回调完成,随后抛错也不能覆盖第一次决议。一个
then处理器返回嵌套三层的自定义thenable,最内层才给出普通值,为什么不能在第一层直接resolve(x)?外层结果的状态必须采用
thenable最终展开后的状态,因此需要递归执行resolvePromise,直到得到普通值或拒绝原因。直接成功会把未同化的对象传给下游,破坏链式语义;异常getter、重复回调与直接环引用要在每层继续防守。评论页在同一个等待态
Promise上注册了三个then,数据返回后只触发最后一个,应该先检查哪段状态管理?应检查等待态是否分别把成功与失败处理器追加到
onResolvedCallbacks、onRejectedCallbacks,以及决议时是否遍历整个队列。每个then还必须返回独立的promise2,不能共享下游状态;回调抛错时只应拒绝对应的下游链。团队想把“通过
Promises/A+ 测试”直接等同于“行为完全兼容原生Promise”,你会接受这个发布标准吗?不能直接等同,
Promises/A+主要约束then与解析过程,并不覆盖原生实现的全部API和宿主调度细节。可先用规范测试验证解析正确性,再补构造器、异步回调顺序及项目所需静态方法的对照测试;覆盖不足时不应替换生产原生实现。
# 11 实现发布订阅模式
⚡ 30 秒速记
- 发布者和订阅者通过事件中心解耦,双方不需要直接持有彼此引用
- 最小接口是
on、emit、off,工程版再补once emit时复制监听器数组,避免回调中退订导致本轮遍历错位- 要说明清理订阅,否则长生命周期事件中心很容易积累无效闭包
发布订阅模式通过事件中心连接发布者和订阅者,让双方不必直接依赖彼此。 实现时用缓存对象按事件名保存回调,on 负责订阅,emit 逐个触发,off 根据回调移除订阅,once 则在首次执行后自动解绑。它适合异步通知和一对多通信,优点是耦合较松,但订阅本身会占用时间和内存。与观察者模式相比,它多了一层统一调度中心;嵌套过多时,调用关系也会更难跟踪。
简介:
发布订阅者模式,一种对象间一对多的依赖关系,但一个对象的状态发生改变时,所依赖它的对象都将得到状态改变的通知。
主要的作用(优点):
- 广泛应用于异步编程中(替代了传递回调函数)
- 对象之间松散耦合的编写代码
缺点:
- 创建订阅者本身要消耗一定的时间和内存
- 多个发布者和订阅者嵌套一起的时候,程序难以跟踪维护
实现的思路:
- 创建一个对象(缓存列表)
on方法用来把回调函数fn都加到缓存列表中emit根据key值去执行对应缓存列表中的函数off方法可以根据key值取消订阅
class EventEmiter {
  constructor() {
    // 事件对象,存放订阅的名字和事件
    this._events = {}
  }
  // 订阅事件的方法
  on(eventName,callback) {
    if(!this._events) {
      this._events = {}
    }
    // 合并之前订阅的cb
    this._events[eventName] = [...(this._events[eventName] || []),callback]
  }
  // 触发事件的方法
  emit(eventName, ...args) {
    if(!this._events[eventName]) {
      return
    }
    // 遍历执行所有订阅的事件
    this._events[eventName].forEach(fn=>fn(...args))
  }
  off(eventName,cb) {
    if(!this._events[eventName]) {
      return
    }
    // 删除订阅的事件
    this._events[eventName] = this._events[eventName].filter(fn=>fn != cb && fn.l != cb)
  }
  // 绑定一次 触发后将绑定的移除掉 再次触发掉
  once(eventName,callback) {
    const one = (...args)=>{
      // 等callback执行完毕在删除
      callback(args)
      this.off(eventName,one)
    }
    one.l = callback // 自定义属性
    this.on(eventName,one)
  }
}
测试用例
let event = new EventEmiter()

let login1 = function(...args) {
  console.log('login success1', args)
}
let login2 = function(...args) {
  console.log('login success2', args)
}
// event.on('login',login1)
event.once('login',login2)
event.off('login',login1) // 解除订阅
event.emit('login', 1,2,3,4,5)
event.emit('login', 6,7,8,9)
event.emit('login', 10,11,12)
发布订阅者模式和观察者模式的区别?
- 发布/订阅模式是观察者模式的一种变形,两者区别在于,发布/订阅模式在观察者模式的基础上,在目标和观察者之间增加一个调度中心。
- 观察者模式是由具体目标调度,比如当事件触发,
Subject就会去调用观察者的方法,所以观察者模式的订阅者与发布者之间是存在依赖的。 - 发布/订阅模式由统一调度中心调用,因此发布者和订阅者不需要知道对方的存在。
💬 面试官追问
直播页既有主播模块又有礼物模块,两者通过一个事件中心通信;这和观察者直接保存在主播对象里,耦合关系有什么不同?
事件中心让发布者只发事件名和数据,不需要持有礼物模块,双方通过调度中心间接关联。观察者模式则由目标对象保存并主动调用观察者,依赖更直接;事件名和载荷若缺少约束,松耦合也会变成难追踪的隐式依赖。
单页应用反复进入订单页后,同一条
WebSocket消息触发了五次弹窗,你会沿着on、off哪些细节排查?先确认每次挂载是否重复
on,卸载时传给off的是否为同一个函数引用,而不是新建的匿名函数。再检查once包装函数能否通过one.l被原回调移除;缺少统一清理会让缓存持续增长并重复执行。埋点系统一次
emit可能触发上百个订阅者,其中一个回调抛异常,后面的订阅者还要继续收到事件,你会怎样调整?当前同步
forEach会被异常中断,后续订阅者无法执行;可按业务要求逐个try...catch,把异常交给统一错误通道后继续分发。这样会隐藏调用方原本依赖的同步失败语义,因此需要明确emit是快速失败还是隔离失败。权限弹窗用
once('ready', callback),但回调内部再次同步触发ready,为什么这版实现可能执行两次?包装函数在
callback执行完后才off,回调内重入emit时订阅仍在列表中,因此会再次调用。若要求严格一次,应先解除订阅再执行回调;代价是回调抛错后也不会恢复订阅,这通常更符合once语义。消息总线执行
emit('login', 1, 2)时,once回调收到的是一个数组,而on回调收到两个参数,哪里破坏了契约?once内写成了callback(args),把参数列表折叠成单个数组,与普通订阅的fn(...args)不一致。应改为callback(...args),并覆盖零参数、多参数及解除原回调的测试;已有消费者若依赖数组形态,修改前需要迁移。微前端团队想把这个内存事件中心当跨页面状态仓库,另一个团队主张显式状态容器,你会怎么选?
短生命周期、无需回放的一次性通知适合事件中心,它能降低模块间直接依赖。需要当前值、历史回放、调试轨迹或跨生命周期恢复时,应使用有明确状态模型的容器;滥用事件总线会让数据来源和更新顺序难以追踪。
# 12 实现观察者模式
⚡ 30 秒速记
- 观察者直接订阅目标对象,目标状态变化时逐个通知观察者
- 它与发布订阅的区别是:观察者和目标彼此知道,发布订阅通常隔着事件中心
- 最小结构包含
attach、detach、notify,观察者暴露统一的update - 适合一对多状态同步,但通知链过长时要防止循环更新和异常扩散
观察者模式就是由被观察者保存观察者,并在自身状态变化后逐个调用它们的 update 方法。 Subject 通过 attach 收集观察者,setState 更新状态后再统一通知,所以父母、老师等多个对象都能同步获得学生的最新状态。它内部也有收集和通知的过程,但观察者需要直接注册到被观察者中。使用时要先完成注册,否则状态变化时对应观察者不会收到通知。
观察者模式(基于发布订阅模式) 有观察者,也有被观察者
观察者需要放到被观察者中,被观察者的状态变化需要通知观察者 我变化了 内部也是基于发布订阅模式,收集观察者,状态变化后要主动通知观察者
class Subject { // 被观察者 学生
  constructor(name) {
    this.state = 'happy'
    this.observers = []; // 存储所有的观察者
  }
  // 收集所有的观察者
  attach(o){ // Subject. prototype. attch
    this.observers.push(o)
  }
  // 更新被观察者 状态的方法
  setState(newState) {
    this.state = newState; // 更新状态
    // this 指被观察者 学生
    this.observers.forEach(o => o.update(this)) // 通知观察者 更新它们的状态
  }
}

class Observer{ // 观察者 父母和老师
  constructor(name) {
    this.name = name
  }
  update(student) {
    console.log('当前' + this.name + '被通知了', '当前学生的状态是' + student.state)
  }
}

let student = new Subject('学生');

let parent = new Observer('父母');
let teacher = new Observer('老师');

// 被观察者存储观察者的前提,需要先接纳观察者
student.attach(parent);
student.attach(teacher);
student.setState('被欺负了');
💬 面试官追问
学生状态对象直接保存家长和老师实例并调用
update(this),如果改成发布订阅中心,双方依赖会发生什么变化?当前
Subject明确知道观察者必须提供update,属于目标直接调度观察者。加入事件中心后,目标只发布状态事件,订阅者无需被目标持有;解耦增强的同时,事件载荷契约和调用链会更隐蔽。班级看板销毁后,老师观察者仍被
student.observers引用,长时间切换页面出现内存增长,你会补什么接口?应增加与
attach对称的detach,按对象引用移除观察者,并在组件卸载时调用。还要防止重复注册同一观察者,或明确允许重复通知;遗漏清理时,只要Subject长期存活,观察者及其闭包就可能无法释放。成绩批量导入连续调用一万次
setState,家长面板只关心最终状态,仍要每次同步通知吗?不应默认让所有中间状态都同步扩散,可在业务层合并更新、批处理后通知,或让观察者自行去重。源码实现的语义是每次赋值立即遍历,改变为批量通知会丢失中间事件,因此只适合明确不依赖过程的消费者。
通知链中老师的
update抛异常,导致后面的校医观察者没有收到“被欺负了”,故障点应该怎样隔离?当前同步遍历会在异常处终止,可在每个观察者调用外单独捕获,并记录具体观察者和状态,确保其余通知继续。若状态变更要求所有观察者原子成功,就不能简单吞错,而应设计回滚或失败汇总;基础实现并未提供事务保证。
某个观察者在
update中调用detach移除自己,另一个观察者同时被新增,本轮通知名单应该如何定义?应先约定本轮使用触发时快照,还是实时遍历可变数组;较稳妥的是复制观察者列表后再通知,使新增项下轮生效。直接修改正在遍历的数组可能跳过成员或产生顺序差异,但快照会增加一次复制成本。
产品要求只有
state真正变化时才刷新三个面板,而审计模块要求重复赋值也留痕,setState应该统一过滤吗?不宜在
Subject中无条件过滤,否则审计观察者会丢失重复操作。可让状态通知与操作事件分开,或由各观察者判断新旧值;接口需要同时传递旧值和新值,代价是契约比当前只传this更明确也更复杂。
# 13 实现单例模式
⚡ 30 秒速记
- 这个单例可以用闭包保存唯一实例,再用
Proxy拦截类或构造函数的实例化过程。 - 第一次创建对象时,把结果记录到闭包变量
instance中;之后再次实例化,直接返回已经保存的对象。 - 本质上是把实例创建入口统一交给代理处理,从而避免外部重复得到新实例。
- 实现时要保证所有调用都经过这个代理,否则闭包中的单例约束无法覆盖其他创建入口。
这个单例可以用闭包保存唯一实例,再用 Proxy 拦截类或构造函数的实例化过程。 第一次创建对象时,把结果记录到闭包变量 instance 中;之后再次实例化,直接返回已经保存的对象。本质上是把实例创建入口统一交给代理处理,从而避免外部重复得到新实例。实现时要保证所有调用都经过这个代理,否则闭包中的单例约束无法覆盖其他创建入口。
核心要点: 用闭包和
Proxy属性拦截
function proxy(func) {
    let instance;
    let handler = {
        constructor(target, args) {
            if(!instance) {
                instance = Reflect.constructor(fun, args);
            }
            return instance;
        }
    }
    return new Proxy(func, handler);
}
💬 面试官追问
设置页连续执行两次
new ProxyService('A')和new ProxyService('B'),第二次参数为什么不会更新实例?代理首次构造后把实例保存在闭包中,后续构造直接返回同一引用,因此
'B'不会再次进入构造逻辑。调用方必须接受“首次参数生效”的契约,否则应禁止后续带不同参数,或改用按键缓存的多例模式。这段代理在线上一调用就没有拦截构造,代码里的
handler.constructor应该先改成什么,内部还有哪些拼写问题?Proxy的构造拦截器名称应为construct,不是constructor;创建实例应使用Reflect.construct(target, args)。源码中的fun未定义且Reflect.constructor也不是对应调用,任一处都会让单例逻辑失效或直接抛错。依赖注入容器要代理一个带继承关系的类,调用方还会传入
newTarget,只写Reflect.construct(target, args)有什么限制?简单单例只保证目标类首次实例化,无法完整保留不同
newTarget下的派生构造语义。构造陷阱可接收第三个参数并评估Reflect.construct(target, args, newTarget),但多个派生类共享同一闭包实例通常不合理,应先明确缓存粒度。服务端渲染同时处理多个用户请求,团队准备把用户会话客户端做成模块级单例,你会阻止吗?
应阻止把请求相关状态放进进程级单例,因为不同请求会共享同一个实例,存在状态串扰风险。单例适合无用户隔离要求的共享服务;会话客户端应按请求创建,或按明确的请求键和生命周期管理缓存。
测试套件发现前一个用例修改了单例状态,后一个用例即使重新
new仍然失败,怎样提高可测试性?闭包中的
instance没有公开重置点,重新构造仍返回旧对象,因此用例之间会相互污染。可把实例生命周期交给依赖注入容器,测试时替换工厂或创建新的代理;暴露生产重置接口虽方便,却可能破坏单例不变量。前端只需要共享一个无状态配置服务,使用
Proxy单例、模块导出实例和普通工厂之间怎么取舍?模块导出实例通常已能利用模块缓存表达共享对象,语义比构造拦截更直接。
Proxy适合必须保留new调用形式且要统一拦截构造的场景,普通工厂则更利于控制生命周期和测试;额外代理层会增加理解与调试成本。
# 14 实现Ajax
⚡ 30 秒速记
- 原生实现
Ajax的基本流程,是创建XMLHttpRequest、发出HTTP请求,并在响应返回后解析数据和更新局部页面。 - 早期服务器常返回
XML字符串,因此名称里保留了XML;现在实际使用中通常处理JSON。 - 手写一个最简单的
GET请求时,重点是完成实例创建、请求发送和响应处理。 - 这里只描述基础流程,具体页面更新仍要根据返回数据单独实现。
原生实现 Ajax 的基本流程,是创建 XMLHttpRequest、发出 HTTP 请求,并在响应返回后解析数据和更新局部页面。 早期服务器常返回 XML 字符串,因此名称里保留了 XML;现在实际使用中通常处理 JSON。手写一个最简单的 GET 请求时,重点是完成实例创建、请求发送和响应处理。这里只描述基础流程,具体页面更新仍要根据返回数据单独实现。
步骤
- 创建
XMLHttpRequest实例 - 发出 HTTP 请求
- 服务器返回 XML 格式的字符串
- JS 解析 XML,并更新局部页面
- 不过随着历史进程的推进,XML 已经被淘汰,取而代之的是 JSON。
了解了属性和方法之后,根据 AJAX 的步骤,手写最简单的 GET 请求。
# 1 原生实现
⚡ 30 秒速记
- 原生
Ajax可以通过XMLHttpRequest完成:先用open配置GET请求,再监听readyState并调用send发出请求。 - 当
readyState等于4,说明请求已经结束,此时还要判断status是否处于200到300之间。 - 请求成功后读取
responseText,再用JSON.parse把字符串转换成JavaScript值或对象。 - 这个示例只覆盖无参数的
GET请求,其他请求形式还需要补充相应配置。
原生 Ajax 可以通过 XMLHttpRequest 完成:先用 open 配置 GET 请求,再监听 readyState 并调用 send 发出请求。 当 readyState 等于 4,说明请求已经结束,此时还要判断 status 是否处于 200 到 300 之间。请求成功后读取 responseText,再用 JSON.parse 把字符串转换成 JavaScript 值或对象。这个示例只覆盖无参数的 GET 请求,其他请求形式还需要补充相应配置。
function ajax() {
  let xhr = new XMLHttpRequest() //实例化,以调用方法
  xhr.open('get', 'https://www.google.com')  //参数2,url。参数三:异步
  xhr.onreadystatechange = () => {  //每当 readyState 属性改变时,就会调用该函数。
    if (xhr.readyState === 4) {  //XMLHttpRequest 代理当前所处状态。
      if (xhr.status >= 200 && xhr.status < 300) {  //200-300请求成功
        let string = request.responseText
        //JSON.parse() 方法用来解析JSON字符串,构造由字符串描述的JavaScript值或对象
        let object = JSON.parse(string)
      }
    }
  }
  request.send() //用于实际发出 HTTP 请求。不带参数为GET请求
}
💬 面试官追问
搜索页调用这段原生
ajax后,Network显示请求成功,但控制台报request is not defined,页面始终没有数据,你会先改哪里?请求对象声明为
xhr,读取响应和发送请求却使用了未定义的request,应分别改成xhr.responseText与xhr.send()。这属于变量引用错误,请求甚至可能尚未发出;修复后还要确认解析结果被返回、回调或写入页面状态。商品列表接口返回
204、304或格式错误的响应体时,这段代码会出现什么现象,生产实现应怎样处理?当前判断会把部分无响应体的成功状态交给
JSON.parse,从而同步抛出异常;304是否可用还取决于缓存和调用方式,不能简单并入成功区间。应先依据状态码和响应头判断是否需要解析,再捕获解析错误并交给统一失败分支。运营后台一次触发 20 个原生
XMLHttpRequest,其中部分接口超时或断网,但页面只一直显示加载中,你会补哪些故障出口?仅监听
readystatechange且只处理成功状态,会让网络错误、超时和非成功状态没有收口。应补充onerror、ontimeout、onabort及HTTP失败处理,并确保每条路径都结束加载态;超时时间和提示文案仍需按业务容忍度确定。同一封装要支持提交表单,调用方要求发送
POST和JSON请求体,现有ajax()的接口应怎样调整?应把
method、url、请求头和请求体变为参数,在open后按需调用setRequestHeader,最后将请求体传给send。GET参数应编码进URL,JSON请求体需要序列化并声明合适的Content-Type;服务端协议不明确时不能擅自固定格式。安全负责人要求跨域请求带登录凭证,前端同学却想直接把示例
URL换成业务域名,这个原生实现还受什么约束?跨域能否读取响应由服务端的
CORS响应决定,单纯更换URL不能绕过同源策略。若需携带凭证,还要设置相应凭证选项并由服务端精确允许来源与凭证;开放配置不当会带来安全风险,前端无法单方面修复。
# 2 Promise实现
⚡ 30 秒速记
- 基于
Promise封装Ajax,本质上是把XMLHttpRequest的回调结果转换成成功或失败状态。 - 创建请求对象后调用
open建立请求配置,通过onreadystatechange等待readyState变为4。 - 此时状态码在
200到300之间就解析响应并执行resolve,否则执行reject,最后用send发出请求。 - 这个示例适合封装简单的
GET请求,但响应不一定都是合法JSON,解析失败也要考虑异常处理。
基于 Promise 封装 Ajax,本质上是把 XMLHttpRequest 的回调结果转换成成功或失败状态。 创建请求对象后调用 open 建立请求配置,通过 onreadystatechange 等待 readyState 变为 4。此时状态码在 200 到 300 之间就解析响应并执行 resolve,否则执行 reject,最后用 send 发出请求。这个示例适合封装简单的 GET 请求,但响应不一定都是合法 JSON,解析失败也要考虑异常处理。
基于Promise封装Ajax
- 返回一个新的
Promise实例 - 创建
HMLHttpRequest异步对象 - 调用
open方法,打开url,与服务器建立链接(发送前的一些处理) - 监听
Ajax状态信息 - 如果
xhr.readyState == 4(表示服务器响应完成,可以获取使用服务器的响应了)xhr.status == 200,返回resolve状态xhr.status == 404,返回reject状态
xhr.readyState !== 4,把请求主体的信息基于send发送给服务器
function ajax(url) {
  return new Promise((resolve, reject) => {
    let xhr = new XMLHttpRequest()
    xhr.open('get', url)
    xhr.onreadystatechange = () => {
      if (xhr.readyState == 4) {
        if (xhr.status >= 200 && xhr.status <= 300) {
          resolve(JSON.parse(xhr.responseText))
        } else {
          reject('请求出错')
        }
      }
    }
    xhr.send()  //发送hppt请求
  })
}

let url = '/data.json'
ajax(url).then(res => console.log(res))
  .catch(reason => console.log(reason))
💬 面试官追问
详情页接口返回
300或204时,这个Promise封装会怎样结算,为什么status <= 300仍不够严谨?代码会把
300当作成功,并立即对响应文本执行JSON.parse;204没有响应体时则可能解析失败。成功范围通常按具体协议判断,解析也应考虑空响应和非JSON内容,不能仅凭一个宽泛状态区间决定resolve。支付页请求遇到断网,
readyState最终变化但没有可用响应,调用方的.catch是否一定执行,你会怎样补齐?当前只在
readyState === 4后按状态拒绝,未显式覆盖网络错误、超时和主动取消,故障语义不完整。应绑定onerror、ontimeout、onabort,并用Error或结构化错误拒绝;各事件可能接近发生,结算与清理要保持幂等。联想搜索框每次输入都调用
ajax(url),用户快速输入 10 次后旧响应覆盖了新结果,Promise封装层怎么配合解决?Promise本身不会取消已经发出的XMLHttpRequest,应暴露取消能力或接收取消信号,并在新请求开始时中止旧请求。页面层还应记录请求序号,只接收最新结果;仅忽略旧结果可以避免错写状态,却不会节省已经发生的网络开销。接口偶尔返回
HTML错误页且状态为200,线上只看到SyntaxError,你会如何区分传输失败与业务数据解析失败?应把
JSON.parse放进明确的异常处理,并为解析失败附上状态码、URL、响应类型等诊断信息,再通过reject交给调用方。还可先检查Content-Type,但响应头只能辅助判断;日志中不应直接记录可能含敏感信息的完整响应体。团队争论继续维护
XMLHttpRequest + Promise还是改用fetch,在需要上传进度和超时控制的管理后台里你如何取舍?若必须稳定获取上传进度,保留
XMLHttpRequest更贴合现有能力;普通JSON请求可考虑fetch,但仍要自行定义HTTP非成功状态、解析和取消语义。迁移价值取决于封装一致性,不能只因fetch返回Promise就认为错误处理已经等价。
# 15 实现JSONP方法
⚡ 30 秒速记
JSONP是利用<script>标签可以跨域加载资源的特点,通过全局回调函数接收服务端返回的数据。- 实现时创建
<script>,把参数和回调名称拼到src上,再将标签插入页面触发请求。 - 服务端执行约定的回调后,用
resolve返回数据,并移除标签以免残留。 - 它只支持
GET,而且依赖服务端配合;能使用CORS时,一般不必选这种方式。
JSONP 是利用 <script> 标签可以跨域加载资源的特点,通过全局回调函数接收服务端返回的数据。 实现时创建 <script>,把参数和回调名称拼到 src 上,再将标签插入页面触发请求。服务端执行约定的回调后,用 resolve 返回数据,并移除标签以免残留。它只支持 GET,而且依赖服务端配合;能使用 CORS 时,一般不必选这种方式。
利用
<script>标签不受跨域限制的特点,缺点是只能支持get请求
- 创建
script标签 - 设置
script标签的src属性,以问号传递参数,设置好回调函数callback名称 - 插入到
html文本中 - 调用回调函数,
res参数就是获取的数据
function jsonp({url,params,callback}) {
  return new Promise((resolve,reject)=>{
  let script = document.createElement('script')

    window[callback] = function (data) {
      resolve(data)
      document.body.removeChild(script)
    }
    var arr = []
    for(var key in params) {
      arr.push(`${key}=${params[key]}`)
    }
    script.type = 'text/javascript'
    script.src = `${url}?callback=${callback}&${arr.join('&')}`
    document.body.appendChild(script)
  })
}
// 测试用例
jsonp({
  url: 'http://suggest.taobao.com/sug',
  callback: 'getData',
  params: {
    q: 'iphone手机',
    code: 'utf-8'
  },
}).then(data=>{console.log(data)})
- 设置
CORS: Access-Control-Allow-Origin:* postMessage
💬 面试官追问
地址联想页通过
JSONP请求第三方接口,服务端返回普通JSON而不是getData({...}),浏览器会出现什么代码现象?JSONP依赖响应内容主动调用约定的全局回调,普通JSON被当作脚本执行时不会把数据交给Promise,甚至可能产生语法错误。它不是对任意跨域JSON的通用读取方式,服务端必须明确支持回调参数协议。搜索词包含
iphone 手机&配件,现有参数拼接后服务端收到的q被截断,你会怎样修正URL构造?当前直接拼接键和值,空格、
&、=或中文都可能改变查询串含义,应使用URLSearchParams或对键和值分别编码。还要正确处理URL已有查询参数的情况;编码只能保证传输结构,不能替代服务端的参数校验。商品页连续发起 30 次
JSONP请求并复用回调名getData,偶发出现响应串线,你会怎样设计回调与清理?每次请求都应生成唯一且难冲突的回调名,响应完成后同时移除
script节点并删除window上的函数。复用全局名称会让后一次覆盖前一次,响应乱序时Promise可能拿到错误数据;唯一命名仍无法消除JSONP执行远端脚本的安全风险。线上第三方脚本返回
404或一直不调用回调,Promise永久处于等待状态,排查和兜底应放在哪里?应给
script.onerror设置拒绝分支,并增加业务可接受的超时定时器;无论成功、失败还是超时,都要统一移除节点、回调和定时器。onload只能说明脚本加载结束,不能证明约定回调已经执行。安全评审要求将账户页的
JSONP改成CORS,但旧接口只支持GET,架构上为什么仍值得迁移?JSONP会把第三方响应作为脚本执行,数据接口一旦被篡改就具有当前页面脚本权限,也难以提供规范的状态码和错误语义。CORS由服务端显式授权来源,并可支持更常规的请求与响应处理;迁移需要服务端配合,不能靠前端设置Access-Control-Allow-Origin。嵌入式活动页需要与父页面交换筛选结果,同事提议继续用
JSONP,你会如何比较它与postMessage?JSONP适合通过脚本加载获取一次性跨域数据,而父子窗口之间持续通信更适合postMessage。使用postMessage时必须校验origin和消息结构,并指定准确的目标源;它要求双方已有窗口引用,也不能直接替代普通HTTP数据接口。
# 16 实现async/await
⚡ 30 秒速记
- 实现
async/await的关键,是用执行器自动推进Generator,并把整个执行过程包装成一个Promise。 - 执行器调用生成器得到迭代器,再通过
step反复执行next,并用Promise.resolve接住每次yield的结果。 - 异步成功时把值传回下一次迭代,失败时调用
throw;迭代完成后,用生成器最终返回值执行resolve。 - 这种写法说明了基本原理,但实际使用时直接采用原生
async/await更合适。
实现 async/await 的关键,是用执行器自动推进 Generator,并把整个执行过程包装成一个 Promise。 执行器调用生成器得到迭代器,再通过 step 反复执行 next,并用 Promise.resolve 接住每次 yield 的结果。异步成功时把值传回下一次迭代,失败时调用 throw;迭代完成后,用生成器最终返回值执行 resolve。这种写法说明了基本原理,但实际使用时直接采用原生 async/await 更合适。
分析
// generator生成器  生成迭代器iterator

// 默认这样写的类数组是不能被迭代的,缺少迭代方法
let likeArray = {'0': 1, '1': 2, '2': 3, '3': 4, length: 4}

// // 使用迭代器使得可以展开数组
// // Symbol有很多元编程方法,可以改js本身功能
// likeArray[Symbol.iterator] = function () {
//   // 迭代器是一个对象 对象中有next方法 每次调用next 都需要返回一个对象 {value,done}
//   let index = 0
//   return {
//     next: ()=>{
//       // 会自动调用这个方法
//       console.log('index',index)
//       return {
//         // this 指向likeArray
//         value: this[index],
//         done: index++ === this.length
//       }
//     }
//   }
// }
// let arr = [...likeArray]

// console.log('arr', arr)

// 使用生成器返回迭代器
// likeArray[Symbol.iterator] = function *() {
//   let index = 0
//   while (index != this.length) {
//     yield this[index++]
//   }
// }
// let arr = [...likeArray]

// console.log('arr', arr)


// 生成器 碰到yield就会暂停
// function *read(params) {
//   yield 1;
//   yield 2;
// }
// 生成器返回的是迭代器
// let it = read()
// console.log(it.next())
// console.log(it.next())
// console.log(it.next())

// 通过generator来优化promise(promise的缺点是不停的链式调用)
const fs = require('fs')
const path = require('path')
// const co = require('co') // 帮我们执行generator

const promisify = fn=>{
  return (...args)=>{
    return new Promise((resolve,reject)=>{
      fn(...args, (err,data)=>{
        if(err) {
          reject(err)
        }
        resolve(data)
      })
    })
  }
}

// promise化
let asyncReadFile = promisify(fs.readFile)

function * read() {
  let content1 = yield asyncReadFile(path.join(__dirname,'./data/name.txt'),'utf8')
  let content2 = yield asyncReadFile(path.join(__dirname,'./data/' + content1),'utf8')
  return content2
}

// 这样写太繁琐 需要借助co来实现
// let re = read()
// let {value,done} = re.next()
// value.then(data=>{
//   // 除了第一次传参没有意义外 剩下的传参都赋予了上一次的返回值
//   let {value,done} = re.next(data)
//   value.then(d=>{
//     let {value,done} = re.next(d)
//     console.log(value,done)
//   })
// }).catch(err=>{
//   re.throw(err) // 手动抛出错误 可以被try catch捕获
// })


// 实现co原理
function co(it) {// it 迭代器
  return new Promise((resolve,reject)=>{
    // 异步迭代 需要根据函数来实现
    function next(data) {
      // 递归得有中止条件
      let {value,done} = it.next(data)
      if(done) {
        resolve(value) // 直接让promise变成成功 用当前返回的结果
      } else {
        // Promise.resolve(value).then(data=>{
        //   next(data)
        // }).catch(err=>{
        //   reject(err)
        // })
        // 简写
        Promise.resolve(value).then(next,reject)
      }
    }
    // 首次调用
    next()
  })
}

co(read()).then(d=>{
  console.log(d)
}).catch(err=>{
  console.log(err,'--')
})
整体看一下结构
function asyncToGenerator(generatorFunc) {
    return function() {
      const gen = generatorFunc.apply(this, arguments)
      return new Promise((resolve, reject) => {
        function step(key, arg) {
          let generatorResult
          try {
            generatorResult = gen[key](arg)
          } catch (error) {
            return reject(error)
          }
          const { value, done } = generatorResult
          if (done) {
            return resolve(value)
          } else {
            return Promise.resolve(value).then(val => step('next', val), err => step('throw', err))
          }
        }
        step("next")
      })
    }
}
分析
function asyncToGenerator(generatorFunc) {
  // 返回的是一个新的函数
  return function() {

    // 先调用generator函数 生成迭代器
    // 对应 var gen = testG()
    const gen = generatorFunc.apply(this, arguments)

    // 返回一个promise 因为外部是用.then的方式 或者await的方式去使用这个函数的返回值的
    // var test = asyncToGenerator(testG)
    // test().then(res => console.log(res))
    return new Promise((resolve, reject) => {

      // 内部定义一个step函数 用来一步一步的跨过yield的阻碍
      // key有next和throw两种取值,分别对应了gen的next和throw方法
      // arg参数则是用来把promise resolve出来的值交给下一个yield
      function step(key, arg) {
        let generatorResult

        // 这个方法需要包裹在try catch中
        // 如果报错了 就把promise给reject掉 外部通过.catch可以获取到错误
        try {
          generatorResult = gen[key](arg)
        } catch (error) {
          return reject(error)
        }

        // gen.next() 得到的结果是一个 { value, done } 的结构
        const { value, done } = generatorResult

        if (done) {
          // 如果已经完成了 就直接resolve这个promise
          // 这个done是在最后一次调用next后才会为true
          // 以本文的例子来说 此时的结果是 { done: true, value: 'success' }
          // 这个value也就是generator函数最后的返回值
          return resolve(value)
        } else {
          // 除了最后结束的时候外,每次调用gen.next()
          // 其实是返回 { value: Promise, done: false } 的结构,
          // 这里要注意的是Promise.resolve可以接受一个promise为参数
          // 并且这个promise参数被resolve的时候,这个then才会被调用
          return Promise.resolve(
            // 这个value对应的是yield后面的promise
            value
          ).then(
            // value这个promise被resove的时候,就会执行next
            // 并且只要done不是true的时候 就会递归的往下解开promise
            // 对应gen.next().value.then(value => {
            //    gen.next(value).value.then(value2 => {
            //       gen.next()
            //
            //      // 此时done为true了 整个promise被resolve了
            //      // 最外部的test().then(res => console.log(res))的then就开始执行了
            //    })
            // })
            function onResolve(val) {
              step("next", val)
            },
            // 如果promise被reject了 就再次进入step函数
            // 不同的是,这次的try catch中调用的是gen.throw(err)
            // 那么自然就被catch到 然后把promise给reject掉啦
            function onReject(err) {
              step("throw", err)
            },
          )
        }
      }
      step("next")
    })
  }
}
💬 面试官追问
文件读取生成器中某个
yield返回数字42而不是Promise,这个执行器为什么仍应继续,而直接调用value.then会怎样?asyncToGenerator用Promise.resolve(value)统一接收Promise、thenable和普通值,因此42会被包装后传回下一次next。直接调用value.then会在普通值上报错,这也是执行器不能假设每个yield都严格返回Promise的原因。Node工具里fs.readFile失败后,生成器内部写了try/catch想降级读取备用文件,执行器必须怎样传递错误?被
yield的Promise拒绝后,应调用gen.throw(error),让异常从对应yield位置抛回生成器,内部try/catch才有机会处理。若执行器直接reject外层Promise,就会跳过生成器自身的恢复逻辑,语义与await不一致。某个生成器函数在第一个
next()前就同步抛错,或在恢复执行时抛错,页面只看到未捕获异常,你会检查哪段代码?每次
gen.next(arg)和gen.throw(arg)都应放在try/catch中,捕获后拒绝外层Promise。只包裹首次调用不够,因为后续恢复执行也会运行生成器代码;若generatorFunc.apply本身可能抛错,也要确保它进入同一拒绝语义。团队把这个转换器用于对象方法,方法内部依赖
this.userId和调用参数,包装后却读到undefined,正确实现应保留什么?返回的新函数应通过
generatorFunc.apply(this, arguments)创建迭代器,保留调用时的上下文和参数。若改成直接调用generatorFunc(),对象方法语义会丢失;箭头函数还会固定词法this,因此包装形式也需谨慎。生成器最终
return一个尚未完成的Promise,done === true时直接resolve(value)能否得到最终值?可以,
Promise的解析过程会吸收返回的Promise或thenable,外层Promise会跟随其最终状态,而不是把它作为普通对象立即交付。风险在于恶意或异常thenable的行为较复杂,但原生Promise解析机制会负责这一层同化。评审认为这个执行器已经完整实现了原生
async/await,你会怎样限定结论?它复现了核心控制流:驱动
Generator、等待yield值,并把成功或失败送回迭代器。它仍是函数级转换辅助器,不等同于语言语法、编译器转换和运行时的全部行为;工程中通常使用原生能力或成熟编译链,而非自行维护该实现。
# 17 基于Generator函数实现async/await原理
⚡ 30 秒速记
- 基于
Generator模拟async/await,核心是等待当前yield返回的Promise完成,再继续调用迭代器的next。 - 第一次执行
next会拿到{ value, done },其中value就是当前异步任务。 - 任务成功后把结果传给下一次
next,这个值会成为上一处yield表达式的结果,如此递归直到done为true。 - 示例展示了顺序执行的主流程,但没有处理
Promise拒绝和最终返回值。
基于 Generator 模拟 async/await,核心是等待当前 yield 返回的 Promise 完成,再继续调用迭代器的 next。 第一次执行 next 会拿到 { value, done },其中 value 就是当前异步任务。任务成功后把结果传给下一次 next,这个值会成为上一处 yield 表达式的结果,如此递归直到 done 为 true。示例展示了顺序执行的主流程,但没有处理 Promise 拒绝和最终返回值。
核心:传递给我一个
Generator函数,把函数中的内容基于Iterator迭代器的特点一步步的执行
function readFile(file) {
    return new Promise(resolve => {
        setTimeout(() => {
            resolve(file);
    }, 1000);
    })
};

function asyncFunc(generator) {
    const iterator = generator(); // 接下来要执行next
  // data为第一次执行之后的返回结果,用于传给第二次执行
  const next = (data) => {
        let { value, done } = iterator.next(data); // 第二次执行,并接收第一次的请求结果 data

    if (done) return; // 执行完毕(到第三次)直接返回
    // 第一次执行next时,yield返回的 promise实例 赋值给了 value
    value.then(data => {
      next(data); // 当第一次value 执行完毕且成功时,执行下一步(并把第一次的结果传递下一步)
    });
  }
  next();
};

asyncFunc(function* () {
    // 生成器函数:控制代码一步步执行
  let data = yield readFile('a.js'); // 等这一步骤执行执行成功之后,再往下走,没执行完的时候,直接返回
  data = yield readFile(data + 'b.js');
  return data;
})
💬 面试官追问
第二次
readFile拒绝时,示例里的asyncFunc会发生什么,生成器内部写try/catch能接住吗?示例只注册了
value.then的成功回调,拒绝不会被送回迭代器,asyncFunc也没有返回可供调用方捕获的Promise。要支持生成器内的try/catch,失败分支必须调用iterator.throw(error),并继续按迭代结果推进。业务代码调用
asyncFunc(...)后希望await最终的data,但目前得到undefined,执行器接口应怎样调整?asyncFunc应返回一个新的Promise,在迭代器产生done: true时以value调用resolve,异常时调用reject。示例中的if (done) return丢弃了生成器返回值,因此只能执行流程,不能提供类似异步函数的结果语义。生成器中插入
yield 'cache-hit'表示缓存命中,现有执行器在线上报value.then is not a function,怎么修?应将每次取得的
value交给Promise.resolve(value),再在成功时调用下一次next。这样普通值、Promise和thenable都能沿同一流程处理;仅支持示例里的Promise会让执行器对生成器产出类型产生不必要限制。定时读取任务执行到第二步时,生成器代码同步抛出路径错误,为什么仅给
Promise加.catch仍可能漏报?异常发生在
iterator.next(data)恢复生成器执行的过程中,必须在调用next或throw的位置用try/catch捕获并拒绝外层Promise。只处理被yieldPromise的拒绝无法覆盖同步异常,最终会形成未捕获错误。页面关闭后要求终止两次串行读取,同事说给
asyncFunc增加一个布尔值就等于取消,你如何判断?布尔值只能阻止执行器继续调用下一次
next,不能自动终止已经启动的readFile或其他底层任务。真正取消需要底层操作提供取消能力并向下传递信号;否则只能忽略后续结果,同时仍承担已启动任务的资源消耗。面试现场有人说
Generator就是async/await,结合这段递归执行代码你会追问两者真正的连接点是什么?Generator只提供可暂停、可恢复的迭代器,yield后何时继续由外部执行器决定;示例中的next(data)才负责把异步结果送回暂停点。async/await的核心效果可由这种执行器模拟,但错误传播、返回Promise和普通值吸收等语义仍需额外实现。
# 18 实现ES6的const
⚡ 30 秒速记
- 在
ES5中无法百分之百实现const,只能借助对象属性模拟不可重新赋值的效果。 - 可以把变量挂到
window或自定义对象上,再用Object.defineProperty定义get和set,当新值与原值不同时抛出TypeError。 - 同时设置
configurable: false和enumerable: false,分别模拟不可删除与不出现在全局枚举中的行为。 - 这个方案本质上没有块级作用域,因此只能模拟部分特性;类似的属性劫持思路也用于
Vue的双向绑定。
在 ES5 中无法百分之百实现 const,只能借助对象属性模拟不可重新赋值的效果。 可以把变量挂到 window 或自定义对象上,再用 Object.defineProperty 定义 get 和 set,当新值与原值不同时抛出 TypeError。同时设置 configurable: false 和 enumerable: false,分别模拟不可删除与不出现在全局枚举中的行为。这个方案本质上没有块级作用域,因此只能模拟部分特性;类似的属性劫持思路也用于 Vue 的双向绑定。
由于ES5环境没有
block的概念,所以是无法百分百实现const,只能是挂载到某个对象下,要么是全局的window,要么就是自定义一个object来当容器
var __const = function __const (data, value) {
    window.data = value // 把要定义的data挂载到window下,并赋值value
    Object.defineProperty(window, data, { // 利用Object.defineProperty的能力劫持当前对象,并修改其属性描述符
      enumerable: false,
      configurable: false,
      get: function () {
        return value
      },
      set: function (data) {
        if (data !== value) { // 当要对当前属性进行赋值时,则抛出错误!
          throw new TypeError('Assignment to constant variable.')
        } else {
          return value
        }
      }
    })
  }
  __const('a', 10)
  console.log(a)
  delete a
  console.log(a)
  for (let item in window) { // 因为const定义的属性在global下也是不存在的,所以用到了enumerable: false来模拟这一功能
    if (item === 'a') { // 因为不可枚举,所以不执行
      console.log(window[item])
    }
  }
  a = 20 // 报错
Vue目前双向绑定的核心实现思路就是利用Object.defineProperty对get跟set进行劫持,监听用户对属性进行调用以及赋值时的具体情况,从而实现的双向绑定
💬 面试官追问
你把配置页的
API_HOST用__const('API_HOST', url)挂到window,随后业务代码再次赋相同字符串却没有报错;这还能算const语义吗?不能,原生
const禁止任何再次赋值,不会因为新旧值相等就放行。示例中的setter仅在data !== value时抛错,因此只是阻止值发生变化;若要逼近只读属性,应让每次写入都抛出TypeError,但仍无法补出块级作用域。一个旧版管理后台需要在
window上暴露只读构建号,同时不能被for...in枚举或被delete删除,你会怎样落地并验证?可用
Object.defineProperty(window, key, { enumerable: false, configurable: false, get, set })建立访问器属性,并在setter中拒绝赋值。验证应覆盖读取、枚举、删除和重新定义;它只保护该对象上的属性,不等同于词法环境中的const。如果同一套
__const要给两个微前端分别保存名为config的常量,而它们共享一个页面级window,现有实现会出现什么冲突?两个应用都会操作
window.config,后注册者可能因属性已不可配置而定义失败,也可能提前覆盖初始化值。应把容器作为参数传入并为应用隔离命名空间;即使如此,得到的仍是对象属性约束,无法模拟各模块独立的块级绑定。线上监控显示调用
__const('token', value)后偶发出现初始化值与读取值不一致,你看到实现先执行window.data = value,会先查哪里?应先检查这里是否误把属性名写成了字面量
data;动态键必须使用window[data],而后续defineProperty(window, data, ...)操作的才是传入名称。还要检查目标属性是否已经不可配置,因为此时重新定义会直接失败,不能靠后续访问器补救。安全评审要求“变量只读且仅在函数块内可见”,团队有人坚持继续完善
Object.defineProperty方案,你会如何做选型?应直接使用原生
const或构建工具转译后的词法绑定,不能承诺用ES5属性描述符完整实现。Object.defineProperty适合为指定容器提供不可枚举、不可配置的只读入口,但会污染容器,也没有暂时性死区和块级作用域语义。
# 19 实现一个迭代器生成函数
⚡ 30 秒速记
- 实现迭代器生成函数时,需要先理解
ES6对迭代器的实现方式。 - 这一部分关注的是迭代器在
ES6中如何工作,以及生成函数应当产出什么形式的迭代器对象。 - 弄清这套机制后,再实现具体函数会更自然,也能避免只记住代码写法却不了解调用过程。
- 这里的重点是
ES6迭代器实现,暂不额外扩展其他遍历方案。
实现迭代器生成函数时,需要先理解 ES6 对迭代器的实现方式。 这一部分关注的是迭代器在 ES6 中如何工作,以及生成函数应当产出什么形式的迭代器对象。弄清这套机制后,再实现具体函数会更自然,也能避免只记住代码写法却不了解调用过程。这里的重点是 ES6 迭代器实现,暂不额外扩展其他遍历方案。
# 1 ES6对迭代器的实现
⚡ 30 秒速记
ES6通过Symbol.iterator和next方法,为不同数据结构提供了一套统一的迭代接口。- 数据结构只要具备
Symbol.iterator,就能生成迭代器对象,反复调用next()会依次得到包含value和done的结果。 for...of本质上就是持续执行这个过程,因此可以统一遍历数组、Map、Set、字符串等原生结构。- 需要注意,普通对象并不在原文列出的原生可迭代结构中,不能仅凭它是集合类型就直接使用
for...of。
ES6 通过 Symbol.iterator 和 next 方法,为不同数据结构提供了一套统一的迭代接口。 数据结构只要具备 Symbol.iterator,就能生成迭代器对象,反复调用 next() 会依次得到包含 value 和 done 的结果。for...of 本质上就是持续执行这个过程,因此可以统一遍历数组、Map、Set、字符串等原生结构。需要注意,普通对象并不在原文列出的原生可迭代结构中,不能仅凭它是集合类型就直接使用 for...of。
JS原生的集合类型数据结构,只有Array(数组)和Object(对象);而ES6中,又新增了Map和Set。四种数据结构各自有着自己特别的内部实现,但我们仍期待以同样的一套规则去遍历它们,所以ES6在推出新数据结构的同时也推出了一套统一的接口机制——迭代器(Iterator)。
ES6约定,任何数据结构只要具备Symbol.iterator属性(这个属性就是Iterator的具体实现,它本质上是当前数据结构默认的迭代器生成函数),就可以被遍历——准确地说,是被for...of...循环和迭代器的next方法遍历。 事实上,for...of...的背后正是对next方法的反复调用。
在ES6中,针对Array、Map、Set、String、TypedArray、函数的 arguments 对象、NodeList 对象这些原生的数据结构都可以通过for...of...进行遍历。原理都是一样的,此处我们拿最简单的数组进行举例,当我们用for...of...遍历数组时:
const arr = [1, 2, 3]
const len = arr.length
for(item of arr) {
   console.log(`当前元素是${item}`)
}
之所以能够按顺序一次一次地拿到数组里的每一个成员,是因为我们借助数组的
Symbol.iterator生成了它对应的迭代器对象,通过反复调用迭代器对象的next方法访问了数组成员,像这样:
const arr = [1, 2, 3]
// 通过调用iterator,拿到迭代器对象
const iterator = arr[Symbol.iterator]()

// 对迭代器对象执行next,就能逐个访问集合的成员
iterator.next()
iterator.next()
iterator.next()
丢进控制台,我们可以看到next每次会按顺序帮我们访问一个集合成员:
而
for...of...做的事情,基本等价于下面这通操作:
// 通过调用iterator,拿到迭代器对象
const iterator = arr[Symbol.iterator]()

// 初始化一个迭代结果
let now = { done: false }

// 循环往外迭代成员
while(!now.done) {
    now = iterator.next()
    if(!now.done) {
        console.log(`现在遍历到了${now.value}`)
    }
}
可以看出,
for...of...其实就是iterator循环调用换了种写法。在ES6中我们之所以能够开心地用for...of...遍历各种各种的集合,全靠迭代器模式在背后给力。
ps:此处推荐阅读迭代协议 (opens new window),相信大家读过后会对迭代器在ES6中的实现有更深的理解。
💬 面试官追问
日志页把一个普通对象
records直接放进for...of,浏览器提示它不可迭代;同事说“对象也属于集合,应该天然支持”,你怎么解释?for...of依赖对象上的Symbol.iterator,普通对象默认没有这项迭代接口,因此不能仅凭“能存数据”就参与遍历。数组、Map、Set、字符串等原生结构已提供默认实现;普通对象应明确转换键值列表或自行定义迭代顺序。数据看板要依次消费一个包含一万条记录的数组,又不希望业务层管理索引,你会怎样把迭代协议接入页面逻辑?
直接使用数组已有的
Symbol.iterator,由for...of持续调用迭代器的next(),直到结果中的done为true。业务层只处理每次返回的value;这种方式统一了访问接口,但并不会自动改变一次遍历的总工作量。组件库原来只接收数组,现在产品要求同时接收
Set、字符串和NodeList,还能继续读取length与数字下标吗?不能把这些输入统一假设为数组下标模型,应面向可迭代协议读取
input[Symbol.iterator](),再消费其next()结果。这样可覆盖原生可迭代结构;若输入缺少Symbol.iterator,组件仍需明确拒绝或先转换,不能静默猜测顺序。线上列表少渲染了最后一条,排查时发现循环先判断旧的
now.done,调用next()后不再检查便直接退出,你会怎样定位?应记录每次
next()返回的{ value, done },确认渲染动作只在本次结果的done为false时执行。规范循环应先取得新结果,再依据新结果判断;若混用上一次状态,容易漏项或把结束时的undefined当成数据。基础库评审时,一方主张所有集合先转数组,另一方主张统一消费迭代器;对于
Map、Set和NodeList的公共遍历层你选哪种?只需顺序消费时应优先面向迭代器,它正是这些结构共享的统一接口,也避免把业务绑定到数组下标。若后续确实需要随机访问或多次复用,再显式转数组;转换会创建额外容器,并可能丢失原结构所表达的访问语义。
候选人说“迭代器就是
for...of的语法别名”,但调试器里你能手动连续调用iterator.next(),两者关系该怎样界定?迭代器是提供
next()的对象,for...of是消费可迭代对象的一种语法机制,两者不是同一个概念。for...of会通过Symbol.iterator取得迭代器并反复取值;手动调用则允许调用方自行控制推进时机和结束判断。
# 2 实现迭代器生成函数
⚡ 30 秒速记
- 迭代器生成函数的核心,是返回一个带有
next方法、并能记住当前遍历位置的对象。 - 在
ES6中可以用Generator和yield直接生成迭代器;如果用ES5手写,则通过闭包保存索引idx和集合长度len。 - 每次调用
next(),未越界时返回当前值并推进索引,结束后返回{ done: true, value: undefined }。 - 这种写法适合数组这类具有
length和索引访问能力的集合,不能直接覆盖所有数据结构。
迭代器生成函数的核心,是返回一个带有 next 方法、并能记住当前遍历位置的对象。 在 ES6 中可以用 Generator 和 yield 直接生成迭代器;如果用 ES5 手写,则通过闭包保存索引 idx 和集合长度 len。每次调用 next(),未越界时返回当前值并推进索引,结束后返回 { done: true, value: undefined }。这种写法适合数组这类具有 length 和索引访问能力的集合,不能直接覆盖所有数据结构。
我们说迭代器对象全凭迭代器生成函数帮我们生成。在ES6中,实现一个迭代器生成函数并不是什么难事儿,因为ES6早帮我们考虑好了全套的解决方案,内置了贴心的生成器(Generator)供我们使用:
// 编写一个迭代器生成函数
function *iteratorGenerator() {
    yield '1号选手'
    yield '2号选手'
    yield '3号选手'
}

const iterator = iteratorGenerator()

iterator.next()
iterator.next()
iterator.next()
丢进控制台,不负众望:
写一个生成器函数并没有什么难度,但在面试的过程中,面试官往往对生成器这种语法糖背后的实现逻辑更感兴趣。下面我们要做的,不仅仅是写一个迭代器对象,而是用ES5去写一个能够生成迭代器对象的迭代器生成函数(解析在注释里):
// 定义生成器函数,入参是任意集合
function iteratorGenerator(list) {
    // idx记录当前访问的索引
    var idx = 0
    // len记录传入集合的长度
    var len = list.length
    return {
        // 自定义next方法
        next: function() {
            // 如果索引还没有超出集合长度,done为false
            var done = idx >= len
            // 如果done为false,则可以继续取值
            var value = !done ? list[idx++] : undefined

            // 将当前值与遍历是否完毕(done)返回
            return {
                done: done,
                value: value
            }
        }
    }
}

var iterator = iteratorGenerator(['1号选手', '2号选手', '3号选手'])
iterator.next()
iterator.next()
iterator.next()
此处为了记录每次遍历的位置,我们实现了一个闭包,借助自由变量来做我们的迭代过程中的“游标”。
运行一下我们自定义的迭代器,结果符合预期:
💬 面试官追问
搜索建议组件连续调用自定义迭代器四次,前三次有值,第四次得到
{ done: true, value: undefined };有人认为第四次应该抛异常,你同意吗?不同意,示例迭代器以
done: true表示序列已经耗尽,并将value置为undefined,这正是调用方停止消费的信号。继续调用通常仍应保持完成态;若改为抛错,会破坏按done驱动的常规消费循环。一个
ES5页面要分页展示三百个数组元素,你会如何让“下一条”按钮复用同一个游标,而不是每次从头扫描?让
iteratorGenerator(list)返回含next()的对象,并用闭包变量idx保存当前位置;每次点击只调用同一个迭代器实例的next()。游标不会暴露给页面代码,但该实现依赖输入的length和数字下标,不能直接泛化为任意集合。产品把输入从数组换成实时增长的任务队列,迭代过程中还会追加数据;示例在创建时缓存
len,新任务会不会被读到?不会,
len在生成迭代器时已固定,后续追加到原列表尾部的成员不会进入本轮遍历范围。若需求是观察动态长度,可在每次next()时读取list.length;代价是遍历边界受并发修改影响,必须先定义追加和删除的语义。线上轮播偶发重复第一张图,日志显示每次点击都会重新执行
iteratorGenerator(images);你会怎样修复并验证?每次重新生成都会创建新的闭包并把
idx重置为0,因此重复首项是预期现象。应在轮播生命周期内保存同一个迭代器,只在数据源整体替换时重建;同时记录连续返回值,验证结束后稳定得到done: true。代码评审中,一方要求用
function*和yield,另一方要求兼容仅支持ES5语法的嵌入页;你如何决定?现代
ES6环境可用生成器直接表达暂停与继续,代码更贴近意图;仅支持ES5的页面则可采用闭包加next()的手写状态机。后者只覆盖当前顺序取值场景,不应宣称完整复刻生成器的全部控制能力。两个列表组件拿到同一个数组,各自调用
iteratorGenerator后交替执行next(),它们的游标会互相干扰吗?不会,每次调用都会创建独立的
idx闭包,因此两个迭代器可在同一数据源上分别推进。若两个组件共享的是同一个迭代器对象,游标才会共同消耗;这也说明可迭代数据源与一次具体迭代过程需要区分。
# 20 实现ES6的extends
⚡ 30 秒速记
- 这段实现通过连接构造函数的原型、调用父构造函数并补充子类属性,模拟了
ES6的extends。 Object.setPrototypeOf(A, B)让A指向B,再通过Object.getPrototypeOf(A).call(this, name)以当前实例为this调用B,效果类似super。- 最后设置
age并返回当前实例,得到同时包含父类和子类实例属性的对象。
这段实现通过连接构造函数的原型、调用父构造函数并补充子类属性,模拟了 ES6 的 extends。 Object.setPrototypeOf(A, B) 让 A 指向 B,再通过 Object.getPrototypeOf(A).call(this, name) 以当前实例为 this 调用 B,效果类似 super。最后设置 age 并返回当前实例,得到同时包含父类和子类实例属性的对象。
function B(name){
  this.name = name;
};
function A(name,age){
  //1.将A的原型指向B
  Object.setPrototypeOf(A,B);
  //2.用A的实例作为this调用B,得到继承B之后的实例,这一步相当于调用super
  Object.getPrototypeOf(A).call(this, name)
  //3.将A原有的属性添加到新实例上
  this.age = age;
  //4.返回新实例对象
  return this;
};
var a = new A('poetry',22);
console.log(a);
💬 面试官追问
你运行示例后发现
new A('poetry', 22)有name和age,但给B.prototype增加sayName后,a.sayName仍是undefined;为什么?示例只用
Object.setPrototypeOf(A, B)建立了构造函数之间的原型关系,并借助父构造函数给实例写入name。它没有把A.prototype接到B.prototype,所以A的实例无法沿实例原型链找到sayName。后台用户模型中,
B负责写入name,A额外写入age;在不使用class的前提下,构造阶段怎样避免复制父构造逻辑?可先建立
A与B的构造函数继承关系,再通过Object.getPrototypeOf(A).call(this, name)以当前实例为上下文调用父构造函数。随后由A写入age;这只完成实例字段初始化,实例方法继承仍需单独建立原型链。插件系统允许运行时把
A的父构造函数从B换成另一个构造函数,而代码仍把B.call(this)写死;示例写法为何更适合这个约束?示例通过
Object.getPrototypeOf(A)查找当前父构造函数,再用call(this, name)执行,因此不会把调用目标固定为变量B。但动态替换父级会改变初始化契约,新的父构造函数若参数或副作用不同,子构造逻辑仍可能失效。线上报错显示
Object.getPrototypeOf(A).call is not a function,故障发生在热更新修改继承关系之后,你会优先检查什么?先检查
A的直接原型是否仍是可调用的父构造函数,以及热更新是否把它改成了普通对象或null。再确认Object.setPrototypeOf(A, B)是否在实例化前执行;这种关系若在每次构造时反复设置,也会让初始化路径更难排查。架构评审中有人说“只要实例字段正确,
extends就实现完了”,你会用哪些可观察行为反驳?应同时检查构造函数继承和实例原型继承:
A能否沿构造函数原型访问父级能力,以及new A()能否访问B.prototype上的方法。当前示例主要展示前者和父构造调用,缺少后者,因此只能视为对extends核心步骤的局部模拟。
# 21 实现Object.create
⚡ 30 秒速记
- 实现
Object.create的关键,是让新对象的__proto__指向传入的proto。 - 可以声明一个空构造函数
F,把F.prototype设置为proto,然后通过new F()创建对象。 - 这样不会直接修改原对象,新对象访问自身不存在的属性时,可以沿原型链从
proto上查找。
实现 Object.create 的关键,是让新对象的 __proto__ 指向传入的 proto。 可以声明一个空构造函数 F,把 F.prototype 设置为 proto,然后通过 new F() 创建对象。这样不会直接修改原对象,新对象访问自身不存在的属性时,可以沿原型链从 proto 上查找。
Object.create()方法创建一个新对象,使用现有的对象来提供新创建的对象的__proto__
// 模拟 Object.create

function create(proto) {
  function F() {}
  F.prototype = proto;

  return new F();
}
💬 面试官追问
权限页执行
const child = create(parent)后,child.role能读到父对象的值,但child自身没有role;同事判断复制失败,你怎么回应?这不是复制失败,
create的目标是让新对象以parent作为原型,属性读取会沿原型链找到role。可用自身属性检查与原型检查区分来源;修改继承来的可写属性时,通常会在子对象上形成遮蔽,而不是复制整份父对象。旧浏览器工具库只需根据一个配置原型创建轻量对象,你会怎样用
ES5代码实现并验证原型关系?可创建空构造函数
F,令F.prototype = proto,再返回new F(),从而让结果对象的原型指向传入对象。验证时应检查继承属性可读且不属于结果对象自身;该简化实现只覆盖单个原型参数。测试框架要求
create(null)生成没有普通对象原型方法的字典,现有new F()方案能可靠满足吗?不能把它视为完整支持,
F.prototype = null后通过new F()创建对象时,实际原型行为不能简单等同于原生Object.create(null)。若必须构造无原型字典,应使用原生Object.create(null);手写版本需明确其能力边界。线上字典调用
create(42)后仍生成了对象,而调用方原本期待立即拒绝非法原型;你会怎样补故障防线?应在创建前校验
proto是否为对象或null,其他类型直接抛出类型错误,避免把无效输入悄悄交给构造过程。示例省略了参数校验,因此只能用于受控输入;补校验后还要覆盖函数对象、普通对象和null。组件库需要创建对象时一次性附加带
getter、枚举性和只读约束的属性,团队想继续扩展这个十行create,你会如何选型?应优先使用原生
Object.create(proto, propertiesObject),因为简化实现只设置原型,没有处理属性描述符参数。自行补齐描述符校验和定义规则会扩大兼容风险;若运行环境只要求单参数能力,才保留该实现作为原理展示。调试面板里有人把
Object.create(proto)解释为执行一次proto的构造函数,导致他在原型对象里寻找初始化副作用;你怎么纠正?这里不会把
proto当构造函数执行,而是借助临时构造函数把它放到新对象的原型链上。new F()执行的是空函数F,因此不会自动复制或初始化proto的状态;需要实例字段时仍要显式赋值或调用相应初始化逻辑。
# 22 实现Object.freeze
⚡ 30 秒速记
- 这段
myFreeze先封闭对象,再把自有属性设为只读,并递归冻结其中的对象属性。 Object.seal会阻止继续添加或删除属性,随后通过Object.defineProperty将遍历到的自有属性设置为writable: false。- 因为属性值仍可能是对象,所以还要递归调用
myFreeze,否则只能冻结最外层。
这段 myFreeze 先封闭对象,再把自有属性设为只读,并递归冻结其中的对象属性。 Object.seal 会阻止继续添加或删除属性,随后通过 Object.defineProperty 将遍历到的自有属性设置为 writable: false。因为属性值仍可能是对象,所以还要递归调用 myFreeze,否则只能冻结最外层。
Object.freeze冻结一个对象,让其不能再添加/删除属性,也不能修改该对象已有属性的可枚举性、可配置可写性,也不能修改已有属性的值和它的原型属性,最后返回一个和传入参数相同的对象
function myFreeze(obj){
  // 判断参数是否为Object类型,如果是就封闭对象,循环遍历对象。去掉原型属性,将其writable特性设置为false
  if(obj instanceof Object){
    Object.seal(obj);  // 封闭对象
    for(let key in obj){
      if(obj.hasOwnProperty(key)){
        Object.defineProperty(obj,key,{
          writable:false   // 设置只读
        })
        // 如果属性值依然为对象,要通过递归来进行进一步的冻结
        myFreeze(obj[key]);
      }
    }
  }
}
💬 面试官追问
商品详情页把
product冻结后,product.price = 99失败了,但product.seller.name = 'X'仍然生效;这说明原生Object.freeze和当前递归实现有什么差别?原生
Object.freeze只冻结传入对象自身,不会自动冻结其嵌套对象,因此修改seller.name仍可能成功。当前实现递归调用myFreeze(obj[key]),实际提供的是深冻结语义,已经超出原生API;若要对齐原生行为,应移除递归。配置中心准备使用这段代码冻结共享配置,但对象含不可枚举属性和
Symbol键;仅用for...in遍历会留下什么漏洞,怎么补?for...in只覆盖可枚举字符串属性,无法处理不可枚举属性和Symbol键,这些自有属性可能仍保持可写。应使用Reflect.ownKeys(obj)获取全部自有键,再检查并修改属性描述符;同时保留访问器属性的原有get、set语义。状态树中存在
node.parent = node的循环引用,递归版myFreeze上线后出现栈溢出;你会怎样修改,又如何避免重复遍历共享子对象?递归前应使用
WeakSet记录已访问对象,命中记录时直接返回,从而同时处理循环引用和共享引用。还要先判断值是否为非空对象或函数;代价是实现成为自定义深冻结工具,不能再宣称完全等价于原生Object.freeze。某模块传入
Object.create(null)创建的字典,当前代码因instanceof Object未进入冻结流程;这里为什么不可靠,输入判断应怎样写?Object.create(null)没有Object.prototype原型,因此可能无法通过instanceof Object,但它仍是可冻结对象。可判断obj !== null && (typeof obj === 'object' || typeof obj === 'function');若目标是复刻原生行为,还需明确原始值的返回或兼容策略。线上只读配置被改写后没有报错,排查发现代码运行在非严格模式;你如何确认对象是否真的冻结,并解释“赋值没报错”与冻结失效的区别?
先用
Object.isFrozen(obj)检查目标层级,再读取Object.getOwnPropertyDescriptor确认数据属性的writable和configurable。非严格模式下,对冻结属性赋值可能静默失败,而严格模式通常会抛出异常;应继续核对最终值,不能只依赖是否报错。
# 23 实现Object.is
⚡ 30 秒速记
- 实现
Object.is时,可以先按===比较,再单独处理+0、-0和NaN。 - 两个值严格相等时,普通值直接成立;如果值为
0,则用1 / x === 1 / y区分正负零。 - 严格不相等时,只需利用
NaN不等于自身的特点,判断x !== x && y !== y,从而让两个NaN返回true。
实现 Object.is 时,可以先按 === 比较,再单独处理 +0、-0 和 NaN。 两个值严格相等时,普通值直接成立;如果值为 0,则用 1 / x === 1 / y 区分正负零。严格不相等时,只需利用 NaN 不等于自身的特点,判断 x !== x && y !== y,从而让两个 NaN 返回 true。
Object.is不会转换被比较的两个值的类型,这点和===更为相似,他们之间也存在一些区别
NaN在===中是不相等的,而在Object.is中是相等的+0和-0在===中是相等的,而在Object.is中是不相等的
Object.is = function (x, y) {
  if (x === y) {
    // 当前情况下,只有一种情况是特殊的,即 +0 -0
    // 如果 x !== 0,则返回true
    // 如果 x === 0,则需要判断+0和-0,则可以直接使用 1/+0 === Infinity 和 1/-0 === -Infinity来进行判断
    return x !== 0 || 1 / x === 1 / y;
  }

  // x !== y 的情况下,只需要判断是否为NaN,如果x!==x,则说明x是NaN,同理y也一样
  // x和y同时为NaN时,返回true
  return x !== x && y !== y;
};
💬 面试官追问
图表组件用比较结果判断是否重绘:数据从
+0变成-0时===不触发,而连续两次得到NaN时又反复触发;Object.is会怎样改变这两个现象?Object.is(+0, -0)为false,因此符号零变化会被识别;Object.is(NaN, NaN)为true,连续的NaN会被视为相同。其余多数值与===一致,并且不会进行类型转换,所以1与'1'仍不相等。代码评审中有人把实现简化成
x === y || (x !== x && y !== y);支付计算里可能出现+0和-0,这段简化为什么不合格?该表达式虽然补上了
NaN,却仍把+0与-0判为相等,未覆盖Object.is的另一项特殊语义。应在x === y分支中用x !== 0 || 1 / x === 1 / y区分符号零,再单独处理双方均为NaN。一个缓存层把
Object.is当作键相等规则,传入两个字段完全一致但分别创建的对象;为什么仍然缓存未命中,是否应该改成深比较?Object.is对对象比较引用身份,不会递归比较字段,因此两个独立创建的同形对象仍不相等。是否改用深比较取决于缓存键契约;深比较会引入循环引用、属性范围和额外遍历成本,更稳妥的做法通常是生成稳定的业务键。兼容旧环境时团队准备直接执行
Object.is = function...,但宿主已提供原生实现;你会怎样落地这个补丁,避免覆盖标准能力?应先检测
typeof Object.is !== 'function',仅在缺失时安装polyfill,避免覆盖宿主实现或其他补丁。若库代码不应修改全局对象,可导出独立的sameValue函数;直接写全局还可能受到属性权限和加载顺序影响。监控系统显示比较函数偶发返回异常结果,输入包含
0、-0、NaN、对象和字符串;你会设计哪组最小对照用例定位分支错误?至少对照
Object.is(0, -0)、Object.is(NaN, NaN)、同一对象引用、两个不同对象以及Object.is(1, '1')。再分别覆盖x === y和x !== y两条路径;若符号零失败就检查倒数比较,若NaN失败则检查自反性判断。
# 24 实现一个compose函数
⚡ 30 秒速记
compose用来组合多个函数,并按照从右到左的顺序依次执行。- 实现时可以用
reduce把当前函数包在下一个函数外层,使compose(f, g, h)返回的函数等价于(...args) => f(g(h(...args)))。 - 没有传函数时应返回恒等函数,只传一个时直接返回该函数。
- 若想改成从左到右的数据流,可以调整归并方向或交换函数的包裹位置。
compose 用来组合多个函数,并按照从右到左的顺序依次执行。 实现时可以用 reduce 把当前函数包在下一个函数外层,使 compose(f, g, h) 返回的函数等价于 (...args) => f(g(h(...args)))。没有传函数时应返回恒等函数,只传一个时直接返回该函数。若想改成从左到右的数据流,可以调整归并方向或交换函数的包裹位置。
组合多个函数,从右到左,比如:
compose(f, g, h)最终得到这个结果(...args) => f(g(h(...args))).
题目描述:实现一个 compose 函数
// 用法如下:
function fn1(x) {
  return x + 1;
}
function fn2(x) {
  return x + 2;
}
function fn3(x) {
  return x + 3;
}
function fn4(x) {
  return x + 4;
}
const a = compose(fn1, fn2, fn3, fn4);
console.log(a(1)); // 1+4+3+2+1=11
实现代码如下
function compose(...funcs) {
  if (!funcs.length) return (v) => v;

  if (funcs.length === 1) {
    return funcs[0]
  }

  return funcs.reduce((a, b) => {
    return (...args) => a(b(...args)))
  }
}
compose创建了一个从右向左执行的数据流。如果要实现从左到右的数据流,可以直接更改compose的部分代码即可实现
- 更换
Api接口:把reduce改为reduceRight - 交互包裹位置:把
a(b(...args))改为b(a(...args))
💬 面试官追问
表单提交链路写成
compose(validate, normalize, readForm),页面传入事件对象后执行顺序与团队预期相反;按当前实现,三个函数究竟按什么顺序调用?当前组合会从右向左执行,先调用
readForm,其结果交给normalize,最后交给validate。若团队想按声明顺序从左向右流动,应改用相应的包裹方向或reduceRight组合,不能只凭函数排列猜测执行次序。埋点工具调用
compose()后再传入两个参数,期望原样返回参数列表;当前空函数分支(v) => v会产生什么结果,契约应怎样定?当前空组合只返回第一个参数,调用
compose()(a, b)时会丢失b,它只适合作为单值恒等函数。应明确组合函数是否只支持单值管道;若要求保留任意参数,可返回(...args) => args,但这会改变单参数时的返回类型。接口适配器中最右侧函数需要接收
url和options,后续函数都只接收一个结果;当前(...args) => a(b(...args))能否满足,限制在哪里?该实现会把全部初始参数传给最右侧函数,随后每一级只接收前一级的单个返回值,因此能覆盖这种调用方式。若中间函数需要多个独立参数,就必须让前一级返回数组并显式展开,或重新定义组合协议,否则参数会在首层之后收窄。
异步请求链使用
compose(render, parse, fetchData),结果传到parse的是Promise而不是响应值;你会如何改造成异步组合?同步
compose不会等待Promise,所以fetchData的返回值会直接传给parse。可从右侧函数开始,以Promise.resolve串联后续函数,例如在归约中使用then;代价是组合结果统一变成异步返回,调用方必须await或继续处理Promise。生产构建时报
Unexpected token ')',定位到return (...args) => a(b(...args)));修正语法后还应补哪些用例,才能确认不是只让示例碰巧通过?应先删除多余右括号,再覆盖零个函数、单个函数、多个函数以及最右函数接收多参数的情况。还要验证执行顺序、返回值传递和异常是否自然向外抛出;示例中的加法满足交换性,单靠结果
11无法证明顺序正确。
# 25 setTimeout与setInterval实现
⚡ 30 秒速记
setTimeout和setInterval可以通过递归调度与执行后清理的方式相互模拟。- 用
setTimeout模拟循环调用时,每次任务执行完再安排下一次;用setInterval模拟单次调用时,则在首次触发后立即清除定时器。 - 两种方案都只是控制任务何时进入消息队列,实际执行时间仍取决于主线程和事件循环。
setTimeout 和 setInterval 可以通过递归调度与执行后清理的方式相互模拟。 用 setTimeout 模拟循环调用时,每次任务执行完再安排下一次;用 setInterval 模拟单次调用时,则在首次触发后立即清除定时器。两种方案都只是控制任务何时进入消息队列,实际执行时间仍取决于主线程和事件循环。
# 1 setTimeout 模拟实现 setInterval
⚡ 30 秒速记
- 可以递归调用
setTimeout来模拟setInterval,让本次任务执行完后再安排下一次。 - 具体做法是保存最新的
timerId,在回调末尾再次调用setTimeout,并通过闭包暴露cancel方法来执行clearTimeout。 - 相比固定投递任务的
setInterval,这种方式能减少间隔被跳过或多个回调连续执行的问题。 - 它仍不能保证回调准时执行,因为定时器只负责把任务加入消息队列。
可以递归调用 setTimeout 来模拟 setInterval,让本次任务执行完后再安排下一次。 具体做法是保存最新的 timerId,在回调末尾再次调用 setTimeout,并通过闭包暴露 cancel 方法来执行 clearTimeout。相比固定投递任务的 setInterval,这种方式能减少间隔被跳过或多个回调连续执行的问题。它仍不能保证回调准时执行,因为定时器只负责把任务加入消息队列。
题目描述: setInterval 用来实现循环定时调用 可能会存在一定的问题 能用 setTimeout 解决吗
实现代码如下:
function mySetInterval(fn, t) {
  let timerId = null;
  function interval() {
    fn();
    timerId = setTimeout(interval, t); // 递归调用
  }
  timerId = setTimeout(interval, t); // 首次调用
  return {
    // 利用闭包的特性 保存timerId
    cancel:() => {
      clearTimeout(timerId)
    }
  }
}
// 测试
var a = mySetInterval(()=>{
  console.log(111);
},1000)
var b = mySetInterval(() => {
  console.log(222)
}, 1000)

// 终止定时器
a.cancel()
b.cancel()
为什么要用
setTimeout模拟实现setInterval?setInterval的缺陷是什么?
setInterval(fn(), N);
上面这句代码的意思其实是
fn()将会在N秒之后被推入任务队列。在setInterval被推入任务队列时,如果在它前面有很多任务或者某个任务等待时间较长比如网络请求等,那么这个定时器的执行时间和我们预定它执行的时间可能并不一致
// 最常见的出现的就是,当我们需要使用 ajax 轮询服务器是否有新数据时,必定会有一些人会使用 setInterval,然而无论网络状况如何,它都会去一遍又一遍的发送请求,最后的间隔时间可能和原定的时间有很大的出入

// 做一个网络轮询,每一秒查询一次数据。
let startTime = new Date().getTime();
let count = 0;

setInterval(() => {
    let i = 0;
    while (i++ < 10000000); // 假设的网络延迟
    count++;
    console.log(
        "与原设定的间隔时差了:",
        new Date().getTime() - (startTime + count * 1000),
        "毫秒"
    );
}, 1000)

// 输出:
// 与原设定的间隔时差了: 567 毫秒
// 与原设定的间隔时差了: 552 毫秒
// 与原设定的间隔时差了: 563 毫秒
// 与原设定的间隔时差了: 554 毫秒(2次)
// 与原设定的间隔时差了: 564 毫秒
// 与原设定的间隔时差了: 602 毫秒
// 与原设定的间隔时差了: 573 毫秒
// 与原设定的间隔时差了: 633 毫秒
再次强调,定时器指定的时间间隔,表示的是何时将定时器的代码添加到消息队列,而不是何时执行代码。所以真正何时执行代码的时间是不能保证的,取决于何时被主线程的事件循环取到,并执行。
setInterval(function, N)
//即:每隔N秒把function事件推到消息队列中
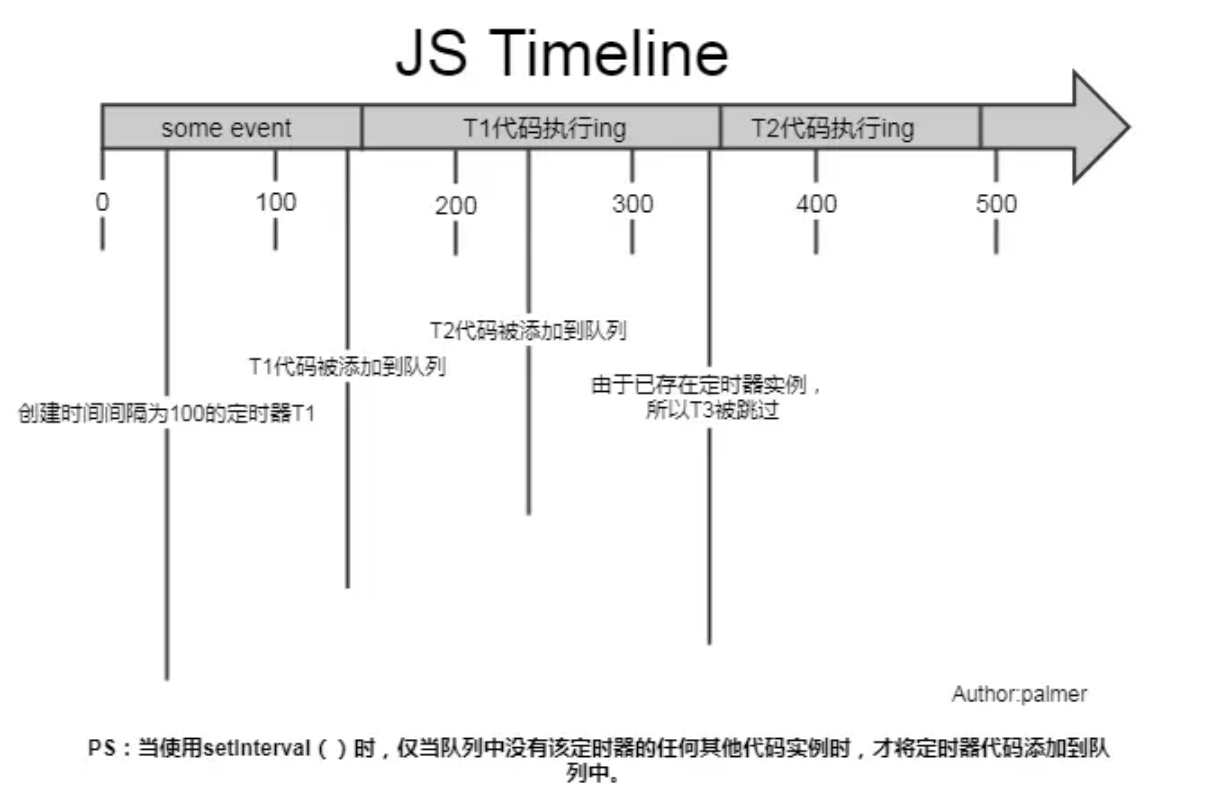
上图可见,
setInterval每隔100ms往队列中添加一个事件;100ms后,添加T1定时器代码至队列中,主线程中还有任务在执行,所以等待,some event执行结束后执行T1定时器代码;又过了100ms,T2定时器被添加到队列中,主线程还在执行T1代码,所以等待;又过了100ms,理论上又要往队列里推一个定时器代码,但由于此时T2还在队列中,所以T3不会被添加(T3被跳过),结果就是此时被跳过;这里我们可以看到,T1定时器执行结束后马上执行了 T2 代码,所以并没有达到定时器的效果
setInterval有两个缺点
- 使用
setInterval时,某些间隔会被跳过 - 可能多个定时器会连续执行
可以这么理解:每个
setTimeout产生的任务会直接push到任务队列中;而setInterval在每次把任务push到任务队列前,都要进行一下判断(看上次的任务是否仍在队列中)。因而我们一般用setTimeout模拟setInterval,来规避掉上面的缺点
💬 面试官追问
消息轮询页要求“上一次请求完成后再等
1s发下一次”,若直接用setInterval,网络变慢时会出现什么现象,递归setTimeout为什么更贴合需求?setInterval按周期尝试调度任务,不会以异步请求完成作为下一轮起点,网络变慢时可能形成重叠请求或连续执行。递归setTimeout可在回调或请求完成后再安排下一次,使间隔围绕实际完成时间计算;代价是长期运行会产生累计漂移。用户在轮询回调执行期间点击“停止”,当前
cancel()只清理旧的timerId,但回调结束后又安排了新定时器;如何避免取消后复活?应增加闭包状态
cancelled,cancel()将其设为true并清除当前定时器,回调执行前后都检查该状态。否则正在运行的fn无法被clearTimeout中止,并可能在结束后重新调度;取消只能阻止后续轮次,不能撤销已开始的副作用。数据看板每
100ms刷新一次,但主线程被长任务占用600ms,产品质疑定时器不准;你如何解释实际执行时间,并选择补偿还是顺延?定时参数只表示任务最早何时可进入消息队列,主线程繁忙时无法保证准点执行。当前递归实现会在每次执行后再等待
100ms,属于顺延策略;若业务要求贴近墙钟节拍,需要根据计划时间计算下一次延迟,但仍无法突破事件循环阻塞。轮询回调
fn第三次抛出异常,之后页面再也没有请求;按当前实现为什么会停,线上应怎样处理异常策略?当前代码先执行
fn(),只有成功返回后才调用下一次setTimeout,因此异常会阻断后续调度。可用try...finally保证重新安排,或捕获异常后上报并按策略决定重试;无条件继续可能制造异常风暴,应配合次数限制或退避。后端限流要求失败后逐步延长间隔,成功后恢复为
1s;相比原生setInterval,你会怎样扩展这段递归实现?把固定的
t改为每轮完成后计算的下一次延迟,失败时增加等待,成功时重置为1s,再调用setTimeout。递归调度天然允许每轮使用不同间隔,也便于等待异步结果;仍需设置最大延迟、取消状态和并发保护。
# 2 setInterval 模拟实现 setTimeout
⚡ 30 秒速记
- 用
setInterval模拟setTimeout时,只需让回调触发一次,并在执行前立即清除循环定时器。 - 实现中先保存
setInterval返回的timer,等到时间t后调用clearInterval(timer),随后再执行fn()。 - 这样虽然底层创建的是循环定时器,但首次触发后就被取消,因此表现为单次调用。
- 这个实现没有返回定时器标识,若需要外部提前取消,还要补充相应的返回值。
用 setInterval 模拟 setTimeout 时,只需让回调触发一次,并在执行前立即清除循环定时器。 实现中先保存 setInterval 返回的 timer,等到时间 t 后调用 clearInterval(timer),随后再执行 fn()。这样虽然底层创建的是循环定时器,但首次触发后就被取消,因此表现为单次调用。这个实现没有返回定时器标识,若需要外部提前取消,还要补充相应的返回值。
const mySetTimeout = (fn, t) => {
  const timer = setInterval(() => {
    clearInterval(timer);
    fn();
  }, t);
};
💬 面试官追问
下载页调用
mySetTimeout(showToast, 1000)后想在路由切换时取消,但当前函数没有返回值;这会造成什么工程问题,接口应怎样调整?调用方拿不到定时器句柄,路由卸载时无法提前清理,回调可能在页面销毁后继续修改状态。应返回
timer,或返回带cancel()的对象并在内部执行clearInterval;取消接口的形态应与项目现有定时器封装保持一致。回调
fn执行时抛出异常,代码已经先调用clearInterval(timer);它还会不会再次触发,这个调用顺序有什么意义?不会因该
interval再次触发,因为进入回调后先清除了周期定时器,随后才执行fn()。把清理放在前面可确保即使fn抛错也只运行一次;若顺序相反,异常可能跳过清理,使定时任务继续触发。团队把这个实现当成原生
setTimeout替代品,但业务需要向回调传递userId和pageNo;当前签名缺了什么,怎样兼容?当前封装只接收
fn和t,没有转发附加参数,因此不能直接覆盖这类调用。可改为mySetTimeout(fn, t, ...args),触发时执行fn(...args);还需明确回调的this语义,否则仍不能宣称与宿主API完全等价。定时任务设置为
0ms,产品以为会同步执行并立即读取结果;使用setInterval模拟后,为什么仍然读不到,应该如何解释?即使延迟为
0,回调也只是尽早进入异步任务调度,不会插入当前同步调用栈中执行。当前函数会先返回,随后定时器回调才清理interval并调用fn;若代码依赖同步结果,就不应使用任何定时器封装。代码评审时一方主张保留
setInterval模拟以考察原理,另一方要在生产代码中直接用setTimeout;你支持哪种选择,理由是什么?生产代码应优先直接使用
setTimeout,它原生表达“一次延迟执行”,语义和取消方式都更清楚。用setInterval后立即清除虽然能模拟主流程,却引入不必要的周期调度概念;手写版本更适合作为面试中验证定时器与闭包理解的练习。线上偶发出现回调未按预期时间执行,日志显示主线程此前有长任务;你会先检查封装是否重复触发,还是先查事件循环阻塞?
先记录计划时间、实际触发时间和回调次数:该实现进入首次
interval回调后立即清理,正常情况下只会执行一次。若只是明显延迟而没有重复,应优先排查长任务和任务队列拥塞;定时器延迟表示最早调度时间,并不承诺精确执行时刻。
// 测试
// mySetTimeout(()=>{
//   console.log(1);
// },1000)
💬 面试官追问
埋点页面调用
mySetTimeout(fn, 1000)后主线程卡了 3 秒,你说它会在第 1 秒执行,这个判断哪里不成立?它只能保证回调至少等待约 1 秒,不能保证准时执行;主线程被占用时,定时器任务只能等事件循环有机会调度。这里用
setInterval也不会突破这一限制,并且实际触发时间还会受到运行环境对延迟参数处理方式的影响。搜索联想组件需要在卸载时取消延迟请求,这个实现没有返回值,你会怎样补齐调用约定?
应返回
setInterval产生的定时器标识,使调用方能够通过clearInterval主动取消。回调触发时仍先清除定时器再执行fn,但还需约定fn的参数与this语义;若要完整兼容原生接口,直接使用setTimeout更可靠。任务调度器把延迟值传成
0、负数或字符串,同时可能漏传fn,你会在封装层怎样处理?若目标是模拟原生行为,应先明确是否沿用宿主环境对延迟值的转换规则,而不是自行发明一套校验语义。对非函数
fn,工程封装宜尽早抛出清晰错误;对异常延迟值则应测试目标环境,避免浏览器与Node.js的行为差异被隐藏。线上监控发现回调偶尔执行两次,你会沿着哪些状态检查这个
setInterval版本?先确认同一业务是否重复创建了多个定时器,再记录每个定时器标识、创建位置、触发次数和取消位置。单个实例在回调入口先执行
clearInterval(timer),正常情况下只会运行一次;若重复仍存在,通常要继续排查重复挂载、热更新或并发调用。代码评审中有人坚持用
setInterval模拟,有人要求直接使用setTimeout,你会怎样做选型?生产代码应优先使用
setTimeout,因为它原生表达一次性调度,并直接提供取消能力,语义也更清楚。setInterval版本适合面试中说明定时器可被清除,但增加了周期调度这一层无用机制,兼容原生参数与返回语义时还会产生额外成本。
# 26 实现Node的require方法
⚡ 30 秒速记
- 实现
require的核心,是解析模块路径、执行模块代码,并缓存其module.exports。 - 我会先把相对路径转成绝对路径,再用
fs读取文件,通过函数包装提供独立作用域,并交给vm.runInThisContext执行。 - 加载完成后以文件名为键写入
Module._cache,再次引用时直接返回缓存。 - 这个简化实现主要覆盖
JavaScript文件,完整的Node模块解析还会复杂得多。
实现 require 的核心,是解析模块路径、执行模块代码,并缓存其 module.exports。 我会先把相对路径转成绝对路径,再用 fs 读取文件,通过函数包装提供独立作用域,并交给 vm.runInThisContext 执行。加载完成后以文件名为键写入 Module._cache,再次引用时直接返回缓存。这个简化实现主要覆盖 JavaScript 文件,完整的 Node 模块解析还会复杂得多。
require 基本原理
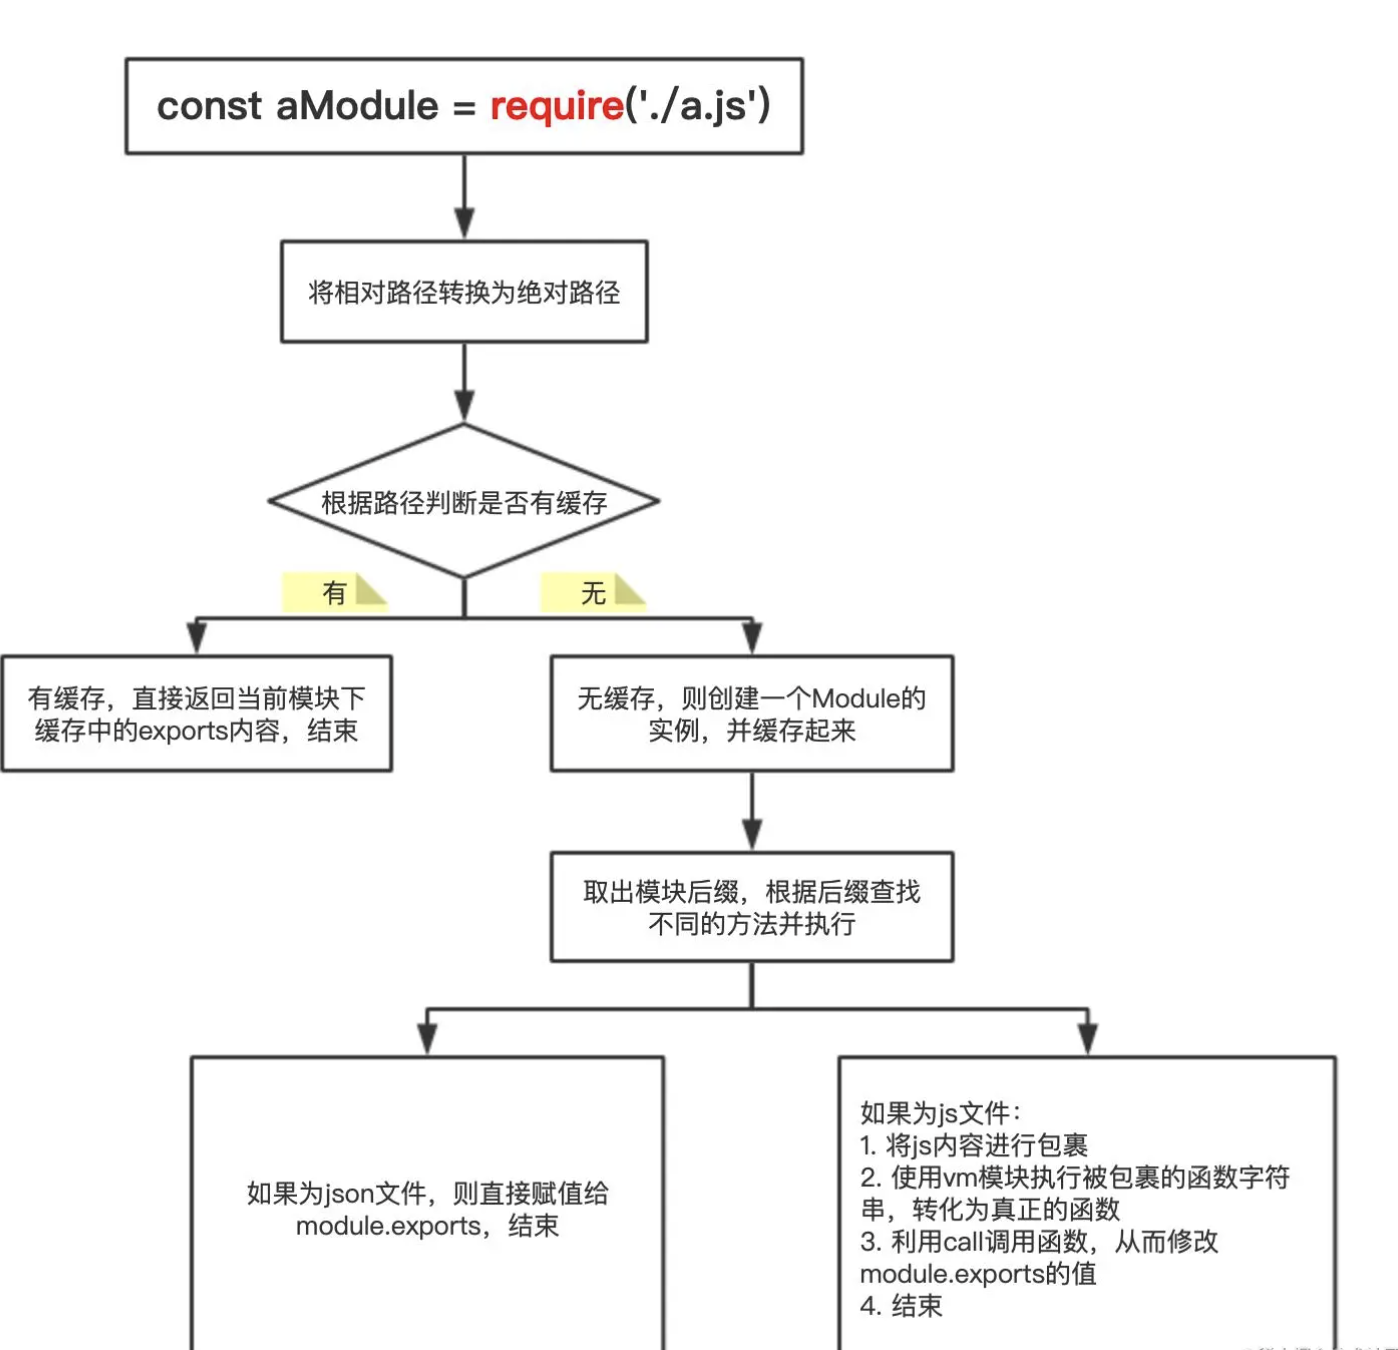
require 查找路径
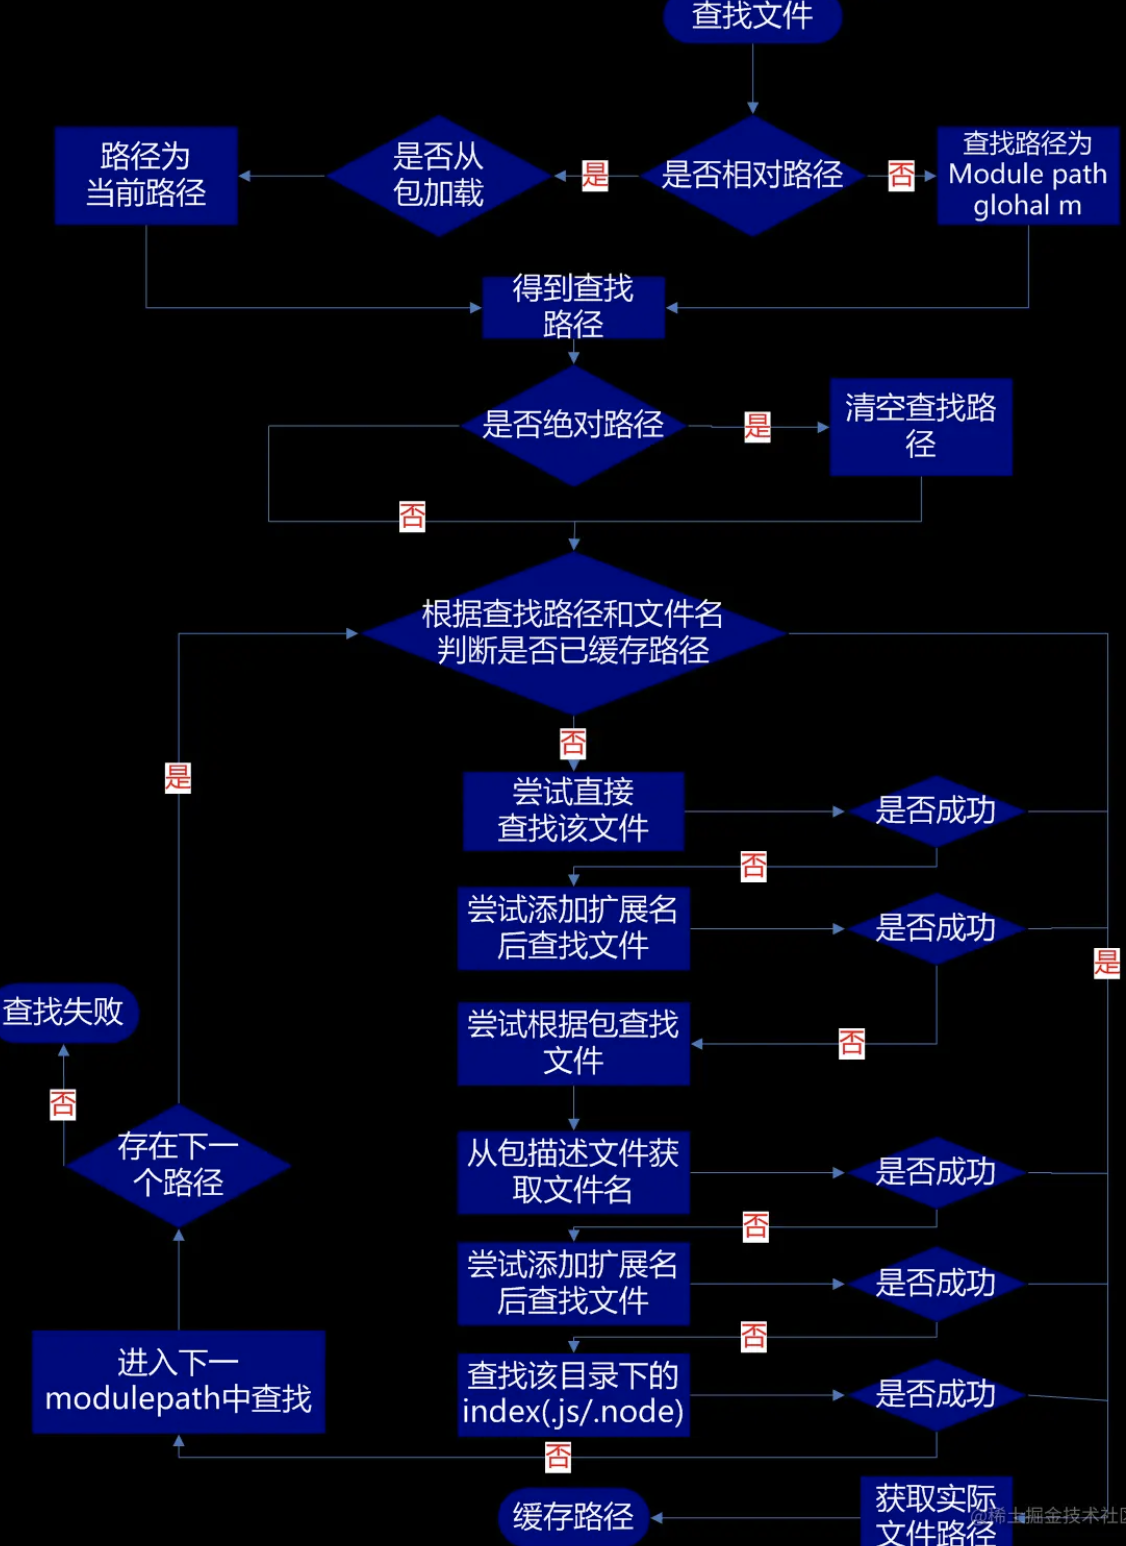
require和module.exports干的事情并不复杂,我们先假设有一个全局对象{},初始情况下是空的,当你require某个文件时,就将这个文件拿出来执行,如果这个文件里面存在module.exports,当运行到这行代码时将module.exports的值加入这个对象,键为对应的文件名,最终这个对象就长这样:
{
  "a.js": "hello world",
  "b.js": function add(){},
  "c.js": 2,
  "d.js": { num: 2 }
}
当你再次
require某个文件时,如果这个对象里面有对应的值,就直接返回给你,如果没有就重复前面的步骤,执行目标文件,然后将它的module.exports加入这个全局对象,并返回给调用者。这个全局对象其实就是我们经常听说的缓存。所以require和module.exports并没有什么黑魔法,就只是运行并获取目标文件的值,然后加入缓存,用的时候拿出来用就行
手写实现一个require
const path = require('path'); // 路径操作
const fs = require('fs'); // 文件读取
const vm = require('vm'); // 文件执行

// node模块化的实现
// node中是自带模块化机制的,每个文件就是一个单独的模块,并且它遵循的是CommonJS规范,也就是使用require的方式导入模块,通过module.export的方式导出模块。
// node模块的运行机制也很简单,其实就是在每一个模块外层包裹了一层函数,有了函数的包裹就可以实现代码间的作用域隔离

// require加载模块
// require依赖node中的fs模块来加载模块文件,fs.readFile读取到的是一个字符串。
// 在javascrpt中我们可以通过eval或者new Function的方式来将一个字符串转换成js代码来运行。

// eval
// const name = 'poetry';
// const str = 'const a = 123; console.log(name)';
// eval(str); // poetry;

// new Function
// new Function接收的是一个要执行的字符串,返回的是一个新的函数,调用这个新的函数字符串就会执行了。如果这个函数需要传递参数,可以在new Function的时候依次传入参数,最后传入的是要执行的字符串。比如这里传入参数b,要执行的字符串str
// const b = 3;
// const str = 'let a = 1; return a + b';
// const fun = new Function('b', str);
// console.log(fun(b, str)); // 4
// 可以看到eval和Function实例化都可以用来执行javascript字符串,似乎他们都可以来实现require模块加载。不过在node中并没有选用他们来实现模块化,原因也很简单因为他们都有一个致命的问题,就是都容易被不属于他们的变量所影响。
// 如下str字符串中并没有定义a,但是确可以使用上面定义的a变量,这显然是不对的,在模块化机制中,str字符串应该具有自身独立的运行空间,自身不存在的变量是不可以直接使用的
// const a = 1;
// const str = 'console.log(a)';
// eval(str);
// const func = new Function(str);
// func();

// node存在一个vm虚拟环境的概念,用来运行额外的js文件,他可以保证javascript执行的独立性,不会被外部所影响
// vm 内置模块
// 虽然我们在外部定义了hello,但是str是一个独立的模块,并不在村hello变量,所以会直接报错。
// 引入vm模块, 不需要安装,node 自建模块
// const vm = require('vm');
// const hello = 'poetry';
// const str = 'console.log(hello)';
// wm.runInThisContext(str); // 报错
// 所以node执行javascript模块时可以采用vm来实现。就可以保证模块的独立性了

// 分析实现步骤
// 1.导入相关模块,创建一个Require方法。
// 2.抽离通过Module._load方法,用于加载模块。
// 3.Module.resolveFilename 根据相对路径,转换成绝对路径。
// 4.缓存模块 Module._cache,同一个模块不要重复加载,提升性能。
// 5.创建模块 id: 保存的内容是 exports = {}相当于this。
// 6.利用tryModuleLoad(module, filename) 尝试加载模块。
// 7.Module._extensions使用读取文件。
// 8.Module.wrap: 把读取到的js包裹一个函数。
// 9.将拿到的字符串使用runInThisContext运行字符串。
// 10.让字符串执行并将this改编成exports

// 定义导入类,参数为模块路径
function Require(modulePath) {
    // 获取当前要加载的绝对路径
    let absPathname = path.resolve(__dirname, modulePath);

    // 自动给模块添加后缀名,实现省略后缀名加载模块,其实也就是如果文件没有后缀名的时候遍历一下所有的后缀名看一下文件是否存在
    // 获取所有后缀名
    const extNames = Object.keys(Module._extensions);
    let index = 0;
    // 存储原始文件路径
    const oldPath = absPathname;
    function findExt(absPathname) {
        if (index === extNames.length) {
            throw new Error('文件不存在');
        }
        try {
            fs.accessSync(absPathname);
            return absPathname;
        } catch(e) {
            const ext = extNames[index++];
            findExt(oldPath + ext);
        }
    }
    // 递归追加后缀名,判断文件是否存在
    absPathname = findExt(absPathname);

    // 从缓存中读取,如果存在,直接返回结果
    if (Module._cache[absPathname]) {
        return Module._cache[absPathname].exports;
    }

    // 创建模块,新建Module实例
    const module = new Module(absPathname);

    // 添加缓存
    Module._cache[absPathname] = module;

    // 加载当前模块
    tryModuleLoad(module);

    // 返回exports对象
    return module.exports;
}

// Module的实现很简单,就是给模块创建一个exports对象,tryModuleLoad执行的时候将内容加入到exports中,id就是模块的绝对路径
// 定义模块, 添加文件id标识和exports属性
function Module(id) {
    this.id = id;
    // 读取到的文件内容会放在exports中
    this.exports = {};
}

Module._cache = {};

// 我们给Module挂载静态属性wrapper,里面定义一下这个函数的字符串,wrapper是一个数组,数组的第一个元素就是函数的参数部分,其中有exports,module. Require,__dirname, __filename, 都是我们模块中常用的全局变量。注意这里传入的Require参数是我们自己定义的Require
// 第二个参数就是函数的结束部分。两部分都是字符串,使用的时候我们将他们包裹在模块的字符串外部就可以了
Module.wrapper = [
    "(function(exports, module, Require, __dirname, __filename) {",
    "})"
]

// _extensions用于针对不同的模块扩展名使用不同的加载方式,比如JSON和javascript加载方式肯定是不同的。JSON使用JSON.parse来运行。
// javascript使用vm.runInThisContext来运行,可以看到fs.readFileSync传入的是module.id也就是我们Module定义时候id存储的是模块的绝对路径,读取到的content是一个字符串,我们使用Module.wrapper来包裹一下就相当于在这个模块外部又包裹了一个函数,也就实现了私有作用域。
// 使用call来执行fn函数,第一个参数改变运行的this我们传入module.exports,后面的参数就是函数外面包裹参数exports, module, Require, __dirname, __filename
Module._extensions = {
    '.js'(module) {
        const content = fs.readFileSync(module.id, 'utf8');
        const fnStr = Module.wrapper[0] + content + Module.wrapper[1];
        const fn = vm.runInThisContext(fnStr);
        fn.call(module.exports, module.exports, module, Require,__filename,__dirname);
    },
    '.json'(module) {
        const json = fs.readFileSync(module.id, 'utf8');
        module.exports = JSON.parse(json); // 把文件的结果放在exports属性上
    }
}

// tryModuleLoad函数接收的是模块对象,通过path.extname来获取模块的后缀名,然后使用Module._extensions来加载模块
// 定义模块加载方法
function tryModuleLoad(module) {
    // 获取扩展名
    const extension = path.extname(module.id);
    // 通过后缀加载当前模块
    Module._extensions[extension](module);
}

// 至此Require加载机制我们基本就写完了,我们来重新看一下。Require加载模块的时候传入模块名称,在Require方法中使用path.resolve(__dirname, modulePath)获取到文件的绝对路径。然后通过new Module实例化的方式创建module对象,将模块的绝对路径存储在module的id属性中,在module中创建exports属性为一个json对象
// 使用tryModuleLoad方法去加载模块,tryModuleLoad中使用path.extname获取到文件的扩展名,然后根据扩展名来执行对应的模块加载机制
// 最终将加载到的模块挂载module.exports中。tryModuleLoad执行完毕之后module.exports已经存在了,直接返回就可以了


// 给模块添加缓存
// 添加缓存也比较简单,就是文件加载的时候将文件放入缓存中,再去加载模块时先看缓存中是否存在,如果存在直接使用,如果不存在再去重新,加载之后再放入缓存

// 测试
let json = Require('./test.json');
let test2 = Require('./test2.js');
console.log(json);
console.log(test2);
💬 面试官追问
a.js与b.js相互require,你的加载器等文件执行完才写入缓存,线上会出现什么现象,缓存应该何时建立?它可能反复加载两个文件,最终递归溢出,而不是自然结束循环依赖。应在创建
module后、执行模块代码前就按绝对文件名写入Module._cache,后续请求先返回当前的exports;代价是循环依赖方可能看到尚未完成的部分导出。插件系统从
/srv/app/pages/home.js执行require('./config'),你会怎样保证解析基准不是进程启动目录?相对路径必须以发起加载的模块所在目录为基准,再解析成稳定的绝对文件名作为模块标识和缓存键。解析阶段还要按实现范围处理文件与目录候选;若只支持显式
.js文件,应清楚限制,而不能假装完整复刻Node.js。同一个配置模块被不同页面各加载一万次,产品既要求避免重复执行,又担心不同写法产生两份实例,你怎么设计缓存键?
缓存应放在加载器共享的
Module._cache中,并使用解析后的规范绝对文件名作为键,而不是调用方传入的原始字符串。这样重复加载可以直接返回同一份module.exports;符号链接、大小写和多入口解析仍可能影响身份,需要按部署环境限定规则。线上某模块加载时报
ReferenceError,但单独把源码粘到控制台却能运行,你会怎样定位包装与执行阶段?先打印解析后的文件名和读取内容,再检查
Module.wrap是否注入了exports、require、module等模块局部变量,以及vm.runInThisContext返回的包装函数是否被正确调用。控制台拥有额外作用域,不能作为模块隔离的证明;还要保留原始异常栈,避免包装层吞掉语法或运行错误。团队在
eval、new Function和vm.runInThisContext之间争论,目标是实现教学版require,你会选哪一个并说明边界?按给定实现思路应选择
vm.runInThisContext执行包装后的源码,使模块通过函数参数获得依赖,并避免直接捕获加载器函数的局部变量。它只是实现作用域隔离的一部分,不等同于安全沙箱;不可信代码仍不能因此被安全执行。
# 27 实现LRU淘汰算法
⚡ 30 秒速记
LRU淘汰最长时间没有被访问的数据,读写都要把条目移动到“最近使用”端- 要做到平均
O(1),用哈希表定位节点、双向链表维护新旧顺序 - 容量满时删除链表尾部,同时删除哈希表映射
Map保留插入顺序,可写简化版;面试若强调底层结构,应写哈希表加双向链表
实现 LRU 可以直接利用 Map 的插入顺序,让最近使用的数据排到后面,最久未使用的数据留在最前面。 get 命中后先删除再写回,借此更新使用顺序;set 遇到已有键也做同样处理。容量超限时,通过 data.keys().next().value 找到最早的键并删除。这个方案代码简单且存取方便;数组也能实现,但查找和移动元素更麻烦。
LRU 缓存算法是一个非常经典的算法,在很多面试中经常问道,不仅仅包括前端面试
LRU英文全称是Least Recently Used,英译过来就是”最近最少使用“的意思。LRU是一种常用的页面置换算法,选择最近最久未使用的页面予以淘汰。该算法赋予每个页面一个访问字段,用来记录一个页面自上次被访问以来所经历的时间t,当须淘汰一个页面时,选择现有页面中其t值最大的,即最近最少使用的页面予以淘汰
通俗的解释:
假如我们有一块内存,专门用来缓存我们最近发访问的网页,访问一个新网页,我们就会往内存中添加一个网页地址,随着网页的不断增加,内存存满了,这个时候我们就需要考虑删除一些网页了。这个时候我们找到内存中最早访问的那个网页地址,然后把它删掉。这一整个过程就可以称之为
LRU算法
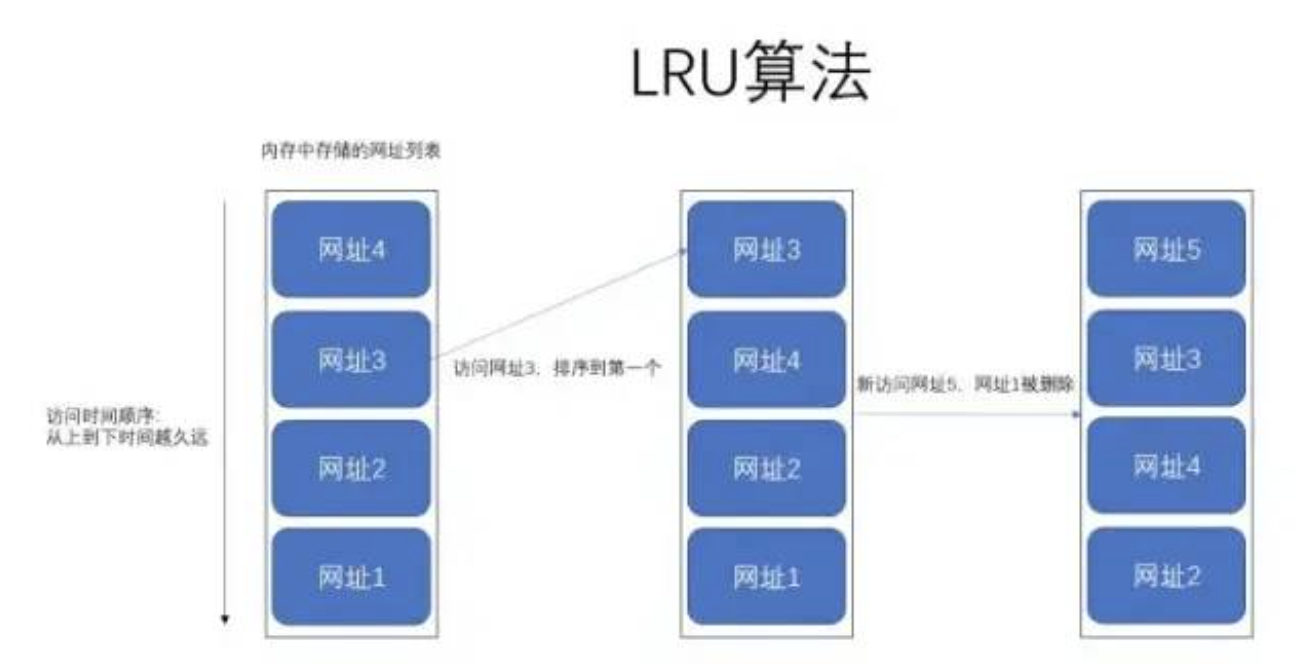
上图就很好的解释了 LRU 算法在干嘛了,其实非常简单,无非就是我们往内存里面添加或者删除元素的时候,遵循最近最少使用原则
使用场景
LRU 算法使用的场景非常多,这里简单举几个例子即可:
- 我们操作系统底层的内存管理,其中就包括有
LRU算法 - 我们常见的缓存服务,比如
redis等等 - 比如浏览器的最近浏览记录存储
vue中的keep-alive组件使用了LRU算法
梳理实现 LRU 思路
- 特点分析:
- 我们需要一块有限的存储空间,因为无限的化就没必要使用
LRU算发删除数据了。 - 我们这块存储空间里面存储的数据需要是有序的,因为我们必须要顺序来删除数据,所以可以考虑使用
Array、Map数据结构来存储,不能使用Object,因为它是无序的。 - 我们能够删除或者添加以及获取到这块存储空间中的指定数据。
- 存储空间存满之后,在添加数据时,会自动删除时间最久远的那条数据。
- 我们需要一块有限的存储空间,因为无限的化就没必要使用
- 实现需求:
- 实现一个
LRUCache类型,用来充当存储空间 - 采用
Map数据结构存储数据,因为它的存取时间复杂度为O(1),数组为O(n) - 实现
get和set方法,用来获取和添加数据 - 我们的存储空间有长度限制,所以无需提供删除方法,存储满之后,自动删除最久远的那条数据
- 当使用
get获取数据后,该条数据需要更新到最前面
- 实现一个
具体实现
class LRUCache {
  constructor(length) {
    this.length = length; // 存储长度
    this.data = new Map(); // 存储数据
  }
  // 存储数据,通过键值对的方式
  set(key, value) {
    const data = this.data;

    // 有的话 删除 重建放到map最前面
    if (data.has(key)) {
      data.delete(key)
    }

    data.set(key, value);

    // 如果超出了容量,则需要删除最久的数据
    if (data.size > this.length) {
      // 删除map最老的数据
      const delKey = data.keys().next().value;
      data.delete(delKey);
    }
  }
  // 获取数据
  get(key) {
    const data = this.data;
    // 未找到
    if (!data.has(key)) {
      return null;
    }
    const value = data.get(key); // 获取元素
    data.delete(key); // 删除元素
    data.set(key, value); // 重新插入元素到map最前面

    return value // 返回获取的值
  }
}
var lruCache = new LRUCache(5);
set 方法:往map里面添加新数据,如果添加的数据存在了,则先删除该条数据,然后再添加。如果添加数据后超长了,则需要删除最久远的一条数据。data.keys().next().value便是获取最后一条数据的意思。get 方法:首先从map对象中拿出该条数据,然后删除该条数据,最后再重新插入该条数据,确保将该条数据移动到最前面
// 测试

// 存储数据 set:

lruCache.set('name', 'test');
lruCache.set('age', 10);
lruCache.set('sex', '男');
lruCache.set('height', 180);
lruCache.set('weight', '120');
console.log(lruCache);
继续插入数据,此时会超长,代码如下:
lruCache.set('grade', '100');
console.log(lruCache);
此时我们发现存储时间最久的 name 已经被移除了,新插入的数据变为了最前面的一个。
我们使用 get 获取数据,代码如下:
我们发现此时 sex 字段已经跑到最前面去了
总结
LRU算法其实逻辑非常的简单,明白了原理之后实现起来非常的简单。最主要的是我们需要使用什么数据结构来存储数据,因为map的存取非常快,所以我们采用了它,当然数组其实也可以实现的。还有一些小伙伴使用链表来实现LRU,这当然也是可以的。
💬 面试官追问
缓存容量为
2,依次执行set('a',1)、set('b',2)、get('a')、set('c',3),有人说应该淘汰a,你如何反驳?应该淘汰
b,因为get('a')已把a更新为最近使用项,b才是最近最久未使用的键。实现中通过删除再插入改变Map的迭代顺序,淘汰时取data.keys().next().value,拿到的是最旧项而不是最新项。接口响应缓存准备接入这个
LRUCache,业务值可能就是null,页面又用get(key) === null判断未命中,你会怎样调整契约?当前
get返回null会把“键不存在”和“缓存值为null”混在一起,应禁止存储该值、改用独立哨兵,或同时提供has供调用方判断。具体选择要写进接口契约,否则页面可能把有效缓存当作未命中并重复请求。容量从
5改成0或负数后,每次set都执行淘汰,你认为构造函数该接受这些值吗?应在构造阶段明确容量必须是非负整数,并决定容量为
0时是合法的禁用缓存,还是直接拒绝。当前代码对负数也只会尝试删除一个键,随后仍可能保留数据,语义不可靠;越早校验越能避免运行中出现隐蔽状态。线上发现热点键仍被淘汰,日志显示它频繁读取,你会怎样验证是调用问题还是顺序维护错误?
先按时间记录
set、get、命中结果及每次操作后的键迭代顺序,确认热点读取确实经过了这个实例的get。再检查是否存在多个缓存实例、直接访问内部Map或用不同类型的键;若顺序正确,则淘汰键应始终是keys().next().value。百万级容量下,同事提议用数组保存访问顺序,另一人坚持当前
Map,你会怎样判断?数组在命中后需要查找并移动元素,操作成本会随缓存规模增长,不适合高频读写的大容量场景。当前
Map利用删除、重新插入和首键迭代维护顺序,代码简洁且关键操作通常可视为常数时间;若运行环境或功能要求不允许依赖其顺序语义,再考虑哈希表加双向链表。
# 28 框架相关
# 1 将虚拟 Dom 转化为真实 Dom
⚡ 30 秒速记
- 把虚拟
DOM转成真实DOM,本质上就是递归创建节点、设置属性,再依次挂载子节点。 - 数字先转成字符串,字符串直接用
document.createTextNode创建文本节点;普通对象则根据tag调用document.createElement。 - 随后遍历
attrs执行setAttribute,并对children递归调用渲染函数。 - 这个实现适合题目中的基础结构,前提是
children存在且节点类型仅包含文本和普通元素。
把虚拟 DOM 转成真实 DOM,本质上就是递归创建节点、设置属性,再依次挂载子节点。 数字先转成字符串,字符串直接用 document.createTextNode 创建文本节点;普通对象则根据 tag 调用 document.createElement。随后遍历 attrs 执行 setAttribute,并对 children 递归调用渲染函数。这个实现适合题目中的基础结构,前提是 children 存在且节点类型仅包含文本和普通元素。
{
  tag: 'DIV',
  attrs:{
  id:'app'
  },
  children: [
    {
      tag: 'SPAN',
      children: [
        { tag: 'A', children: [] }
      ]
    },
    {
      tag: 'SPAN',
      children: [
        { tag: 'A', children: [] },
        { tag: 'A', children: [] }
      ]
    }
  ]
}

把上面虚拟Dom转化成下方真实Dom

<div id="app">
  <span>
    <a></a>
  </span>
  <span>
    <a></a>
    <a></a>
  </span>
</div>
实现
// 真正的渲染函数
function _render(vnode) {
  // 如果是数字类型转化为字符串
  if (typeof vnode === "number") {
    vnode = String(vnode);
  }
  // 字符串类型直接就是文本节点
  if (typeof vnode === "string") {
    return document.createTextNode(vnode);
  }
  // 普通DOM
  const dom = document.createElement(vnode.tag);
  if (vnode.attrs) {
    // 遍历属性
    Object.keys(vnode.attrs).forEach((key) => {
      const value = vnode.attrs[key];
      dom.setAttribute(key, value);
    });
  }
  // 子数组进行递归操作
  vnode.children.forEach((child) => dom.appendChild(_render(child)));
  return dom;
}
💬 面试官追问
文章详情页的虚拟节点把数字
0和字符串都当作子节点,但遇到null、布尔值或缺少children就崩溃,你会怎样定义可渲染节点?现有实现只明确支持数字、字符串和带
tag、children的普通节点,因此其他值不能直接递归进入_render。工程实现应先约定空值和布尔值是忽略、转文本还是报错,并为缺失的children使用空数组;未经约定的对象应尽早抛出可定位的错误。后台表单通过虚拟节点传入
value、checked和点击处理函数,统一调用setAttribute后交互异常,你会怎样拆分属性处理?普通字符串属性可以继续使用
setAttribute,但表单状态往往需要写入对应的DOM属性,事件处理函数也应通过事件监听机制绑定。还要单独处理class、style等结构化输入;若不限定attrs的数据模型,这个渲染器只能支持示例中的静态标记。评论树有五万层嵌套,当前
_render递归时页面报调用栈溢出,你会怎样改造渲染过程?应把深度优先递归改成显式栈或分批遍历,保存虚拟节点与父
DOM的对应关系,逐步创建并挂载节点。即使避免了栈溢出,一次同步生成大量节点仍会长期阻塞主线程;必要时还要切片执行或限制树深和节点总量。线上只渲染出根节点,控制台显示
Cannot read properties of undefined,你会从哪几个输入位置开始查?先检查每个普通节点是否都有合法
tag,以及children是否确实为数组,因为代码会无条件执行vnode.children.forEach。随后定位递归到哪一个子节点变成了undefined,并核对文本节点是否只传数字或字符串;入口校验能比深层DOM异常提供更准确的信息。搜索结果每次只改一条文本,团队想重复调用
_render并替换整棵DOM,你会接受吗?小型静态片段可以重新创建,但频繁替换整棵树会丢失已有
DOM状态和事件关系,也会制造不必要的节点操作。若页面持续更新,应引入新旧虚拟树比较和定点补丁,并用稳定标识匹配列表项;代价是实现复杂度从“创建节点”上升为完整的更新系统。
# 2 实现事件总线结合Vue应用
⚡ 30 秒速记
- 事件总线就是一个发布订阅中心,用
on、emit、off和once统一管理组件之间的事件通信。 - 在
Vue中可以创建一个实例并挂到全局,组件通过$on订阅、通过$emit发布,因此互不直接依赖。 - 手写时按事件名保存回调数组,触发时逐个执行,解绑时过滤目标函数,单次监听执行后立即移除。
- 它适合距离较远的组件通信,但事件过多时关系会变得隐蔽,需要及时解绑。
事件总线就是一个发布订阅中心,用 on、emit、off 和 once 统一管理组件之间的事件通信。 在 Vue 中可以创建一个实例并挂到全局,组件通过 $on 订阅、通过 $emit 发布,因此互不直接依赖。手写时按事件名保存回调数组,触发时逐个执行,解绑时过滤目标函数,单次监听执行后立即移除。它适合距离较远的组件通信,但事件过多时关系会变得隐蔽,需要及时解绑。
Event Bus(Vue、Flutter 等前端框架中有出镜)和Event Emitter(Node中有出镜)出场的“剧组”不同,但是它们都对应一个共同的角色——全局事件总线。
全局事件总线,严格来说不能说是观察者模式,而是发布-订阅模式。它在我们日常的业务开发中应用非常广。
如果只能选一道题,那这道题一定是
Event Bus/Event Emitter的代码实现——我都说这么清楚了,这个知识点到底要不要掌握、需要掌握到什么程度,就看各位自己的了。
在Vue中使用Event Bus来实现组件间的通讯
Event Bus/Event Emitter作为全局事件总线,它起到的是一个沟通桥梁的作用。我们可以把它理解为一个事件中心,我们所有事件的订阅/发布都不能由订阅方和发布方“私下沟通”,必须要委托这个事件中心帮我们实现。
在Vue中,有时候 A 组件和 B 组件中间隔了很远,看似没什么关系,但我们希望它们之间能够通信。这种情况下除了求助于 Vuex 之外,我们还可以通过 Event Bus 来实现我们的需求。
创建一个 Event Bus(本质上也是 Vue 实例)并导出:
const EventBus = new Vue()
export default EventBus
在主文件里引入EventBus,并挂载到全局:
import bus from 'EventBus的文件路径'
Vue.prototype.bus = bus
订阅事件:
// 这里func指someEvent这个事件的监听函数
this.bus.$on('someEvent', func)
发布(触发)事件:
// 这里params指someEvent这个事件被触发时回调函数接收的入参
this.bus.$emit('someEvent', params)
大家会发现,整个调用过程中,没有出现具体的发布者和订阅者(比如上面的
PrdPublisher和DeveloperObserver),全程只有bus这个东西一个人在疯狂刷存在感。这就是全局事件总线的特点——所有事件的发布/订阅操作,必须经由事件中心,禁止一切“私下交易”!
实现方式1
class EventEmitter {
  constructor() {
    // handlers是一个map,用于存储事件与回调之间的对应关系
    this.handlers = {}
  }

  // on方法用于安装事件监听器,它接受目标事件名和回调函数作为参数
  on(eventName, cb) {
    // 先检查一下目标事件名有没有对应的监听函数队列
    if (!this.handlers[eventName]) {
      // 如果没有,那么首先初始化一个监听函数队列
      this.handlers[eventName] = []
    }

    // 把回调函数推入目标事件的监听函数队列里去
    this.handlers[eventName].push(cb)
  }

  // emit方法用于触发目标事件,它接受事件名和监听函数入参作为参数
  emit(eventName, ...args) {
    // 检查目标事件是否有监听函数队列
    if (this.handlers[eventName]) {
      // 如果有,则逐个调用队列里的回调函数
      this.handlers[eventName].forEach((callback) => {
        callback(...args)
      })
    }
  }

  // 移除某个事件回调队列里的指定回调函数
  off(eventName, cb) {
    const callbacks = this.handlers[eventName]
    const index = callbacks.indexOf(cb)
    if (index !== -1) {
      callbacks.splice(index, 1)
    }
  }

  // 为事件注册单次监听器
  once(eventName, cb) {
    // 对回调函数进行包装,使其执行完毕自动被移除
    const wrapper = (...args) => {
      cb.apply(...args)
      this.off(eventName, wrapper)
    }
    this.on(eventName, wrapper)
  }
}
实现方式2
- 分析
on和once注册函数,存储起来emit时找到对应的函数,执行off找到对应函数,从存储中删除
- 注意
on绑定的事件可以连续执行,除非offonce绑定的函数emit一次即删除,也可以未执行而被off
class EventBus {
    /**
     * {
     *    'key1': [
     *        { fn: fn1, isOnce: false },
     *        { fn: fn2, isOnce: false },
     *        { fn: fn3, isOnce: true },
     *    ]
     *    'key2': [] // 有序
     *    'key3': []
     * }
     */
    constructor() {
        this.events = {}
    }

    on(type, fn, isOnce = false) {
        const events = this.events
        if (events[type] == null) {
            events[type] = [] // 初始化 key 的 fn 数组
        }
        events[type].push({ fn, isOnce })
    }

    once(type, fn) {
        this.on(type, fn, true)
    }

    off(type, fn) {
        if (!fn) {
            // 解绑所有 type 的函数
            this.events[type] = []
        } else {
            // 解绑单个 fn
            const fnList = this.events[type]
            if (fnList) {
                this.events[type] = fnList.filter(item => item.fn !== fn)
            }
        }
    }

    emit(type, ...args) {
        const fnList = this.events[type]
        if (fnList == null) return

        // 注意过滤后重新赋值
        this.events[type] = fnList.filter(item => {
            const { fn, isOnce } = item
            fn(...args)

            // once 执行一次就要被过滤掉
            if (!isOnce) return true
            return false
        })
    }
}
实现方式3:拆分保存 on 和 once 事件
// 拆分保存 on 和 once 事件

class EventBus {
    constructor() {
        this.events = {} // { key1: [fn1, fn2], key2: [fn1, fn2] }
        this.onceEvents = {}
    }

    on(type, fn) {
        const events = this.events
        if (events[type] == null) events[type] = []
        events[type].push(fn)
    }

    once(type, fn) {
        const onceEvents = this.onceEvents
        if (onceEvents[type] == null) onceEvents[type] = []
        onceEvents[type].push(fn)
    }

    off(type, fn) {
        if (!fn) {
            // 解绑所有事件
            this.events[type] = []
            this.onceEvents[type] = []
        } else {
            // 解绑单个事件
            const fnList = this.events[type]
            const onceFnList = this.onceEvents[type]
            if (fnList) {
                this.events[type] = fnList.filter(curFn => curFn !== fn)
            }
            if (onceFnList) {
                this.onceEvents[type] = onceFnList.filter(curFn => curFn !== fn)
            }
        }
    }

    emit(type, ...args) {
        const fnList = this.events[type]
        const onceFnList = this.onceEvents[type]

        if (fnList) {
            fnList.forEach(f => f(...args))
        }
        if (onceFnList) {
            onceFnList.forEach(f => f(...args))

            // once 执行一次就删除
            this.onceEvents[type] = []
        }
    }
}
// 测试
const e = new EventBus()

function fn1(a, b) { console.log('fn1', a, b) }
function fn2(a, b) { console.log('fn2', a, b) }
function fn3(a, b) { console.log('fn3', a, b) }

e.on('key1', fn1)
e.on('key1', fn2)
e.once('key1', fn3)
e.on('xxxxxx', fn3)

e.emit('key1', 10, 20) // 触发 fn1 fn2 fn3

e.off('key1', fn1)

e.emit('key1', 100, 200) // 触发 fn2
在日常的开发中,大家用到
EventBus/EventEmitter往往提供比这五个方法多的多的多的方法。但在面试过程中,如果大家能够完整地实现出这五个方法,已经非常可以说明问题了,因此这个EventBus希望大家可以熟练掌握。学有余力的同学,推荐阅读FaceBook推出的通用EventEmiiter库的源码 (opens new window),相信你会有更多收获。
💬 面试官追问
订单页连续两次
emit('paid'),通过once注册的回调第一次抛错后第二次又执行,你认为单次语义应该怎样保证?若要求“至多执行一次”,应在调用回调前先移除包装函数,或用
try/finally确保异常后仍完成注销。示例实现先调用再off,回调抛错会跳过清理;同时cb.apply(...args)也没有正确传入thisArg,宜改为直接调用或显式约定上下文。Vue页面每次进入都执行bus.$on('refresh', handler),离开后没有解绑,几次往返后一次发布刷新多次,你会怎样落地清理?订阅应与组件生命周期绑定,在组件销毁或卸载阶段用同一个函数引用执行
$off或封装后的off。匿名函数若没有保存引用就难以精确移除;全局总线还会隐藏组件依赖,因此应把订阅位置、事件名和清理责任放在同一模块内。事件中心要支持同一事件的一万个监听器,并允许监听器在
emit过程中调用off,你会怎样避免遍历结果不稳定?发布时应明确快照语义,例如复制当前监听列表后再逐个调用,使本轮新增或删除不会意外改变遍历范围。直接对原数组
splice可能跳过后续回调,而过滤后重新赋值也要处理回调抛错;监听器很多时仍是线性调用,不能把事件总线当作无成本广播。线上点击一次按钮却触发两次处理函数,监控只记录了一个
emit,你会按什么路径定位?先检查该事件当前保存的监听器数量和函数身份,再核对组件是否重复挂载、热更新后是否遗留订阅,以及
on与once是否同时注册了同一函数。随后给注册和注销增加调用来源日志;单次emit出现双回调,通常说明订阅状态重复而非发布次数异常。跨层级组件通信时,一方主张全局
EventBus,另一方要求使用集中式状态管理,你会如何划分边界?短生命周期、一次性的松耦合通知可以使用
EventBus,前提是事件名、载荷和注销责任明确。需要持久状态、可追踪更新或多个页面共同读取时,集中式状态管理更容易理解数据来源;全局事件过多会形成隐式依赖,排查顺序和生命周期成本会迅速上升。
# 3 实现一个双向绑定
⚡ 30 秒速记
- 双向绑定可以用数据劫持配合输入事件实现,让数据变化更新视图,视图变化再写回数据。
Object.defineProperty通过重写属性的set,同步修改input.value和span.innerHTML;输入框的keyup事件则把值写回data.text。- 也可以用
Proxy统一拦截属性赋值,不过后续读写必须通过代理对象,直接修改原始data不会触发这层拦截。
双向绑定可以用数据劫持配合输入事件实现,让数据变化更新视图,视图变化再写回数据。 Object.defineProperty 通过重写属性的 set,同步修改 input.value 和 span.innerHTML;输入框的 keyup 事件则把值写回 data.text。也可以用 Proxy 统一拦截属性赋值,不过后续读写必须通过代理对象,直接修改原始 data 不会触发这层拦截。
defineProperty 版本
// 数据
const data = {
  text: 'default'
};
const input = document.getElementById('input');
const span = document.getElementById('span');
// 数据劫持
Object.defineProperty(data, 'text', {
  // 数据变化 --> 修改视图
  set(newVal) {
    input.value = newVal;
    span.innerHTML = newVal;
  }
});
// 视图更改 --> 数据变化
input.addEventListener('keyup', function(e) {
  data.text = e.target.value;
});
proxy 版本
// 数据
const data = {
  text: 'default'
};
const input = document.getElementById('input');
const span = document.getElementById('span');
// 数据劫持
const handler = {
  set(target, key, value) {
    target[key] = value;
    // 数据变化 --> 修改视图
    input.value = value;
    span.innerHTML = value;
    return value;
  }
};
const proxy = new Proxy(data, handler);

// 视图更改 --> 数据变化
input.addEventListener('keyup', function(e) {
  proxy.text = e.target.value;
});
💬 面试官追问
表单初始化时
data.text是default,但输入框为空;随后业务代码读取data.text又得到undefined,你怎么解释这两个现象?这段
defineProperty只定义了set,既没有首次渲染,也没有保留并返回属性值,所以初始视图为空且读取结果为undefined。应使用闭包保存值并补充get,挂载时主动同步一次视图;否则它只是单向触发器,不是完整的数据属性。资料编辑页同时包含文本框、数字框和复选框,产品要求用户粘贴、语音输入和移动端联想输入都能同步,你会怎样改事件层?
不能只监听
keyup,应按控件类型监听input或change,并分别读取value、checked,必要时完成数字转换。中文输入法还要关注组合输入过程,避免中间态过早写回;统一使用字符串也会造成业务层类型漂移。同一状态绑定到两个输入框和一个预览区,任一输入都要更新另外两处;现有代码把
input、span写死在拦截器里,你会怎样拆?应让属性变化只负责通知订阅者,由每个控件注册自己的更新函数,输入事件则统一写入代理状态。这样一个属性可以关联多个视图,也能在节点卸载时取消订阅;若仍把节点闭包留在订阅集合中,会产生重复更新和内存滞留。
线上开启严格模式后,给
proxy.text赋空字符串偶发抛出TypeError,而赋普通文本正常,故障点在哪里?Proxy的settrap应返回表示写入是否成功的布尔值,源码却返回了value,空字符串会被判为失败并在严格模式下抛错。写入可用Reflect.set(target, key, value)并返回其结果;同时应只在成功后更新视图。评论预览页把用户输入通过
span.innerHTML = value展示,安全同学认为存在风险;保持纯文本预览时你选什么方案?应改用
textContent,因为innerHTML会把输入解释为标记,未可信内容可能形成脚本注入。若产品确实需要富文本,则必须在进入渲染层前采用明确的白名单净化;简单转义容易遗漏属性、协议等攻击面。团队争论这里该用
Object.defineProperty还是Proxy:状态对象会动态新增字段,但还要兼容无法使用Proxy的旧环境,你怎么定边界?动态新增字段更适合由
Proxy统一拦截,而Object.defineProperty只能预先改造已有属性,新增键需要额外API处理。若旧环境是硬约束,只能选择预定义字段或显式赋值入口;两套响应式机制并存会增加行为差异和测试成本。
# 4 实现一个简易的MVVM
⚡ 30 秒速记
- 简易
MVVM的核心是把数据转成响应式属性,并在模板读取数据时收集对应的视图依赖。 - 我一般用
Object.defineProperty改写get和set,由Dep保存当前依赖,赋值时再逐个通知视图更新。 - 模板编译阶段递归遍历节点,识别
{<span class="vp-brace-split" aria-hidden="true"></span>{ key }<span class="vp-brace-split" aria-hidden="true"></span>},替换初始内容并触发一次get完成依赖收集。 - 这个实现偏演示性质;数组还要通过改写
push、shift等方法补充变更通知。
简易 MVVM 的核心是把数据转成响应式属性,并在模板读取数据时收集对应的视图依赖。 我一般用 Object.defineProperty 改写 get 和 set,由 Dep 保存当前依赖,赋值时再逐个通知视图更新。模板编译阶段递归遍历节点,识别 {<span class="vp-brace-split" aria-hidden="true"></span>{ key }<span class="vp-brace-split" aria-hidden="true"></span>},替换初始内容并触发一次 get 完成依赖收集。这个实现偏演示性质;数组还要通过改写 push、shift 等方法补充变更通知。
实现一个简易的
MVVM我会分为这么几步来:
- 首先我会定义一个类
Vue,这个类接收的是一个options,那么其中可能有需要挂载的根元素的id,也就是el属性;然后应该还有一个data属性,表示需要双向绑定的数据 - 其次我会定义一个
Dep类,这个类产生的实例对象中会定义一个subs数组用来存放所依赖这个属性的依赖,已经添加依赖的方法addSub,删除方法removeSub,还有一个notify方法用来遍历更新它subs中的所有依赖,同时Dep类有一个静态属性target它用来表示当前的观察者,当后续进行依赖收集的时候可以将它添加到dep.subs中。 - 然后设计一个
observe方法,这个方法接收的是传进来的data,也就是options.data,里面会遍历data中的每一个属性,并使用Object.defineProperty()来重写它的get和set,那么这里面呢可以使用new Dep()实例化一个dep对象,在get的时候调用其addSub方法添加当前的观察者Dep.target完成依赖收集,并且在set的时候调用dep.notify方法来通知每一个依赖它的观察者进行更新 - 完成这些之后,我们还需要一个
compile方法来将HTML模版和数据结合起来。在这个方法中首先传入的是一个node节点,然后遍历它的所有子级,判断是否有firstElmentChild,有的话则进行递归调用compile方法,没有firstElementChild的话且该child.innderHTML用正则匹配满足有/\{\{(.*)\}\}/项的话则表示有需要双向绑定的数据,那么就将用正则new Reg('\\{\\{\\s*' + key + '\\s*\\}\\}', 'gm')替换掉{<span class="vp-brace-split" aria-hidden="true"></span>{ msg }<span class="vp-brace-split" aria-hidden="true"></span>}是其为msg变量。 - 完成变量替换的同时,还需要将
Dep.target指向当前的这个child,且调用一下this.opt.data[key],也就是为了触发这个数据的get来对当前的child进行依赖收集,这样下次数据变化的时候就能通知child进行视图更新了,不过在最后要记得将Dep.target指为null哦(其实在Vue中是有一个targetStack栈用来存放target的指向的) - 那么最后我们只需要监听
document的DOMContentLoaded然后在回调函数中实例化这个Vue对象就可以了
coding:
需要注意的点:
childNodes会获取到所有的子节点以及文本节点(包括元素标签中的空白节点)firstElementChild表示获取元素的第一个字元素节点,以此来区分是不是元素节点,如果是的话则调用compile进行递归调用,否则用正则匹配- 这里面的正则真的不难,大家可以看一下
完整代码如下:
<!DOCTYPE html>
<html lang="en">
  <head>
    <meta charset="UTF-8" />
    <meta name="viewport" content="width=device-width, initial-scale=1.0" />
    <meta http-equiv="X-UA-Compatible" content="ie=edge" />
    <title>MVVM</title>
  </head>
  <body>
    <div id="app">
      <h3>姓名</h3>
      <p>{{name}}</p>
      <h3>年龄</h3>
      <p>{{age}}</p>
    </div>
  </body>
</html>
<script>
  document.addEventListener(
    "DOMContentLoaded",
    function () {
      let opt = { el: "#app", data: { name: "等待修改...", age: 20 } };
      let vm = new Vue(opt);
      setTimeout(() => {
        opt.data.name = "jing";
      }, 2000);
    },
    false
  );
  class Vue {
    constructor(opt) {
      this.opt = opt;
      this.observer(opt.data);
      let root = document.querySelector(opt.el);
      this.compile(root);
    }
    observer(data) {
      Object.keys(data).forEach((key) => {
        let obv = new Dep();
        data["_" + key] = data[key];

        Object.defineProperty(data, key, {
          get() {
            Dep.target && obv.addSubNode(Dep.target);
            return data["_" + key];
          },
          set(newVal) {
            obv.update(newVal);
            data["_" + key] = newVal;
          },
        });
      });
    }
    compile(node) {
      [].forEach.call(node.childNodes, (child) => {
        if (!child.firstElementChild && /\{\{(.*)\}\}/.test(child.innerHTML)) {
          let key = RegExp.$1.trim();
          child.innerHTML = child.innerHTML.replace(
            new RegExp("\\{\\{\\s*" + key + "\\s*\\}\\}", "gm"),
            this.opt.data[key]
          );
          Dep.target = child;
          this.opt.data[key];
          Dep.target = null;
        } else if (child.firstElementChild) this.compile(child);
      });
    }
  }

  class Dep {
    constructor() {
      this.subNode = [];
    }
    addSubNode(node) {
      this.subNode.push(node);
    }
    update(newVal) {
      this.subNode.forEach((node) => {
        node.innerHTML = newVal;
      });
    }
  }
</script>
简化版2
function update(){
  console.log('数据变化~~~ mock update view')
}
let obj = [1,2,3]
// 变异方法 push shift unshfit reverse sort splice pop
// Object.defineProperty
let oldProto = Array.prototype;
let proto = Object.create(oldProto); // 克隆了一分
['push','shift'].forEach(item=>{
  proto[item] = function(){
    update();
    oldProto[item].apply(this,arguments);
  }
})
function observer(value){ // proxy reflect
  if(Array.isArray(value)){
    // AOP
    return value.__proto__ = proto;
    // 重写 这个数组里的push shift unshfit reverse sort splice pop
  }
  if(typeof value !== 'object'){
    return value;
  }
  for(let key in value){
    defineReactive(value,key,value[key]);
  }
}
function defineReactive(obj,key,value){
  observer(value); // 如果是对象 继续增加getter和setter
  Object.defineProperty(obj,key,{
    get(){
        return value;
    },
    set(newValue){
        if(newValue !== value){
            observer(newValue);
            value = newValue;
            update();
        }
    }
  })
}
observer(obj);
// AOP
// obj.name = {n:200}; // 数据变了 需要更新视图 深度监控
// obj.name.n = 100;
obj.push(123);
obj.push(456);
console.log(obj);
💬 面试官追问
页面模板是
<p>你好,{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>},明年 {<span class="vp-brace-split" aria-hidden="true"></span>{age}<span class="vp-brace-split" aria-hidden="true"></span>}</p>,编译后只更新一个字段甚至整段匹配错了;现有正则和节点判断为什么撑不住?/\{\{(.*)\}\}/是贪婪匹配,容易把同一节点中的多个插值吞成一个键;用innerHTML判断叶子节点也混淆了元素和文本。应遍历文本节点并用非贪婪、全局匹配逐个建立依赖,但复杂表达式仍需真正的解析器。后台表格一次渲染两千个插值节点,数据连续修改十次,当前
notify每次都同步遍历DOM;你会如何控制更新成本?依赖仍按属性收集,但通知阶段应把观察者放入去重队列,在一个微任务批次内统一刷新,避免同一节点连续改写。还应在编译期保存更新函数而非反复扫描模板;批处理会改变立即读取
DOM的时序,需要明确刷新边界。商品状态从
{detail:{price:10}}整体替换为新对象后,再修改detail.price页面不更新;这个简易观察器要补哪一步?属性
set接收新对象时必须先递归执行observer(newValue),再保存新值并通知外层依赖,否则新对象内部没有getter和setter。还要处理null、重复观测和循环引用;无保护的深度递归可能栈溢出或重复改写描述符。弹窗反复打开关闭后,一次改名触发几十次节点更新,开发者只看到
subs越来越长,你沿什么链路定位?先确认每次
compile是否重复创建观察者,再检查节点销毁时是否调用removeSub,以及同一观察者是否被重复加入。订阅集合可用Set去重,但不能替代卸载清理;闭包继续引用已移除节点时还会造成内存泄漏。架构评审中有人主张继续给数组改
__proto__,有人要求改用统一代理;列表数据会频繁push、索引赋值和改length,你怎么取舍?只覆写
push、shift无法覆盖索引赋值、length修改和其他变异方法,且直接改__proto__会给对象行为带来隐式差异。若运行环境允许,统一代理更容易覆盖这些入口;保留旧方案则必须完整包裹变异方法并接受检测范围有限。两个嵌套模板在编译时同时建立依赖,内层读取结束后把
Dep.target直接设为null,外层后续依赖丢失,你会怎样修正?当前观察者不能只用单个全局指针,应使用目标栈:进入求值时压栈并设为当前观察者,结束后恢复上一个目标。清理动作还应放进
finally,否则getter或更新函数抛错会污染后续依赖收集。
# 5 实现一个迷你版的vue
⚡ 30 秒速记
- 迷你版
Vue可以拆成数据代理、响应式监听、依赖管理和模板编译四块,串起来就能支持插值、v-text与v-model。 Vue先把$data属性代理到实例,再由Observer为属性定义getter和setter。Watcher读取属性时通过Dep.target被收集,数据变化后由Dep.notify()调用回调更新节点。v-model还要监听input事件写回实例;对象属性会递归处理,但这套代码只覆盖了较基础的模板和指令场景。
迷你版 Vue 可以拆成数据代理、响应式监听、依赖管理和模板编译四块,串起来就能支持插值、v-text 与 v-model。 Vue 先把 $data 属性代理到实例,再由 Observer 为属性定义 getter 和 setter。Watcher 读取属性时通过 Dep.target 被收集,数据变化后由 Dep.notify() 调用回调更新节点。v-model 还要监听 input 事件写回实例;对象属性会递归处理,但这套代码只覆盖了较基础的模板和指令场景。
入口
// js/vue.js
class Vue {
  constructor (options) {
    // 1. 通过属性保存选项的数据
    this.$options = options || {}
    this.$data = options.data || {}
    this.$el = typeof options.el === 'string' ? document.querySelector(options.el) : options.el
    // 2. 把data中的成员转换成getter和setter,注入到vue实例中
    this._proxyData(this.$data)
    // 3. 调用observer对象,监听数据的变化
    new Observer(this.$data)
    // 4. 调用compiler对象,解析指令和差值表达式
    new Compiler(this)
  }
  _proxyData (data) {
    // 遍历data中的所有属性
    Object.keys(data).forEach(key => {
      // 把data的属性注入到vue实例中
      Object.defineProperty(this, key, {
        enumerable: true,
        configurable: true,
        get () {
          return data[key]
        },
        set (newValue) {
          if (newValue === data[key]) {
            return
          }
          data[key] = newValue
        }
      })
    })
  }
}
实现Dep
class Dep {
  constructor () {
    // 存储所有的观察者
    this.subs = []
  }
  // 添加观察者
  addSub (sub) {
    if (sub && sub.update) {
      this.subs.push(sub)
    }
  }
  // 发送通知
  notify () {
    this.subs.forEach(sub => {
      sub.update()
    })
  }
}
实现watcher
class Watcher {
  constructor (vm, key, cb) {
    this.vm = vm
    // data中的属性名称
    this.key = key
    // 回调函数负责更新视图
    this.cb = cb

    // 把watcher对象记录到Dep类的静态属性target
    Dep.target = this
    // 触发get方法,在get方法中会调用addSub
    this.oldValue = vm[key]
    Dep.target = null
  }
  // 当数据发生变化的时候更新视图
  update () {
    let newValue = this.vm[this.key]
    if (this.oldValue === newValue) {
      return
    }
    this.cb(newValue)
  }
}
实现compiler
class Compiler {
  constructor (vm) {
    this.el = vm.$el
    this.vm = vm
    this.compile(this.el)
  }
  // 编译模板,处理文本节点和元素节点
  compile (el) {
    let childNodes = el.childNodes
    Array.from(childNodes).forEach(node => {
      // 处理文本节点
      if (this.isTextNode(node)) {
        this.compileText(node)
      } else if (this.isElementNode(node)) {
        // 处理元素节点
        this.compileElement(node)
      }

      // 判断node节点,是否有子节点,如果有子节点,要递归调用compile
      if (node.childNodes && node.childNodes.length) {
        this.compile(node)
      }
    })
  }
  // 编译元素节点,处理指令
  compileElement (node) {
    // console.log(node.attributes)
    // 遍历所有的属性节点
    Array.from(node.attributes).forEach(attr => {
      // 判断是否是指令
      let attrName = attr.name
      if (this.isDirective(attrName)) {
        // v-text --> text
        attrName = attrName.substr(2)
        let key = attr.value
        this.update(node, key, attrName)
      }
    })
  }

  update (node, key, attrName) {
    let updateFn = this[attrName + 'Updater']
    updateFn && updateFn.call(this, node, this.vm[key], key)
  }

  // 处理 v-text 指令
  textUpdater (node, value, key) {
    node.textContent = value
    new Watcher(this.vm, key, (newValue) => {
      node.textContent = newValue
    })
  }
  // v-model
  modelUpdater (node, value, key) {
    node.value = value
    new Watcher(this.vm, key, (newValue) => {
      node.value = newValue
    })
    // 双向绑定
    node.addEventListener('input', () => {
      this.vm[key] = node.value
    })
  }

  // 编译文本节点,处理差值表达式
  compileText (node) {
    // console.dir(node)
    // {{  msg }}
    let reg = /\{\{(.+?)\}\}/
    let value = node.textContent
    if (reg.test(value)) {
      let key = RegExp.$1.trim()
      node.textContent = value.replace(reg, this.vm[key])

      // 创建watcher对象,当数据改变更新视图
      new Watcher(this.vm, key, (newValue) => {
        node.textContent = newValue
      })
    }
  }
  // 判断元素属性是否是指令
  isDirective (attrName) {
    return attrName.startsWith('v-')
  }
  // 判断节点是否是文本节点
  isTextNode (node) {
    return node.nodeType === 3
  }
  // 判断节点是否是元素节点
  isElementNode (node) {
    return node.nodeType === 1
  }
}
实现Observer
class Observer {
  constructor (data) {
    this.walk(data)
  }
  walk (data) {
    // 1. 判断data是否是对象
    if (!data || typeof data !== 'object') {
      return
    }
    // 2. 遍历data对象的所有属性
    Object.keys(data).forEach(key => {
      this.defineReactive(data, key, data[key])
    })
  }
  defineReactive (obj, key, val) {
    let that = this
    // 负责收集依赖,并发送通知
    let dep = new Dep()
    // 如果val是对象,把val内部的属性转换成响应式数据
    this.walk(val)
    Object.defineProperty(obj, key, {
      enumerable: true,
      configurable: true,
      get () {
        // 收集依赖
        Dep.target && dep.addSub(Dep.target)
        return val
      },
      set (newValue) {
        if (newValue === val) {
          return
        }
        val = newValue
        that.walk(newValue)
        // 发送通知
        dep.notify()
      }
    })
  }
}
使用
<!DOCTYPE html>
<html lang="cn">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <meta http-equiv="X-UA-Compatible" content="ie=edge">
  <title>Mini Vue</title>
</head>
<body>
  <div id="app">
    <h1>差值表达式</h1>
    <h3>{{ msg }}</h3>
    <h3>{{ count }}</h3>
    <h1>v-text</h1>
    <div v-text="msg"></div>
    <h1>v-model</h1>
    <input type="text" v-model="msg">
    <input type="text" v-model="count">
  </div>
  <script src="./js/dep.js"></script>
  <script src="./js/watcher.js"></script>
  <script src="./js/compiler.js"></script>
  <script src="./js/observer.js"></script>
  <script src="./js/vue.js"></script>
  <script>
    let vm = new Vue({
      el: '#app',
      data: {
        msg: 'Hello Vue',
        count: 100,
        person: { name: 'zs' }
      }
    })
    console.log(vm.msg)
    // vm.msg = { test: 'Hello' }
    vm.test = 'abc'
  </script>
</body>
</html>
💬 面试官追问
模板里写了
{<span class="vp-brace-split" aria-hidden="true"></span>{person.name}<span class="vp-brace-split" aria-hidden="true"></span>},person.name已被递归转成响应式,但页面显示undefined;为什么响应式存在,编译器却读不到?编译器把整个
person.name当作vm的一级键读取,而_proxyData只代理了顶层person,因此路径解析失败。需要按路径逐段取值并在求值过程中触发各层getter;还要规定中间值为null时的展示与报错策略。设置页有三百个
v-model控件,路由切换后节点被移除,但Dep.subs仍持有所有Watcher,你会怎样补生命周期?每个
Watcher应记录自己订阅过的Dep,卸载编译结果时逐一解除订阅,并移除对应的DOM事件监听器。仅把subs改成Set只能防重复,不能释放失效节点;没有组件生命周期时需额外设计销毁入口。条件渲染让某个观察器本次读取
a、下次改读b,之后修改a仍触发更新;当前实现缺少什么机制?当前依赖只增不减,观察器切换读取分支后仍留在
a的订阅列表中。更新前应保存旧依赖、重新收集本轮依赖,再从未命中的Dep中移除自己;这会增加集合维护成本,但能避免陈旧订阅。线上出现
msg从A改成B、再改回A后每次更新逻辑异常,检查发现Watcher.oldValue始终是初始值,你怎么修?update在执行回调后必须把oldValue更新为本次的newValue,否则后续相等判断一直以初始值为基准。赋值时机要结合回调异常处理决定;若回调失败却提前提交旧值,重试时可能被错误跳过。文本节点是
订单:{<span class="vp-brace-split" aria-hidden="true"></span>{count}<span class="vp-brace-split" aria-hidden="true"></span>} 件,状态:{<span class="vp-brace-split" aria-hidden="true"></span>{status}<span class="vp-brace-split" aria-hidden="true"></span>},当前编译器只建立一个观察者;要支持多个插值,你会改模板还是引入虚拟DOM?这个规模下可先保存原始文本,提取全部键,并为每个键建立观察者,任一变化时用当前数据重新渲染整段文本。无需仅为多插值引入虚拟
DOM;但表达式、条件和列表逐渐增多后,正则编译器的维护成本会迅速上升。产品要求给迷你框架增加计算属性:它依赖
price和count,只有依赖变化时才重新计算;现有Dep与Watcher怎么串起来?可让计算属性拥有惰性
Watcher和脏标记,首次读取时求值并收集price、count,依赖通知时只标脏。外层视图读取计算属性时还需建立二级依赖,否则重新计算后视图不会更新;依赖栈恢复也必须可靠。
# 6 实现Vue reactive响应式
⚡ 30 秒速记
- 这个
reactive的实现本质上是用属性访问器收集依赖,并在赋值时通知相关Watcher重新执行。 reactive会递归遍历对象,defineReactive为每个属性创建独立的Dep,在get中调用depend(),在set中调用notify()。Watcher执行副作用前后通过pushTarget和popTarget维护当前观察者,栈结构也能保留嵌套执行时的上一个目标。- 需要注意,示例没有跳过相同值赋值,也没有把后来整体赋入的新对象继续转成响应式。
这个 reactive 的实现本质上是用属性访问器收集依赖,并在赋值时通知相关 Watcher 重新执行。 reactive 会递归遍历对象,defineReactive 为每个属性创建独立的 Dep,在 get 中调用 depend(),在 set 中调用 notify()。Watcher 执行副作用前后通过 pushTarget 和 popTarget 维护当前观察者,栈结构也能保留嵌套执行时的上一个目标。需要注意,示例没有跳过相同值赋值,也没有把后来整体赋入的新对象继续转成响应式。
// Dep module
class Dep {
  static stack = []
  static target = null
  deps = null

  constructor() {
    this.deps = new Set()
  }

  depend() {
    if (Dep.target) {
      this.deps.add(Dep.target)
    }
  }

  notify() {
    this.deps.forEach(w => w.update())
  }

  static pushTarget(t) {
    if (this.target) {
      this.stack.push(this.target)
    }
    this.target = t
  }

  static popTarget() {
    this.target = this.stack.pop()
  }
}

// reactive
function reactive(o) {
  if (o && typeof o === 'object') {
    Object.keys(o).forEach(k => {
      defineReactive(o, k, o[k])
    })
  }
  return o
}

function defineReactive(obj, k, val) {
  let dep = new Dep()
  Object.defineProperty(obj, k, {
    get() {
      dep.depend()
      return val
    },
    set(newVal) {
      val = newVal
      dep.notify()
    }
  })
  if (val && typeof val === 'object') {
    reactive(val)
  }
}

// watcher
class Watcher {
  constructor(effect) {
    this.effect = effect
    this.update()
  }

  update() {
    Dep.pushTarget(this)
    this.value = this.effect()
    Dep.popTarget()
    return this.value
  }
}

// 测试代码
const data = reactive({
  msg: 'aaa'
})

new Watcher(() => {
  console.log('===> effect', data.msg);
})

setTimeout(() => {
  data.msg = 'hello'
}, 1000)
💬 面试官追问
观察器执行
flag ? data.a : data.b,切换flag后再改a仍然触发;使用了Set为什么还会有无效更新?Set只避免同一个Dep重复保存观察器,并不会删除上一轮执行产生的旧依赖。观察器需要在每次执行前后比较依赖集合,并从未再次访问的属性中退订;否则动态分支越多,陈旧订阅越多。行情页每秒连续写入同一字段多次,当前
set每次同步运行所有观察器,主线程出现卡顿;你会在哪一层合并?应在通知层把观察器加入按身份去重的调度队列,并在微任务中批量执行,而不是让每次赋值立即重跑副作用。这样最终状态只渲染一次,但同步读取副作用结果的代码会看到旧值,需要提供明确的立即刷新能力。
业务把
data.user替换成{name:'B'},随后修改data.user.name没有触发观察器;源码中的递归位置错在哪里?源码只在定义属性时递归处理初始
val,set保存新对象后没有再次调用reactive(newVal)。应先观测新值再通知依赖,并跳过相同值;循环引用和重复对象还需借助缓存集合避免无限递归。某个副作用抛异常后,后续普通读取也被错误收集到该观察器,最终更新链路越来越乱,你如何定位并修复?
Watcher.update中的Dep.popTarget()没有放在finally,副作用抛错会让全局target无法恢复。应以try...finally包住求值,并核对目标栈是否成对进出;错误传播策略仍需单独决定,不能靠吞掉异常维持栈状态。同一对象先被
reactive两次,属性描述符又默认变成不可枚举、不可配置,序列化和二次改造出现异常;实现应补哪些约束?定义响应式属性时应显式保留
enumerable、合理设置configurable,并用标记或弱缓存避免重复包装同一对象。还要读取并尊重原有描述符,访问器属性不能直接当普通值覆盖;否则会破坏对象既有语义。技术负责人想把这套
Object.defineProperty实现扩展到动态新增键、删除键、数组索引和length,你会继续补丁还是改成Proxy?这些变化无法由已存在属性的
setter完整覆盖,继续补丁通常需要显式新增、删除API,并单独劫持数组变异方法。环境允许时更适合用Proxy配合Reflect统一拦截;代价是代理对象身份、嵌套缓存和兼容范围都要重新设计。
# 7 实现模板字符串解析功能
⚡ 30 秒速记
- 可以用正则匹配
{<span class="vp-brace-split" aria-hidden="true"></span>{字段名}<span class="vp-brace-split" aria-hidden="true"></span>},取出字段名后从data读取对应值,再递归替换,直到模板中没有占位符。 - 这里的
/\{\{(\w+)\}\}/每次只匹配第一个占位符,所以递归负责继续处理后面的内容。 - 比如
name和age会被正常替换,而不存在的sex读取结果是undefined。 - 这个实现只支持由单词字符组成的简单字段名,不包含嵌套路径或表达式解析。
可以用正则匹配 {<span class="vp-brace-split" aria-hidden="true"></span>{字段名}<span class="vp-brace-split" aria-hidden="true"></span>},取出字段名后从 data 读取对应值,再递归替换,直到模板中没有占位符。 这里的 /\{\{(\w+)\}\}/ 每次只匹配第一个占位符,所以递归负责继续处理后面的内容。比如 name 和 age 会被正常替换,而不存在的 sex 读取结果是 undefined。这个实现只支持由单词字符组成的简单字段名,不包含嵌套路径或表达式解析。
let template = '我是{{name}},年龄{{age}},性别{{sex}}';
let data = {
  name: '姓名',
  age: 18
}
render(template, data); // 我是姓名,年龄18,性别undefined
function render(template, data) {
  const reg = /\{\{(\w+)\}\}/; // 模板字符串正则
  if (reg.test(template)) { // 判断模板里是否有模板字符串
    const name = reg.exec(template)[1]; // 查找当前模板里第一个模板字符串的字段
    template = template.replace(reg, data[name]); // 将第一个模板字符串渲染
    return render(template, data); // 递归的渲染并返回渲染后的结构
  }
  return template; // 如果模板没有模板字符串直接返回
}
💬 面试官追问
通知模板写成
{<span class="vp-brace-split" aria-hidden="true"></span>{ user.name }<span class="vp-brace-split" aria-hidden="true"></span>}和{<span class="vp-brace-split" aria-hidden="true"></span>{订单号}<span class="vp-brace-split" aria-hidden="true"></span>},当前渲染后原样保留;为什么示例能跑,这两个键却不行?正则中的
\w+只接受有限的单词字符,既不支持点路径,也不能覆盖中文键和表达式两侧空白。若只允许键路径,应明确语法并逐段安全取值;若要支持任意表达式,就不能继续靠这条正则隐式扩张能力。邮件批量发送十万条记录,每个模板含二十个占位符,当前实现每替换一个就递归并重新扫描字符串,你会怎样落地?
可用全局替换一次遍历全部占位符,在回调中按键读取数据,避免反复创建字符串和递归调用。模板会重复使用时还可预编译为文本片段与键列表;缓存必须按模板内容隔离,否则会复用错误结构。
产品要求缺失字段显示空串,而字段值为
0、false时必须保留;你会怎样定义替换规则?应通过键是否自有或路径是否可达来判断缺失,缺失时返回空串,不能使用
data[name] || '',否则0和false会被误删。还要明确null是否展示为空;这是产品语义,不能由JavaScript的真假规则代替。线上某条数据的
name恰好是{<span class="vp-brace-split" aria-hidden="true"></span>{name}<span class="vp-brace-split" aria-hidden="true"></span>},渲染线程最终栈溢出;这段递归为什么无法终止,怎么止损?替换结果重新生成了同一个占位符,下一轮正则仍能命中,因此递归永不结束。一次性按原模板匹配并替换可消除这类自引用,也可设置替换上限;若允许递归模板,则必须显式检测循环依赖。
用户昵称是
$&或$1时,页面显示成占位符原文或其他异常文本;数据明明取对了,故障发生在哪一层?把字符串直接作为
replace的替换参数时,$&、$1等会被解释为特殊替换模式,而不是普通数据。应传入返回值的函数,如template.replace(reg, () => value);同时要统一把非字符串值安全转换。安全评审要求模板支持
{<span class="vp-brace-split" aria-hidden="true"></span>{user.name}<span class="vp-brace-split" aria-hidden="true"></span>},但禁止访问__proto__、constructor等原型链属性;路径解析器该怎样约束?逐段读取时应只允许约定格式的键,并用自有属性检查拒绝原型链穿透,同时显式封禁危险路径片段。若数据最终进入
HTML,还需按输出上下文转义;路径安全不能替代针对文本、属性或URL的注入防护。
# 8 实现一下hash路由
⚡ 30 秒速记
hash路由本质上是监听hashchange,读取location.hash并根据变化更新页面内容。- 链接使用
#red、#green这类地址,触发变化后通过slice(1)去掉#,再把结果交给渲染逻辑。 - 封装成
HashRouter时,可以在构造阶段执行一次watchHash,同时注册绑定好this的监听函数。 - 简单写法要在回调里重新读取
location.hash,否则外部缓存的值不会随路由变化。
hash 路由本质上是监听 hashchange,读取 location.hash 并根据变化更新页面内容。 链接使用 #red、#green 这类地址,触发变化后通过 slice(1) 去掉 #,再把结果交给渲染逻辑。封装成 HashRouter 时,可以在构造阶段执行一次 watchHash,同时注册绑定好 this 的监听函数。简单写法要在回调里重新读取 location.hash,否则外部缓存的值不会随路由变化。
基础的html代码:
<html>
  <style>
    html, body {
      margin: 0;
      height: 100%;
    }
    ul {
      list-style: none;
      margin: 0;
      padding: 0;
      display: flex;
      justify-content: center;
    }
    .box {
      width: 100%;
      height: 100%;
      background-color: red;
    }
  </style>
  <body>
  <ul>
    <li>
      <a href="#red">红色</a>
    </li>
    <li>
      <a href="#green">绿色</a>
    </li>
    <li>
      <a href="#purple">紫色</a>
    </li>
  </ul>
  </body>
</html>
简单实现:
<script>
  const box = document.getElementsByClassName('box')[0];
  const hash = location.hash
  window.onhashchange = function (e) {
    const color = hash.slice(1)
    box.style.background = color
  }
</script>
封装成一个class:
<script>
  const box = document.getElementsByClassName('box')[0];
  const hash = location.hash
  class HashRouter {
    constructor (hashStr, cb) {
      this.hashStr = hashStr
      this.cb = cb
      this.watchHash()
      this.watch = this.watchHash.bind(this)
      window.addEventListener('hashchange', this.watch)
    }
    watchHash () {
      let hash = window.location.hash.slice(1)
      this.hashStr = hash
      this.cb(hash)
    }
  }
  new HashRouter('red', (color) => {
    box.style.background = color
  })
</script>
💬 面试官追问
商品详情页从
#red切到#green,地址栏已经变化但背景仍保持红色;按简单实现逐行看,最可能是哪一行导致的?问题在事件外缓存了
const hash = location.hash,hashchange触发后读取的仍是首次值。应在回调内重新读取window.location.hash.slice(1),并确认页面确实存在.box;否则即使路由值正确,访问box.style也会报错。后台管理页首次通过收藏链接打开
/#purple,没有发生任何点击,页面应该如何完成首屏渲染并持续监听后续变化?注册监听并不会自动触发
hashchange,构造阶段需要主动执行一次watchHash(),源码中的类实现已经这样处理。随后用绑定后的同一函数监听事件,首屏和后续跳转便复用同一套解析逻辑;回调自身异常仍需由调用方决定如何兜底。路由从单个颜色扩展到
#/user/42?tab=orders,产品还要求未知地址进入默认页,现有slice(1)后直接当颜色使用的设计要怎么改?应把哈希值先解析成路径、参数和查询信息,再用路由表匹配处理函数,未匹配项显式落到默认路由。不要把未经校验的完整字符串直接写入样式或业务状态;手写解析越复杂,编码、空片段和参数冲突的维护成本越高。
线上偶发一次导航触发两次渲染,监控显示同一个页面被反复挂载;你会怎样确认是不是
HashRouter的监听器泄漏?先记录实例创建次数与每次
hashchange的回调次数,并检查页面卸载后监听是否仍存在。类中保存了绑定函数this.watch,应增加destroy()调用removeEventListener('hashchange', this.watch);若生命周期没有可靠卸载点,重复实例化仍会继续累积监听。支付完成页需要干净
URL、服务端直达与浏览器前进后退,团队在哈希路由和History API之间争论,你会怎么选?若部署环境无法把任意路径回退到同一入口文件,哈希路由更容易落地,因为
#后内容通常不参与服务端请求。若需要正常路径和服务端直达,可选History API,但必须配置回退规则;错误配置会让刷新深层地址直接返回404。
# 9 实现redux中间件
⚡ 30 秒速记
- 实现
Redux中间件的关键,是用applyMiddleWare包装createStore,再把多个中间件组合成新的dispatch。 - 每个中间件接收包含
getState和dispatch的接口,返回一个接收next的函数,从而决定处理当前action还是继续向后传递。 compose负责把这条调用链嵌套起来,最终仍落到原始store.dispatch。- 基础版还需要保存状态与订阅函数,并先派发初始化
action,但示例中的取消订阅只是空实现。
实现 Redux 中间件的关键,是用 applyMiddleWare 包装 createStore,再把多个中间件组合成新的 dispatch。 每个中间件接收包含 getState 和 dispatch 的接口,返回一个接收 next 的函数,从而决定处理当前 action 还是继续向后传递。compose 负责把这条调用链嵌套起来,最终仍落到原始 store.dispatch。基础版还需要保存状态与订阅函数,并先派发初始化 action,但示例中的取消订阅只是空实现。
简单实现
function createStore(reducer) {
  let currentState
  let listeners = []

  function getState() {
    return currentState
  }

  function dispatch(action) {
    currentState = reducer(currentState, action)
    listeners.map(listener => {
      listener()
    })
    return action
  }

  function subscribe(cb) {
    listeners.push(cb)
    return () => {}
  }

  dispatch({type: 'ZZZZZZZZZZ'})

  return {
    getState,
    dispatch,
    subscribe
  }
}

// 应用实例如下:
function reducer(state = 0, action) {
  switch (action.type) {
    case 'ADD':
      return state + 1
    case 'MINUS':
      return state - 1
    default:
      return state
  }
}

const store = createStore(reducer)

console.log(store);
store.subscribe(() => {
  console.log('change');
})
console.log(store.getState());
console.log(store.dispatch({type: 'ADD'}));
console.log(store.getState());
2. 迷你版
export const createStore = (reducer,enhancer)=>{
	if(enhancer) {
		return enhancer(createStore)(reducer)
	}
	let currentState = {}
	let currentListeners = []

	const getState = ()=>currentState
	const subscribe = (listener)=>{
		currentListeners.push(listener)
	}
	const dispatch = action=>{
		currentState = reducer(currentState, action)
		currentListeners.forEach(v=>v())
		return action
	}
	dispatch({type:'@@INIT'})
	return {getState,subscribe,dispatch}
}

//中间件实现
export applyMiddleWare(...middlewares){
	return createStore=>...args=>{
		const store = createStore(...args)
		let dispatch = store.dispatch

		const midApi = {
			getState:store.getState,
			dispatch:...args=>dispatch(...args)
		}
		const middlewaresChain = middlewares.map(middleware=>middleware(midApi))
		dispatch = compose(...middlewaresChain)(store.dispatch)
		return {
			...store,
			dispatch
		}
	}

// fn1(fn2(fn3())) 把函数嵌套依次调用
export function compose(...funcs){
	if(funcs.length===0){
		return arg=>arg
	}
	if(funs.length===1){
		return funs[0]
	}
	return funcs.reduce((ret,item)=>(...args)=>ret(item(...args)))
}


//bindActionCreator实现

function bindActionCreator(creator,dispatch){
    return ...args=>dispatch(creator(...args))
}
function bindActionCreators(creators,didpatch){
    //let bound = {}
    //Object.keys(creators).forEach(v=>{
   //     let creator = creator[v]
     //   bound[v] = bindActionCreator(creator,dispatch)
    //})
    //return bound

    return Object.keys(creators).reduce((ret,item)=>{
	    ret[item] = bindActionCreator(creators[item],dispatch)
    	return ret
    },{})
}
💬 面试官追问
日志中间件、异常捕获中间件和业务中间件按顺序传入
applyMiddleWare,但日志显示的包裹顺序反了;你会怎样验证compose是否真的形成了fn1(fn2(fn3(dispatch)))?用三个只记录进入与退出顺序的中间件验证,正确结果应表现为外层先进入、内层先退出。源码的
reduce意图是右侧函数先作为参数执行,但其中funs与funcs拼写不一致会直接报错;修正后还要覆盖零个和一个函数的分支。一个中间件内部执行
dispatch({type:'AUDIT'}),另一个中间件稍后才完成组合;为什么midApi.dispatch不能直接写成创建时的store.dispatch?midApi.dispatch必须通过闭包转发到最终变量dispatch,这样中间件内部再次派发时会经过完整中间件链。若捕获原始store.dispatch,再派发会绕过日志、异步等后续能力;但中间件无条件重复派发同类动作仍可能造成递归循环。订单页一次注册了 200 个订阅者,页面销毁后仍全部收到更新;按这份
createStore,你会补哪段生命周期能力?subscribe应返回取消订阅函数,由它从监听集合中移除对应回调,页面卸载时必须调用该函数。通知时还应避免直接遍历一个正在被增删的数组,可对监听列表做快照;否则回调中的订阅变化可能让本轮通知出现跳过或重复。某个中间件在处理动作时抛错,随后业务反馈状态没有更新;你会把异常定位在
reducer、中间件还是订阅回调的哪一层?先在每层进入和退出处记录动作类型,确认异常发生在调用
next(action)之前还是之后。之前抛错会阻止动作到达原始dispatch,reducer中抛错也不会完成赋值;订阅回调是在状态更新后执行,其异常可能中断后续监听器,但不能据此推断状态未变。团队想让中间件在运行期动态增删,另一方坚持沿用一次性
applyMiddleWare;现有实现支持哪一种,代价是什么?现有实现只在创建仓库时计算
middlewaresChain并组合最终dispatch,因此天然适合固定中间件集合。动态增删需要重新构建链并明确并发派发时采用哪一版;复杂度和可预测性都会下降,若没有插件化需求不值得引入。
# 10 实现redux-thunk
⚡ 30 秒速记
redux-thunk可以写成一个三层函数:拿到dispatch和getState,再接收next,最后处理action。- 当
action是函数时,直接调用它并传入dispatch、getState,因此函数内部可以继续派发操作或读取当前状态。 - 普通对象形式的
action则交给next(action),保证后续中间件和原有派发流程不受影响。 - 它只负责识别并执行函数,不会替函数本身实现具体异步逻辑。
redux-thunk 可以写成一个三层函数:拿到 dispatch 和 getState,再接收 next,最后处理 action。 当 action 是函数时,直接调用它并传入 dispatch、getState,因此函数内部可以继续派发操作或读取当前状态。普通对象形式的 action 则交给 next(action),保证后续中间件和原有派发流程不受影响。它只负责识别并执行函数,不会替函数本身实现具体异步逻辑。
redux-thunk可以利用redux中间件让redux支持异步的action
// 如果 action 是个函数,就调用这个函数
// 如果 action 不是函数,就传给下一个中间件
// 发现 action 是函数就调用
const thunk = ({ dispatch, getState }) => (next) => (action) => {
  if (typeof action === 'function') {
    return action(dispatch, getState);
  }

  return next(action);
};
export default thunk
💬 面试官追问
搜索页把普通动作
{type:'LOAD'}和函数动作混合派发,接在thunk后面的日志中间件为什么只能看到前者?函数动作命中
typeof action === 'function'后会被直接调用,不再传给next,因此后续中间件看不到这个函数本身。普通对象动作则交给next(action);若希望记录异步流程,应记录函数内部再次派发的开始、成功和失败动作。用户连续输入 10 次关键词,旧请求晚于新请求返回并覆盖结果;只有
dispatch和getState的thunk要怎样避免旧数据落库?函数动作可以在请求前生成请求标识,响应时用
getState()对比当前标识,只允许最新请求派发成功动作。也可在外层配合取消请求,但这不由该中间件自动提供;若没有竞态约束,支持异步并不等于保证响应顺序正确。团队要求函数动作还能拿到
API客户端和埋点对象,但不允许在业务文件里到处导入单例;你会怎样扩展这段三层函数?可在创建中间件时注入额外依赖,再把它作为第三个参数传给函数动作,例如调用
action(dispatch, getState, extra)。这样便于替换测试依赖并限制全局耦合;依赖对象过大仍会形成隐式服务容器,需要明确可用能力。线上监控只收到未处理的
Promise拒绝,页面一直停在加载态;函数动作中的请求失败时,thunk本身会不会自动派发失败动作?这段实现只返回
action(dispatch, getState)的结果,不会捕获异常或自动生成失败动作。应在函数动作内部用try/catch/finally派发失败与结束状态,调用方也要按约定处理返回的Promise;遗漏任一层都可能留下未处理拒绝。购物车加一只是同步状态变化,开发者仍把每个动作都包装成函数;代码评审时你会保留这种写法吗?
纯同步且不依赖当前状态编排的操作直接派发普通动作更清晰,也能让后续中间件直接观察动作。函数动作适合需要读取
getState()、执行异步流程或连续派发的场景;全部包装会隐藏动作边界,却没有获得额外语义。
# 29 数组相关
# 1 实现forEach方法
⚡ 30 秒速记
- 实现
forEach的关键是依次遍历数组,并通过回调处理当前元素和索引。 - 这里先保存
this和数组长度,再用for循环调用callback.call,因此可以用context指定回调中的执行上下文。 - 实现会先判断
callback是否为函数,避免直接调用非函数值。 - 需要注意,这段代码只负责执行回调,不收集结果,也没有显式返回值。
实现 forEach 的关键是依次遍历数组,并通过回调处理当前元素和索引。 这里先保存 this 和数组长度,再用 for 循环调用 callback.call,因此可以用 context 指定回调中的执行上下文。实现会先判断 callback 是否为函数,避免直接调用非函数值。需要注意,这段代码只负责执行回调,不收集结果,也没有显式返回值。
Array.prototype.myForEach = function(callback, context=window) {
  // this=>arr
  let self = this,
      i = 0,
      len = self.length;

  for(;i<len;i++) {
    typeof callback == 'function' && callback.call(context,self[i], i)
   }
}
💬 面试官追问
稀疏数组
[1,,3]在表格批处理页中只应处理两个已有单元,但这份myForEach会把空槽当成undefined回调;你会改哪处?循环内应先判断索引是否存在,例如使用
i in self,再调用回调,从而跳过稀疏数组的空槽。只判断self[i] !== undefined不可靠,因为显式存储的undefined仍是有效元素;原型链上的同名索引也属于需要明确对齐的语义。批量勾选 500 行时,回调需要同时拿到元素、索引和原数组,但当前实现只传了两个参数;这会破坏哪类代码,怎么修?
依赖第三个参数修改或检查原数组的回调会拿不到目标对象,应调用
callback.call(context, self[i], i, self)。实现还应在开始前校验回调是否为函数,而不是静默跳过;静默失败会让调用方误以为批处理已经执行。回调处理到第 20 项时向数组尾部追加记录,又删除了尚未访问的第 30 项;这份提前保存
len的循环会呈现什么结果?初始
len已被快照,追加到原长度之外的元素不会进入本轮遍历。被删除的未访问索引若增加存在性检查就会跳过;当前源码没有该检查,会额外以undefined调用一次,因此与预期数组遍历语义不一致。同一段代码要运行在浏览器严格模式和
Node服务中,默认参数context=window直接报错;你会怎样保留调用方的thisArg语义?不要把
window作为默认值,直接接收可选的context并通过call传入即可。不同运行模式对空thisArg的实际绑定还有严格模式差异,应让函数调用规则自然决定;强制改成全局对象会造成跨环境不一致。线上上报显示某个回调在第 80 项抛错后,后续项目都未执行;你会在
myForEach内吞掉异常继续吗?默认不应吞掉回调异常,异常传播能保留调用栈,并让调用方知道遍历没有完整完成。若业务确实要求逐项容错,应由上层在回调内部捕获并记录失败项;通用实现强行继续会掩盖数据只处理了一部分的事实。
# 2 实现filter方法
⚡ 30 秒速记
- 实现
filter时,要遍历原数组,把回调判断为真的元素放进新数组并返回。 - 代码通过
callback.apply传入当前元素、索引和原数组,同时使用context控制回调的执行上下文。 - 因为结果存放在
newArr中,所以不会直接改动原数组。 - 回调返回假值时当前元素会被跳过,遍历完成后得到所有符合条件的元素。
实现 filter 时,要遍历原数组,把回调判断为真的元素放进新数组并返回。 代码通过 callback.apply 传入当前元素、索引和原数组,同时使用 context 控制回调的执行上下文。因为结果存放在 newArr 中,所以不会直接改动原数组。回调返回假值时当前元素会被跳过,遍历完成后得到所有符合条件的元素。
Array.prototype.myFilter=function(callback, context=window){

  let len = this.length
      newArr = [],
      i=0

  for(; i < len; i++){
    if(callback.apply(context, [this[i], i , this])){
      newArr.push(this[i]);
    }
  }
  return newArr;
}
💬 面试官追问
权限列表是稀疏数组,索引
2没有元素,但谓词会把undefined判为“匿名项”;为什么这份myFilter会错误地新增一项?循环无条件读取
this[i],空槽会以undefined传给回调,谓词返回真后又被推入结果。应先用i in this判断属性存在再执行谓词;不能用值是否为undefined代替,因为显式的undefined元素仍需参与筛选。商品页按库存筛选时,回调还要读取当前索引和完整商品数组;源码传入的三个参数是否够用,返回结果是否应复用原数组?
源码通过
apply传入元素、索引和原数组,满足这类谓词所需上下文。筛选结果应放进新的newArr,即使所有元素都通过也不复用原数组;元素对象本身仍是原引用,后续修改对象会同时影响两边。筛选 10 万条日志时,谓词在遍历中继续向原数组追加数据,产品要求本轮结果只基于开始时的数据;当前实现能否满足?
len在循环前读取,因此追加到原长度之外的数据不会进入本轮筛选,符合该约束。若谓词修改尚未访问的已有索引,后续读取会看到修改后的值;需要真正稳定快照时应先复制输入,但会增加内存和复制成本。服务端渲染阶段调用
myFilter,进程报window is not defined,而浏览器开发环境正常;根因和最小修正是什么?默认参数
context=window会在没有window的运行环境中求值失败。最小修正是移除该默认值,允许context为undefined并直接传给apply;若回调依赖特定上下文,应由调用方显式提供。风控筛选的谓词在第 300 项抛错,当前已经向
newArr推入部分数据;通用实现应该返回部分结果还是终止?应让异常继续向外传播并终止调用,不返回看似完整的部分结果,这也符合源码未捕获异常的行为。若业务要保留逐项失败信息,应在谓词或更高层建立错误集合;把容错塞进通用
filter会改变调用者对结果完整性的判断。
# 3 实现find方法
⚡ 30 秒速记
- 实现
find的本质是顺序遍历数组,并返回第一个让回调条件成立的元素。 - 每次调用回调时传入当前元素和索引,一旦结果为真就立刻
return,因此后面的元素不会继续检查。 - 比如按
id === 2查找用户时,会返回对应的用户对象。 - 如果遍历结束仍未命中,函数没有执行显式返回,最终得到
undefined。
实现 find 的本质是顺序遍历数组,并返回第一个让回调条件成立的元素。 每次调用回调时传入当前元素和索引,一旦结果为真就立刻 return,因此后面的元素不会继续检查。比如按 id === 2 查找用户时,会返回对应的用户对象。如果遍历结束仍未命中,函数没有执行显式返回,最终得到 undefined。
find接收一个方法作为参数,方法内部返回一个条件find会遍历所有的元素,执行你给定的带有条件返回值的函数- 符合该条件的元素会作为
find方法的返回值 - 如果遍历结束还没有符合该条件的元素,则返回
undefined
var users = [
  {id: 1, name: '张三'},
  {id: 2, name: '张三'},
  {id: 3, name: '张三'},
  {id: 4, name: '张三'}
]

Array.prototype.myFind = function (callback) {
  // var callback = function (item, index) { return item.id === 4 }
  for (var i = 0; i < this.length; i++) {
    if (callback(this[i], i)) {
      return this[i]
    }
  }
}

var ret = users.myFind(function (item, index) {
  return item.id === 2
})

console.log(ret)
💬 面试官追问
商品列表里第一个元素的库存是
0,回调返回item.stock === 0;有人把命中判断写成检查元素本身的真假值,页面会出现什么错误,你会怎样改?库存为
0的商品仍应被正常返回,因为find判断的是回调结果,而不是元素本身是否为真值。循环中应执行callback(this[i], i, this),结果为真时立即返回当前元素;遍历结束则明确返回undefined,避免把合法的假值元素误判为未命中。搜索建议组件每次输入都会在数千条本地记录上调用
myFind,产品要求行为尽量贴近原生find;你会补齐哪些调用约定?实现应校验
callback可调用,并把当前值、索引和原数组传给它,同时支持通过第二个参数绑定thisArg。命中后立即短路,回调抛出的异常应自然向上传播;若追求原生兼容,还要用对照测试确认稀疏数组和遍历期间数组变化的语义。权限数据不再是普通数组,而是带
length和数字键的类数组对象;现有Array.prototype.myFind还能怎样复用,限制在哪里?方法可以通过
Array.prototype.myFind.call(arrayLike, callback)复用,只要对象能按索引读取且具有合理的length。实现不应依赖数组专属方法,但需要处理this为空和长度转换;若输入是异步迭代器或无限序列,这种基于有限索引的方案就不适用。线上监控显示
myFind偶尔返回了后面的重复订单,而不是最前面的订单;代码使用正向for循环,你会优先排查哪些运行时变化?正向循环本应返回第一个满足条件的元素,因此先检查回调是否修改了数组、条件是否依赖可变外部状态,以及调用前的数据顺序是否已变化。再记录命中索引、关键字段和回调结果做最小复现;不要仅靠延长日志采样掩盖竞态或副作用。
代码评审中一方主张所有业务都换成手写
myFind便于控制,另一方坚持原生find;作为维护者你怎么定?业务代码应优先使用标准
find,手写版本更适合面试验证遍历、回调和短路返回的理解。自定义实现会承担类型校验、类数组、稀疏项和数组变更等兼容成本;只有确有特殊语义或运行环境约束时才值得封装,并需用原生行为建立回归用例。
# 4 实现findIndex方法
⚡ 30 秒速记
- 实现
findIndex时,应顺序执行判断回调,并在首次匹配时返回当前索引。 - 它和
find的遍历方式基本一致,区别是命中后返回i,而不是返回this[i]。 - 例如按用户的
id查找时,结果表示该用户在数组中的位置。 - 按这段实现,如果遍历结束仍未匹配,会因为没有显式返回值而得到
undefined;示例调用处也应对应使用myFindIndex。
实现 findIndex 时,应顺序执行判断回调,并在首次匹配时返回当前索引。 它和 find 的遍历方式基本一致,区别是命中后返回 i,而不是返回 this[i]。例如按用户的 id 查找时,结果表示该用户在数组中的位置。按这段实现,如果遍历结束仍未匹配,会因为没有显式返回值而得到 undefined;示例调用处也应对应使用 myFindIndex。
var users = [
  {id: 1, name: '张三'},
  {id: 2, name: '张三'},
  {id: 3, name: '张三'},
  {id: 4, name: '张三'}
]

Array.prototype.myFindIndex = function (callback) {
  // var callback = function (item, index) { return item.id === 4 }
  for (var i = 0; i < this.length; i++) {
    if (callback(this[i], i)) {
      // 这里返回
      return i
    }
  }
}

var ret = users.myFind(function (item, index) {
  return item.id === 2
})

console.log(ret)
💬 面试官追问
后台表格要定位第一个
id === 2的用户,现有示例却调用了users.myFind(...),页面拿到对象后当作下标使用;你怎样指出并修正这处错误?示例调用错了方法,
findIndex应返回命中元素的索引,而find返回元素本身。调用应改为users.myFindIndex(...),循环命中时返回i;未命中时还必须返回-1,否则undefined会让后续索引判断产生额外分支。批量选择组件用
if (users.myFindIndex(predicate))判断是否存在,命中首项时反而显示“未找到”;根因是什么,调用方应该怎么写?首项索引是
0,在条件表达式中会被当成假值,所以不能直接用索引的真假性表示是否命中。调用方应判断结果是否为-1,例如index !== -1;自定义实现若未命中返回undefined,也会偏离这套稳定约定。十万行虚拟表格要求查到首个异常行后立即停止,但同事先用
filter收集全部异常再取索引;你会如何取舍?这里只需要首个异常位置,
findIndex在首次命中后即可短路,更符合需求,也不会额外创建结果数组。实现中应在回调返回真值时直接return i;若后续还要展示全部异常行,才有理由单独遍历收集,不能混淆两种目标。线上出现“删除错行”,日志里保存的索引在异步确认框关闭后已失效;
findIndex本身返回正确,你会怎样修复数据流?索引只代表查找当时的位置,等待确认期间若数组排序、插入或删除,旧索引就可能指向另一条记录。确认后应根据稳定标识重新执行
findIndex,并校验命中元素的id;若没有稳定标识,仅靠位置无法可靠完成并发更新。数据去重逻辑既要知道重复项的位置,又要读取重复对象;团队争论用
find还是findIndex,你会怎样划分?后续需要修改或删除原数组指定位置时,
findIndex更直接;只消费对象内容时,find能避免再按索引读取。两者都应在首个命中处短路,但未命中哨兵不同,分别是-1与undefined;接口选择要让调用方不必反复转换。
# 5 实现map方法
⚡ 30 秒速记
myMap需要遍历数组,把当前值、索引和原数组传给回调,并将每次回调的返回值收集成新数组。- 实现中先用
slice把当前对象转成数组,再通过callback.call绑定传入的context。 - 原数组不会被直接修改,最终返回的是
mappedArr。 - 需要注意,回调接收的第三个参数仍然是
this指向的原对象,而不是转换后的arr。
myMap需要遍历数组,把当前值、索引和原数组传给回调,并将每次回调的返回值收集成新数组。 实现中先用slice把当前对象转成数组,再通过callback.call绑定传入的context。原数组不会被直接修改,最终返回的是mappedArr。需要注意,回调接收的第三个参数仍然是this指向的原对象,而不是转换后的arr。
- 回调函数的参数有哪些,返回值如何处理
- 不修改原来的数组
Array.prototype.myMap = function(callback, context){
  // 转换类数组
  var arr = Array.prototype.slice.call(this),//由于是ES5所以就不用...展开符了
      mappedArr = [],
      i = 0;

  for (; i < arr.length; i++ ){
    // 把当前值、索引、当前数组返回去。调用的时候传到函数参数中 [1,2,3,4].map((curr,index,arr))
    mappedArr.push(callback.call(context, arr[i], i, this));
  }
  return mappedArr;
}
💬 面试官追问
价格页对
[0, 10, 20]执行myMap计算折后价,评审发现实现直接改写了原数组;这与题目约束冲突在哪里,你会怎样组织返回值?map应生成并返回新数组,不能把转换结果写回原数组,否则其他组件读取同一引用时会看到意外变化。循环中把每次回调返回值加入mappedArr,最终返回该数组;但元素若是对象,回调仍可能修改对象内部字段,这不等于深拷贝。图表组件的转换函数需要读取配置对象中的
rate,并要求回调收到值、索引和源数组;现有实现怎样满足这两个调用约定?调用回调时应使用
callback.call(context, arr[i], i, this),让函数式回调通过this读取传入的配置,同时收到当前值、索引和原始接收者。结果必须逐项写入新数组;箭头函数不会因call改变自身的this,调用方选用箭头函数时要明确这一限制。接口把数据从普通数组换成带
length的类数组,当前代码先执行slice.call(this);这一步解决了什么,又带来什么语义差异?slice.call(this)会把可按索引读取的类数组转换成普通数组,便于后续按固定内容遍历。回调第三个参数仍传this,因此它看到的是原接收者而非副本;遍历期间若原对象发生变化,副本中的值与第三个参数可能不一致,需要明确是否接受这种快照语义。线上埋点显示
myMap的返回数组长度偶尔少于输入长度,代码用push写结果;输入包含稀疏项时你会如何定位?先构造带空槽的最小数组,对比原生
map与自定义实现的长度、索引存在性和回调次数。简单的slice加循环再push可能把空槽转成显式的undefined结果,或执行原本不该执行的回调;若要求原生兼容,应按索引赋值并用属性存在性测试验证。数据清洗链路有人提议用
map同时过滤无效项,回调对无效数据不返回值;页面最终出现多个undefined,应该换什么设计?map会为每个参与映射的元素保留一个结果位置,回调不返回内容时该位置就是undefined,它不负责缩短数组。需要删除无效项时应先filter再map,或在一次显式循环中同时判断和收集;后者减少中间数组,但可读性和复用性会下降。
# 6 实现reduce方法
⚡ 30 秒速记
myReduce会把上一次计算结果、当前值、索引和原数组交给回调,再把回调返回值作为下一轮的累计值。- 传入初始值时从索引
0开始,否则默认用数组第一项,并从索引1开始。 - 这里通过
fn.call执行回调,最终返回累计结果res。 - 按这段实现的判断方式,
0、空字符串等假值也会被当成没有传初始值,这是使用时要留意的边界。
myReduce会把上一次计算结果、当前值、索引和原数组交给回调,再把回调返回值作为下一轮的累计值。 传入初始值时从索引0开始,否则默认用数组第一项,并从索引1开始。这里通过fn.call执行回调,最终返回累计结果res。按这段实现的判断方式,0、空字符串等假值也会被当成没有传初始值,这是使用时要留意的边界。
- 初始值不传怎么处理
- 回调函数的参数有哪些,返回值如何处理。
Array.prototype.myReduce = function(fn, initialValue) {
  var arr = Array.prototype.slice.call(this);
  var res, startIndex;

  res = initialValue ? initialValue : arr[0]; // 不传默认取数组第一项
  startIndex = initialValue ? 0 : 1;

  for(var i = startIndex; i < arr.length; i++) {
    // 把初始值、当前值、索引、当前数组返回去。调用的时候传到函数参数中 [1,2,3,4].reduce((initVal,curr,index,arr))
    res = fn.call(null, res, arr[i], i, this);
  }
  return res;
}
💬 面试官追问
订单汇总以
0作为initialValue,现有代码用initialValue ? initialValue : arr[0]判断是否传入;总金额为什么会算错,你会怎样判断参数是否存在?0、false和空字符串都是合法初始值,却会被真假判断误认为未传,从而错误地采用数组首项。应依据实参数量判断,例如检查arguments.length >= 2,传入初始值时从索引0开始;未传时才取首个可用元素作为累计值。报表服务对空数组执行
myReduce(sum),当前实现返回undefined,而调用方把它继续参与计算;你会规定什么失败语义?空数组且未提供初始值时没有可建立的累计值,应直接抛出明确异常,而不是静默返回
undefined。若业务希望空集合求和为0,调用方应显式传入0;把业务单位元藏进通用实现会让乘积、拼接等其他归约产生错误语义。日志聚合需要把数万条记录归约成按状态分组的对象,回调参数顺序写错后索引被当成当前记录;你会怎样核对接口?
回调应依次接收累计值、当前值、当前索引和原数组,且每轮返回值成为下一轮累计值。应通过包含索引断言的小样本测试核对参数顺序,并检查回调是否确实
return;漏写返回值后累计值会从下一轮开始变成undefined。线上只有未传
initialValue的稀疏数组归约失败,首个索引恰好是空槽;你会怎样排查并修正起始累计值?不能机械地把
arr[0]当作初始累计值,应从前向后寻找首个实际存在的元素,并从其后继续归约。若整个数组都没有可用元素,则按无初始值的空数组处理并抛错;仅把空槽读取为undefined会改变回调次数和累计结果。团队想用
reduce替代所有map、filter和循环,以统一代码风格;在列表转换和状态聚合之间你怎么取舍?状态聚合、分组或把序列折叠为单值时,
reduce能清楚表达累计关系;单纯逐项转换仍应优先map,筛选则优先filter。强行用reduce会把初始化、追加和返回累计值揉进一个回调,增加漏返回与可读性风险,除非一次遍历确有必要。
# 7 实现every方法
⚡ 30 秒速记
myEvery会逐项执行回调,只有所有回调结果都为真时才返回true。- 每次调用都会传入当前值、索引和原数组,同时通过
apply把context作为回调执行时的上下文。 - 只要某一项返回假值,循环就会立即
break并返回false,没必要继续检查后面的元素。 - 空数组不会进入循环,因此会保留初始的
true。
myEvery会逐项执行回调,只有所有回调结果都为真时才返回true。 每次调用都会传入当前值、索引和原数组,同时通过apply把context作为回调执行时的上下文。只要某一项返回假值,循环就会立即break并返回false,没必要继续检查后面的元素。空数组不会进入循环,因此会保留初始的true。
Array.prototype.myEvery=function(callback, context = window){
    var len=this.length,
        flag=true,
        i = 0;

    for(;i < len; i++){
      if(!callback.apply(context,[this[i], i , this])){
        flag=false;
        break;
      }
    }
    return flag;
  }


  // var obj = {num: 1}
  // var aa=arr.myEvery(function(v,index,arr){
  // 	return v.num>=12;
  // },obj)
  // console.log(aa)
💬 面试官追问
表单校验数组为空时,产品认为“没有非法项”应允许提交;
myEvery初始flag=true会返回什么,这算不算实现错误?空数组不会进入循环,最终返回
true,符合“所有已检查元素都满足条件”的逻辑,也与全称判断的空集语义一致。若产品要求至少填写一项,应在调用every前单独校验长度;不能修改通用方法让空数组返回false。权限页有一万条规则,第二条已经失败,但同事仍让回调检查完全部规则并收集日志;
every的实现应怎样处理性能与诊断冲突?every在首次回调返回假值时就应短路并返回false,无需继续遍历剩余规则。若必须收集全部失败原因,就不应借用every,而要使用显式循环或筛选结果;完整诊断会执行全部校验,这是需求带来的额外代价。服务端渲染时运行
context = window的默认参数直接报错,而浏览器页面正常;你会如何改造thisArg处理?服务端环境可能不存在
window,因此不能把它作为通用默认值。应让context保持调用方传入的thisArg,再用callback.call(context, this[i], i, this)调用;回调若依赖浏览器全局对象,仍需由业务层隔离环境差异。线上校验偶尔把字符串
'false'当成通过,回调来自动态规则配置;这是every的故障还是数据契约问题,你会怎样定位?every根据回调返回值的真假性判断,非空字符串'false'属于真值,因此方法本身会把它视为通过。应记录回调的实际返回值及类型,并让规则层返回布尔值或显式比较;在通用实现里猜测字符串含义会引入更多隐式转换。库存校验既有人主张
!items.some(isInvalid),也有人主张items.every(isValid);在代码评审里你会依据什么选择?两种写法都能短路,但应选择最贴近业务谓词的表达:规则描述为“全部有效”时用
every(isValid),描述为“不存在无效项”时可用!some(isInvalid)。需要特别核对空数组,两者在对应互补谓词下都可能得到允许结果;若业务要求非空,应另加长度约束。
# 8 实现some方法
⚡ 30 秒速记
mySome会逐项执行回调,只要有一次结果为真,就立即返回true。- 回调收到当前值、索引和原数组,并通过
apply使用传入的context。 - 它和
every的短路方向相反:命中真值后直接break,如果遍历完仍未命中,就返回初始的false。 - 空数组不会执行回调,所以结果也是
false。
mySome会逐项执行回调,只要有一次结果为真,就立即返回true。 回调收到当前值、索引和原数组,并通过apply使用传入的context。它和every的短路方向相反:命中真值后直接break,如果遍历完仍未命中,就返回初始的false。空数组不会执行回调,所以结果也是false。
Array.prototype.mySome=function(callback, context = window){
 			var len = this.length,
 			    flag=false,
           i = 0;

 			for(;i < len; i++){
				if(callback.apply(context, [this[i], i , this])){
					flag=true;
					break;
				}
 			}
 			return flag;
		}

		// var flag=arr.mySome((v,index,arr)=>v.num>=10,obj)
		// console.log(flag);
💬 面试官追问
商品列表页用这版
mySome检查是否存在库存商品,稀疏数组[,,{stock:1}]被逐项执行回调,而原生some会跳过空槽,你怎么解释并修正?这版循环只比较下标与
length,读取空槽会得到undefined,因此错误地调用回调。循环内应先用i in Object(this)判断属性是否存在,再执行回调;但原型链上的同名索引也会被视为存在,不能简单换成仅检查自有属性。后台一次处理十万条订单,回调在前几项已返回真值;你会怎样保留短路能力,并处理调用期间数组长度变化?
命中真值后应立即
return true,遍历结束再返回false,避免继续扫描十万条数据。开始时快照length,后续新增元素不参与本轮;已删除的索引应在访问前重新检查,否则行为会偏离原生some,但手写版仍需明确是否追求完全兼容。Node.js服务里直接加载这段代码时报window is not defined,而调用方又可能显式传入null作为thisArg,你会怎么改参数设计?不要把
window写成默认参数,可直接接收可选的thisArg,并用callback.call(thisArg, value, index, object)调用。是否把null转成全局对象还受回调的严格模式影响,手工归一化会改变语义,因此不应擅自用globalThis替代。监控发现回调抛错后接口仍被包装成普通
false,排查mySome时你会要求异常怎样传播?回调抛出的异常应原样向上传播,不能捕获后转成
false,否则“没有元素满足条件”和“判断过程失败”无法区分。还要在调用前校验接收者不为null、undefined且回调可调用;代价是调用方必须自行决定重试或降级。代码评审中一方主张直接用
for循环,另一方要求完整复刻原生some;作为组件库维护者你会选哪种?组件库若承诺兼容
Array.prototype.some,就要覆盖短路、空槽、长度快照、三参数回调和thisArg等语义,并用原生结果做对照测试。若只是业务内受控数组,直观的for循环更易维护;但必须改名并写清约束,避免被误当作标准垫片。
# 9 实现数组扁平化flat方法
⚡ 30 秒速记
- 数组扁平化可以直接调用
arr.flat(Infinity),也可以用递归、reduce或循环迭代自己实现。 - 递归和
reduce的本质都是遇到子数组就继续展开,再通过concat合并结果。 - 迭代方式则反复判断是否还存在数组,并用扩展运算符逐层拍平。
- 实际使用原生方法最省事,需要手写或理解实现原理时,我一般选择递归或
reduce。
数组扁平化可以直接调用 arr.flat(Infinity),也可以用递归、reduce 或循环迭代自己实现。 递归和 reduce 的本质都是遇到子数组就继续展开,再通过 concat 合并结果。迭代方式则反复判断是否还存在数组,并用扩展运算符逐层拍平。实际使用原生方法最省事,需要手写或理解实现原理时,我一般选择递归或 reduce。
题目描述: 实现一个方法使多维数组变成一维数组
let ary = [1, [2, [3, [4, 5]]], 6];
let str = JSON.stringify(ary);
第0种处理:直接的调用
arr_flat = arr.flat(Infinity);
第一种处理
ary = str.replace(/(\[|\])/g, '').split(',');
第二种处理
str = str.replace(/(\[\]))/g, '');
str = '[' + str + ']';
ary = JSON.parse(str);
第三种处理:递归处理
let result = [];
let fn = function(arr) {
  for(let i = 0; i < arr.length; i++) {
    let item = arr[i];
    if (Array.isArray(arr[i])){
      fn(item);
    } else {
      result.push(item);
    }
  }
}
第四种处理:用 reduce 实现数组的 flat 方法
function flatten(ary) {
    return ary.reduce((pre, cur) => {
        return pre.concat(Array.isArray(cur) ? flatten(cur) : cur);
    }, []);
}
let ary = [1, 2, [3, 4], [5, [6, 7]]]
console.log(flatten(ary))
第五种处理:能用迭代的思路去实现
function flatten(arr) {
  if (!arr.length) return;
  while (arr.some((item) => Array.isArray(item))) {
    arr = [].concat(...arr);
  }
  return arr;
}
// console.log(flatten([1, 2, [1, [2, 3, [4, 5, [6]]]]]));
第六种处理:扩展运算符
while (ary.some(Array.isArray)) {
  ary = [].concat(...ary);
}
💬 面试官追问
搜索页把
[["a,b"],[null,"x"]]用JSON.stringify后删括号、再按逗号切分,结果文本和类型都变了;你会指出哪条根本缺陷?字符串替换并没有按数组结构遍历,逗号既可能是分隔符也可能属于字符串,切分后数字、布尔值和
null还会退化成文本。应使用递归、reduce或原生flat按元素处理;即便重新JSON.parse,特殊值与稀疏槽也可能已经失真。报表页要扁平化十万项、嵌套深度不确定的数据,递归版本偶发调用栈溢出,你会怎样落地?
深度不可控时应改用显式栈迭代,记录元素及其层级,按逆序压栈以维持原顺序,避免递归调用栈成为上限。结果数组仍可能占用大量内存;若消费端允许流式处理,可逐项产出,但接口将不再等同于一次返回数组的
flat。产品把需求从“完全拍平”改成只展开两层,现有递归和
while (some(Array.isArray))应怎样调整?递归函数应增加
depth参数,仅在元素为数组且剩余深度大于零时继续展开,否则把该元素原样加入结果。while方案难以精确表达每个元素的剩余层级,固定执行两轮也会全局展开两次;可用但语义和边界需要额外测试。线上任务卡死在一份异常数据上,日志显示数组直接或间接包含自身引用;你会怎样定位并避免无限递归?
先用引用身份沿当前递归路径检测环,而不是对所有见过的数组永久去重,因为同一子数组在不同位置出现应被展开多次。发现环时应抛出带路径的信息或按业务约定保留该引用;跳过虽能继续运行,却会静默丢数据。
基础库选型会上,有人要用
arr.flat(Infinity),有人坚持reduce + concat以兼容旧环境,你怎么定?运行环境原生支持且目标就是完全展开时,优先采用
flat(Infinity),语义清楚,也减少自维护代码。旧环境可由构建目标和垫片策略决定是否降级到递归或迭代实现;reduce + concat写法直观,但深层递归、临时数组和稀疏槽语义都需单独验证。
# 10 实现Array.isArray方法
⚡ 30 秒速记
- 实现
Array.isArray,可以调用Object.prototype.toString,判断结果是否等于[object Array]。 - 具体写法是
Object.prototype.toString.call(o) === '[object Array]',通过call让这个方法检查传入值。 - 它把类型判断统一成固定字符串比较。
- 可以把它挂到
Array.myIsArray上,但这只是自定义实现,调用时要注意名称与原生方法不同。
实现 Array.isArray,可以调用 Object.prototype.toString,判断结果是否等于 [object Array]。 具体写法是 Object.prototype.toString.call(o) === '[object Array]',通过 call 让这个方法检查传入值。简单来说,它把类型判断统一成固定字符串比较。可以把它挂到 Array.myIsArray 上,但这只是自定义实现,调用时要注意名称与原生方法不同。
Array.myIsArray = function(o) {
  // 调用顶级对象上的toString方法转成[object Array]形式
  return Object.prototype.toString.call(o) === '[object Array]';
};

console.log(Array.myIsArray([])); // true
💬 面试官追问
表单校验代码用
value instanceof Array,嵌入页通过iframe传来的数组却被判成非数组;这版myIsArray为什么更合适?不同执行上下文拥有不同的
Array构造函数,跨iframe的数组通常无法通过当前上下文的instanceof Array。调用Object.prototype.toString.call(value)按内部类型得到[object Array],能避开构造函数身份差异;生产代码仍应优先使用原生Array.isArray。接口把类数组对象
{0:"a",length:1}和arguments传给校验层,业务方要求它们也通过;你会修改myIsArray吗?不应修改
myIsArray,因为类数组对象和arguments具备索引或length,却不是数组,预期结果应为false。若业务只需要可遍历或可转换的数据,应另设契约并使用Array.from;混用两种概念会让后续数组方法和可变性假设失效。安全审计发现对象可自定义
Symbol.toStringTag,让Object.prototype.toString.call(o)显示成[object Array];这个垫片还能作为可信边界吗?不能把该垫片当作不可信输入的强类型证明,因为自定义
Symbol.toStringTag可能影响标签结果。安全边界应依赖原生Array.isArray并继续校验元素结构、数量和内容;即便确认是数组,也不代表其中的数据符合业务约束。线上有人覆盖了对象自身的
toString,旧实现调用o.toString()后误判或抛错;排查时为何要借用顶级原型方法?对象自身的
toString可能被覆盖、缺失或实现任意逻辑,直接调用无法稳定得到类型标签。使用Object.prototype.toString.call(o)可绕开同名自有方法,并安全处理null、undefined;但仍存在Symbol.toStringTag带来的伪装边界。兼容层评审中,一方要保留
Array.myIsArray,另一方要求直接调用标准API;你会如何取舍?现代运行环境应直接使用
Array.isArray,它表达准确,也比自定义静态属性更少污染全局对象。只有明确面向缺失该API的环境时才需要垫片,并应按特性检测条件安装;源码中的toString方案适合说明原理,不足以无条件替代标准实现。
# 11 实现Array.of方法
⚡ 30 秒速记
Array.of()会把传入的一组值原样组成数组,手写时可以用[].slice.call(arguments)实现。- 它主要弥补
Array()因参数个数不同而表现不一致的问题,例如Array.of(3)得到[3],长度是1。 - 相比
Array()或new Array(),它不会因为只传一个数字就产生不同含义。 - 这个简化实现适合普通函数,因为需要读取函数内部的
arguments。
Array.of() 会把传入的一组值原样组成数组,手写时可以用 [].slice.call(arguments) 实现。 它主要弥补 Array() 因参数个数不同而表现不一致的问题,例如 Array.of(3) 得到 [3],长度是 1。相比 Array() 或 new Array(),它不会因为只传一个数字就产生不同含义。这个简化实现适合普通函数,因为需要读取函数内部的 arguments。
Array.of()方法用于将一组值,转换为数组
- 这个方法的主要目的,是弥补数组构造函数
Array()的不足。因为参数个数的不同,会导致Array()的行为有差异。 Array.of()基本上可以用来替代Array()或new Array(),并且不存在由于参数不同而导致的重载。它的行为非常统一
Array.of(3, 11, 8) // [3,11,8]
Array.of(3) // [3]
Array.of(3).length // 1
实现
function ArrayOf(){
  return [].slice.call(arguments);
}
💬 面试官追问
分页组件要把单个数字
3包成数组,Array(3)却得到三个空槽;为什么Array.of(3)和源码中的ArrayOf(3)不会出现这个现象?Array的单个数字参数被解释为数组长度,所以Array(3)产生长度为三的稀疏数组;Array.of始终把每个实参当作元素,因此结果是[3]。源码借用slice转换arguments,也会得到同样的基本结果,但只覆盖普通调用场景。埋点
SDK每次接收零到数百个参数并转成数组,你会继续用[].slice.call(arguments),还是改用剩余参数?受控的现代代码可写成
function ArrayOf(...items) { return items; },意图比借用slice更直接,也无需操作类数组arguments。若项目必须适配较旧的语法环境,源码写法仍可使用;最终选择应由构建目标决定,不能仅凭写法新旧下结论。工具库后来要求模拟
Array.of.call(CustomArray, 1, 2)的构造器语义,当前slice.call(arguments)为什么不够?当前实现无论以什么
this调用都返回普通数组,没有使用CustomArray构造结果,因此只模拟了值收集行为。若契约要求完整兼容,就要按调用接收者是否可构造来创建结果、逐项赋值并设置长度;这会显著增加边界处理,不宜冒充简单垫片。线上监控显示调用
ArrayOf()、ArrayOf(undefined)和ArrayOf(1,2)的结果被缓存层错误合并,你会先核对哪些返回语义?三次调用应分别得到
[]、[undefined]和[1,2],实参数量必须保留,不能用真假值过滤。排查时应检查缓存键是否区分零参数与显式undefined,并确认序列化是否丢失数组中的undefined;后者常导致跨层结果看似相同。代码评审中有人提议统一用
Array.of(...values),另一人坚持数组字面量;在固定两个配置值的页面里你选哪个?固定且在源码中已知的两个值用
[a, b]更简洁,Array.of(a, b)的优势主要在统一处理动态实参,尤其是单个数字。若输入本来就是可迭代集合,展开还可能产生额外参数压力,此时应按来源选择转换方式,而不是强行统一API。
# 12 数组去重方法汇总
⚡ 30 秒速记
- 数组去重常用
Set,兼容传统写法时可以用双层循环或filter配合indexOf,对象数组则可用reduce。 - 双层循环通过逐个比较并用
splice删除重复项,但会修改原数组,而且时间复杂度是O(n^2)。 - 普通值数组用
Set再转回数组更直接;filter的关键是只保留元素第一次出现的位置。 - 对象数组按
name去重时,可以借助临时对象记录已出现的名称,并把reduce的初始值设为[]。
数组去重常用 Set,兼容传统写法时可以用双层循环或 filter 配合 indexOf,对象数组则可用 reduce。 双层循环通过逐个比较并用 splice 删除重复项,但会修改原数组,而且时间复杂度是 O(n^2)。普通值数组用 Set 再转回数组更直接;filter 的关键是只保留元素第一次出现的位置。对象数组按 name 去重时,可以借助临时对象记录已出现的名称,并把 reduce 的初始值设为 []。
首先:我知道多少种去重方式
1. 双层 for 循环
function distinct(arr) {
    for (let i=0, len=arr.length; i<len; i++) {
        for (let j=i+1; j<len; j++) {
            if (arr[i] == arr[j]) {
                arr.splice(j, 1);
                // splice 会改变数组长度,所以要将数组长度 len 和下标 j 减一
                len--;
                j--;
            }
        }
    }
    return arr;
}
思想: 双重
for循环是比较笨拙的方法,它实现的原理很简单:先定义一个包含原始数组第一个元素的数组,然后遍历原始数组,将原始数组中的每个元素与新数组中的每个元素进行比对,如果不重复则添加到新数组中,最后返回新数组;因为它的时间复杂度是O(n^2),如果数组长度很大,效率会很低
2. Array.filter() 加 indexOf/includes
function distinct(a, b) {
    let arr = a.concat(b);
    return arr.filter((item, index)=> {
        //return arr.indexOf(item) === index
        return arr.includes(item)
    })
}
思想: 利用
indexOf检测元素在数组中第一次出现的位置是否和元素现在的位置相等,如果不等则说明该元素是重复元素
3. ES6 中的 Set 去重
function distinct(array) {
   return Array.from(new Set(array));
}
思想: ES6 提供了新的数据结构 Set,Set 结构的一个特性就是成员值都是唯一的,没有重复的值。
4. reduce 实现对象数组去重复
var resources = [
    { name: "张三", age: "18" },
    { name: "张三", age: "19" },
    { name: "张三", age: "20" },
    { name: "李四", age: "19" },
    { name: "王五", age: "20" },
    { name: "赵六", age: "21" }
]
var temp = {};
resources = resources.reduce((prev, curv) => {
 // 如果临时对象中有这个名字,什么都不做
 if (temp[curv.name]) {

 }else {
    // 如果临时对象没有就把这个名字加进去,同时把当前的这个对象加入到prev中
    temp[curv.name] = true;
    prev.push(curv);
 }
 return prev
}, []);
console.log("结果", resources);
这种方法是利用高阶函数
reduce进行去重, 这里只需要注意initialValue得放一个空数组[],不然没法push
💬 面试官追问
标签页用
filter配合includes去重,代码却直接return arr.includes(item),结果所有元素都被保留;你会怎样当场修正?includes(item)对当前正在遍历的元素必然为真,因此不能判断它是否首次出现。应改为比较首次索引与当前索引,如arr.indexOf(item) === index,或直接使用Array.from(new Set(arr));两者对特殊值的比较语义并不完全一致,需按数据约束选择。订单页要对十万条原始值去重并保留首次出现顺序,双层循环还会原地
splice;你会采用哪种实现?优先使用
Set收集后通过Array.from转回数组,它天然保留首次插入顺序,也不会修改调用方传入的原数组。双层比较和中途splice会放大遍历成本并产生副作用;若运行环境或相等规则不满足需求,才考虑显式循环与自定义索引。用户列表原先按
name去重,现在产品要求按name + age,并且保留最后一条记录;现有reduce怎么变?应把去重键改为由
name与age共同构成,并使用Map保存键到记录,后出现的记录覆盖先前值,最后读取Map的值。字符串拼接键必须避免分隔符碰撞,更稳妥的是嵌套映射或可靠编码;保留最后值时结果顺序也要由产品明确。线上出现姓名为
"__proto__"的记录后,对象数组去重结果异常;排查源码里的temp[curv.name]时你会怎么处理?普通对象会继承原型属性,直接用
temp[key]判断既可能碰撞特殊键,也会把空字符串等真假值语义混在一起。应改用Map,或至少使用无原型对象并以显式成员检查判断;同时记录冲突键样本,避免只修某一个姓名。数据平台要求
NaN视为同一个值、0与-0也合并,评审中在indexOf和Set之间怎么选?应选择
Set,它能把多个NaN合并,也会将0与-0视为同一成员;indexOf无法找到NaN,用首次索引过滤会留下多个。若业务反而要区分对象内容相同或区分符号零,这两种方案都不够,需要定义键或比较器。风控规则要对对象数组去重,产品说“两个对象字段一样就算重复”,有人建议直接
new Set(objects);你会如何指出选型冲突?Set对对象按引用身份判断,两个字段相同但分别创建的对象仍会同时保留,因此不符合内容去重。应先明确参与比较的字段,再用reduce配合Map建立稳定键;深层对象、字段顺序和循环引用会让通用序列化键失效,必须限制数据模型。
# 13 对象数组如何去重
⚡ 30 秒速记
- 对象数组通常根据某个能够标识对象的属性去重,例如
id。 - 可以用
reduce逐项处理,并检查累积结果中是否已经存在相同的id;存在就跳过,否则保留当前对象。 - 示例会保留相同
id第一次出现的对象,所以{ id: 1, a: 4 }会被过滤。 - 需要注意,去重结果完全取决于选定的属性,它应当符合当前业务对“重复”的定义。
对象数组通常根据某个能够标识对象的属性去重,例如 id。 可以用 reduce 逐项处理,并检查累积结果中是否已经存在相同的 id;存在就跳过,否则保留当前对象。示例会保留相同 id 第一次出现的对象,所以 { id: 1, a: 4 } 会被过滤。需要注意,去重结果完全取决于选定的属性,它应当符合当前业务对“重复”的定义。
根据每个对象的某一个具体属性来进行去重
const responseList = [
  { id: 1, a: 1 },
  { id: 2, a: 2 },
  { id: 3, a: 3 },
  { id: 1, a: 4 },
];
const result = responseList.reduce((acc, cur) => {
    const ids = acc.map(item => item.id);
    return ids.includes(cur.id) ? acc : [...acc, cur];
}, []);
console.log(result); // -> [ { id: 1, a: 1}, {id: 2, a: 2}, {id: 3, a: 3} ]
💬 面试官追问
商品列表中连续出现
{id: 1, a: 1}和{id: 1, a: 4},产品要求保留最后一次更新,示例里的reduce为什么会得到错误结果?示例会保留第一个
id为1的对象,因为发现重复项后直接返回原来的累加数组。若业务要求保留最后一项,应按id覆盖已有记录,或记录索引后替换;必须先确认“首项优先”还是“末项优先”,否则去重结果看似正确却会留下旧数据。管理后台一次加载数万条对象,代码在每轮
reduce中都执行acc.map(...).includes(...),页面滚动明显卡顿,你会怎样改?应把已出现的
id放进Set,遍历时用has判断并用add登记,同时把首次出现的对象推入结果数组。原实现会反复创建ids数组并线性查找,数据增长后开销会叠加;改写仍需明确是否允许修改输入对象以及是否保持原顺序。订单数据的唯一性从单个
id改成shopId与orderNo的组合,直接拼接字符串作为key会有什么隐患?简单拼接可能产生碰撞,例如字段自身包含分隔符时,不同组合会得到相同字符串。可使用嵌套
Map,或采用不会产生歧义的稳定编码构造组合键;若字段可能缺失,还要明确undefined和空字符串是否属于同一业务身份。线上反馈去重后偶尔少商品,日志发现部分记录的
id分别是数字1和字符串'1',你会如何定位并处理?先抽样记录
key的值与typeof,确认上游是否混用了数字和字符串,再对照业务契约判断二者是否应视为同一商品。Set会区分1与'1',而对象属性键可能把它们折叠;应在入口统一类型并监控异常值,避免去重函数暗中猜测业务语义。评审中一方主张用
Set,另一方主张用Map,而需求既要去重又要保留最后一条记录,你会选哪个?需要保留最后一条对象时更适合用
Map,以id为键持续set,最后读取values();同一键再次赋值会更新值,但其迭代位置不会自动移到末尾。若结果顺序必须反映最后出现位置,还需先删除旧键再写入,代价是额外操作和更明确的顺序约定。
# 14 数组中的数据根据key去重
⚡ 30 秒速记
- 可以封装一个
dedup函数,通过getKey动态取得每项的去重键。 - 函数用
reduce构造映射,某个键第一次出现时保存对应数据,后续相同键不再覆盖,最后用Object.values转回数组。 - 调用时传入
(item) => item.id,就能按id去重并保留首次出现的对象。 - 这样比把属性名写死更通用,但调用方必须明确提供符合业务含义的键。
可以封装一个 dedup 函数,通过 getKey 动态取得每项的去重键。 函数用 reduce 构造映射,某个键第一次出现时保存对应数据,后续相同键不再覆盖,最后用 Object.values 转回数组。调用时传入 (item) => item.id,就能按 id 去重并保留首次出现的对象。这样比把属性名写死更通用,但调用方必须明确提供符合业务含义的键。
给定一个任意数组,实现一个通用函数,让数组中的数据根据 key 排重:
const dedup = (data, getKey = () => {} ) => {
  // todo
}
let data = [
  { id: 1, v: 1 },
  { id: 2, v: 2 },
  { id: 1, v: 1 },
];

// 以 id 作为排重 key,执行函数得到结果
// data = [
//   { id: 1, v: 1 },
//   { id: 2, v: 2 },
// ];
实现
const dedup = (data, getKey = () => { }) => {
    const dateMap = data.reduce((pre, cur) => {
        const key = getKey(cur)
        if (!pre[key]) {
            pre[key] = cur
        }
        return pre
    }, {})
    return Object.values(dateMap)
}
使用
let data = [
    { id: 1, v: 1 },
    { id: 2, v: 2 },
    { id: 1, v: 1 },
];
console.log(dedup(data, (item) => item.id))

// 以 id 作为排重 key,执行函数得到结果
// data = [
//   { id: 1, v: 1 },
//   { id: 2, v: 2 },
// ];
💬 面试官追问
通用
dedup用普通对象保存key,数据里出现key为'__proto__'、'toString'或数值0时,if (!pre[key])会产生什么结果?普通对象继承的属性可能让这些
key被误判为已经存在,而基于值真假判断也混淆了“未登记”和“已登记但值是假值”。更稳妥的是使用Map,或至少以Object.create(null)配合自有属性检查;输入key若不受信任,普通对象还会扩大原型相关风险。搜索结果页要对五万条记录按调用方传入的
getKey去重,并保持首次出现顺序,你会怎样实现这个公共函数?可维护一个
Set保存已经计算出的key,并在单次遍历中把首次出现的元素推入结果数组,天然保留首次出现顺序。每个元素只调用一次getKey,避免选择器有计算成本或副作用时结果不稳定;函数还应约定非法输入和选择器抛错时是否直接向上抛出。调用方把
getKey从返回字符串改成返回{tenantId, id}对象,两个内容相同的新对象为什么仍可能无法去重?Map和Set对对象key按引用身份比较,两个字段相同但分别创建的对象不是同一个key。应让选择器返回稳定的原始值,或由去重函数接受明确的多字段规则;对对象做通用序列化会遇到字段顺序、特殊值和循环引用,不能当作无条件替代。线上数据去重后顺序突然变化,而实现使用
Object.values(dateMap)返回结果,你会优先检查什么?先检查
getKey是否返回类似整数索引的字符串,因为普通对象枚举这类属性时可能按数值顺序排列,而不是严格沿用写入顺序。再用最小数据复现输入顺序、key类型和输出顺序;若顺序属于接口契约,应改用显式结果数组或Map,不要依赖对象枚举细节。接口聚合层既要支持“保留首项”,又要支持“保留末项”,还可能要求合并重复对象,你会如何设计
dedup的职责?应把冲突策略显式设计为参数,例如
keep-first、keep-last或调用方提供的合并函数,而不是在内部固定覆盖规则。key提取负责识别同一实体,冲突策略负责决定值,两者分离后更容易测试;策略过多时该函数会变成聚合器,需要限制接口范围。
# 15 类数组转化为数组的方法
⚡ 30 秒速记
- 类数组可以用扩展运算符或
Array.from转成真正的数组,也可以借用数组原型方法完成转换。 - 对
querySelectorAll得到的结果,直接写[...arrayLike]或Array.from(arrayLike)最直观。 - 还可以使用
Array.prototype.slice.call、Array.apply,或者Array.prototype.concat.apply。 - 我一般优先选前两种,因为表达的转换意图更清楚,其余方式更适合阅读或兼容已有代码。
类数组可以用扩展运算符或 Array.from 转成真正的数组,也可以借用数组原型方法完成转换。 对 querySelectorAll 得到的结果,直接写 [...arrayLike] 或 Array.from(arrayLike) 最直观。还可以使用 Array.prototype.slice.call、Array.apply,或者 Array.prototype.concat.apply。我一般优先选前两种,因为表达的转换意图更清楚,其余方式更适合阅读或兼容已有代码。
const arrayLike=document.querySelectorAll('div')

// 1.扩展运算符
[...arrayLike]
// 2.Array.from
Array.from(arrayLike)
// 3.Array.prototype.slice
Array.prototype.slice.call(arrayLike)
// 4.Array.apply
Array.apply(null, arrayLike)
// 5.Array.prototype.concat
Array.prototype.concat.apply([], arrayLike)
💬 面试官追问
旧版页面把
document.querySelectorAll('div')交给[...arrayLike]能运行,但把一个只有0、1和length的普通对象传进去却报不可迭代,原因是什么?展开运算符要求输入实现迭代协议,仅仅拥有索引属性和
length并不足够;NodeList在常见环境中可迭代,所以掩盖了差异。对此类纯类数组对象应使用Array.from或slice.call,并根据目标运行环境确认其兼容性,而不是把“类数组”一律等同于可迭代对象。组件初始化时要把一批
DOM节点转成数组后执行map,团队在Array.from(nodeList)和[...nodeList]之间选型,你会依据什么决定?两者在可迭代的
NodeList上都能生成浅拷贝数组,优先选择项目兼容目标内更清晰、已有转译策略支持的写法。若转换时还要映射,可用Array.from(nodeList, mapper)合并表达;生成数组会分配新容器,大量节点场景仍应避免无意义的重复转换。工具函数原来处理
DOM集合,后来还要接收生成器返回的iterable,slice.call(value)为什么不再是通用方案?slice.call依赖可读取的length和索引属性,而生成器通常只有迭代协议,没有类数组结构。Array.from同时覆盖常见类数组与iterable,更适合作为统一入口;但生成器可能是一次性的或无限序列,转换会消耗它,甚至无法结束,因此仍要约束输入。线上报错指向
Array.apply(null, arrayLike),只在某批超长数据出现,你会如何排查并替换?先记录
length、输入来源和调用栈,检查是否把大量元素作为函数实参展开,触发引擎对参数数量或调用栈资源的限制。此处无需借助函数调用完成复制,应改用Array.from、展开语法或按索引遍历;若输入可能极大,最好流式处理而不是一次性物化整个数组。代码评审中有人用
Array.prototype.concat.apply([], arrayLike)转换arguments,有人坚持Array.from(arguments),你更倾向哪一个?在项目目标环境支持时更倾向
Array.from(arguments),它直接表达“从类数组创建数组”,可读性和适用边界更清楚。concat.apply借助参数展开与拼接间接完成转换,还可能受超长参数列表影响;若只为兼容旧环境,则应由统一的构建或兼容层处理。
# 16 reduce用法汇总
⚡ 30 秒速记
reduce会按顺序遍历数组,把每次回调的返回值作为下一次累计值,最终归并成一个结果。- 它适合求和、取最大值,也能把数组归并为对象、扁平数组或去重结果;关键是根据目标选择累计值的数据结构。
- 传入
initialValue时,它就是累计值的起点,不传则按该方法自身规则执行。 reduceRight的用法相同但方向相反,compose则可借助这种归并把多个函数组合起来。
reduce 会按顺序遍历数组,把每次回调的返回值作为下一次累计值,最终归并成一个结果。 它适合求和、取最大值,也能把数组归并为对象、扁平数组或去重结果;关键是根据目标选择累计值的数据结构。传入 initialValue 时,它就是累计值的起点,不传则按该方法自身规则执行。reduceRight 的用法相同但方向相反,compose 则可借助这种归并把多个函数组合起来。
语法
array.reduce(function(total, currentValue, currentIndex, arr), initialValue);
/*
  total: 必需。初始值, 或者计算结束后的返回值。
  currentValue: 必需。当前元素。
  currentIndex: 可选。当前元素的索引;
  arr: 可选。当前元素所属的数组对象。
  initialValue: 可选。传递给函数的初始值,相当于total的初始值。
*/
reduceRight()该方法用法与reduce()其实是相同的,只是遍历的顺序相反,它是从数组的最后一项开始,向前遍历到第一项
1. 数组求和
const arr = [12, 34, 23];
const sum = arr.reduce((total, num) => total + num);

// 设定初始值求和
const arr = [12, 34, 23];
const sum = arr.reduce((total, num) => total + num, 10);  // 以10为初始值求和


// 对象数组求和
var result = [
  { subject: 'math', score: 88 },
  { subject: 'chinese', score: 95 },
  { subject: 'english', score: 80 }
];
const sum = result.reduce((accumulator, cur) => accumulator + cur.score, 0);
const sum = result.reduce((accumulator, cur) => accumulator + cur.score, -10);  // 总分扣除10分
2. 数组最大值
const a = [23,123,342,12];
const max = a.reduce((pre,next)=>pre>cur?pre:cur,0); // 342
3. 数组转对象
var streams = [{name: '技术', id: 1}, {name: '设计', id: 2}];
var obj = streams.reduce((accumulator, cur) => {accumulator[cur.id] = cur; return accumulator;}, {});
4. 扁平一个二维数组
var arr = [[1, 2, 8], [3, 4, 9], [5, 6, 10]];
var res = arr.reduce((x, y) => x.concat(y), []);
5. 数组去重
实现的基本原理如下:

① 初始化一个空数组
② 将需要去重处理的数组中的第1项在初始化数组中查找,如果找不到(空数组中肯定找不到),就将该项添加到初始化数组中
③ 将需要去重处理的数组中的第2项在初始化数组中查找,如果找不到,就将该项继续添加到初始化数组中
④ ……
⑤ 将需要去重处理的数组中的第n项在初始化数组中查找,如果找不到,就将该项继续添加到初始化数组中
⑥ 将这个初始化数组返回
var newArr = arr.reduce(function (prev, cur) {
    prev.indexOf(cur) === -1 && prev.push(cur);
    return prev;
},[]);
6. 对象数组去重
const dedup = (data, getKey = () => { }) => {
    const dateMap = data.reduce((pre, cur) => {
        const key = getKey(cur)
        if (!pre[key]) {
            pre[key] = cur
        }
        return pre
    }, {})
    return Object.values(dateMap)
}
7. 求字符串中字母出现的次数
const str = 'sfhjasfjgfasjuwqrqadqeiqsajsdaiwqdaklldflas-cmxzmnha';

const res = str.split('').reduce((pre,next)=>{
 pre[next] ? pre[next]++ : pre[next] = 1
 return pre
},{})
// 结果
-: 1
a: 8
c: 1
d: 4
e: 1
f: 4
g: 1
h: 2
i: 2
j: 4
k: 1
l: 3
m: 2
n: 1
q: 5
r: 1
s: 6
u: 1
w: 2
x: 1
z: 1
8. compose函数
redux compose源码实现
function compose(...funs) {
    if (funs.length === 0) {
        return arg => arg;
    }
    if (funs.length === 1) {
       return funs[0];
    }
    return funs.reduce((a, b) => (...arg) => a(b(...arg)))
}
💬 面试官追问
报表页对空数组执行
scores.reduce((a, b) => a + b)后直接崩溃,而非空数据一直正常,你会怎样解释并修复?未提供
initialValue时,reduce会把首个元素当作累加器,因此空数组没有可用初值并会抛错。求和应传入0,对象归组应传入{}或Map,让返回类型在空数据下仍稳定;初值不是补丁,它必须符合归约运算的单位元和目标类型。统计页用
reduce求最大值时写成(pre, next) => pre > cur ? pre : cur,上线后报cur is not defined,你会从哪些层面处理?回调参数命名为
next却引用了cur,这是变量名错误,应统一为(pre, cur) => pre > cur ? pre : cur。同时要重新审视初值0,因为全为负数时会得到不存在于数组中的结果;可不传初值但单独处理空数组,或使用符合数据域的初始策略。订单页用
reduce配合acc.concat(row.items)扁平几十批数据,内存抖动明显,你会怎样调整实现?每轮
concat都会创建新的数组并复制已有内容,累计数据较大时会产生许多中间数组。可在累加器上用push(...items),或在参数规模不确定时用内层循环逐项push;这会采用可控的局部可变写法,应保证累加器是函数内部新建而非外部共享。中间件链通过
reduce实现compose,新增三个函数后执行顺序与产品预期相反,你会如何确认是代码问题还是语义误解?先用带日志的简单函数标记输入输出,确认
a(b(x))意味着右侧函数先执行;示例中的reduce构造的是从右到左的组合。若需求是从左到右的数据管道,应改为相应的pipe语义或调整归约方向;函数还需约定同步、异步以及异常传播方式。评审中有人要求所有循环都改成
reduce,但当前逻辑包含校验失败即停止和多处分支,你会接受这个方案吗?不会仅为函数式外观强行使用
reduce,因为它没有自然的提前退出机制,复杂分支也容易把累加器变成隐式状态容器。需要短路时for...of、some或find往往更直接;reduce更适合把完整序列稳定归约为一个值,选择标准应是语义和维护成本。用户标签统计既能用对象累加,也能用
Map归约,标签可能是字符串、数字或对象引用时你会怎么选?key类型不只字符串时应优先使用Map,它能保留数字与字符串的区别,也允许对象引用作为key。普通对象适合受控的字符串键,但要处理继承属性和特殊键;无论选哪种结构,都要明确对象引用是按身份统计,而不是按字段内容做深度相等。
# 30 正则相关
# 1 实现千位分隔符
⚡ 30 秒速记
- 可以先把数字保留至多三位小数,再用正则从整数部分右侧开始每三位插入一个逗号。
parseToMoney通过toFixed(3)、parseFloat和split拆出整数与小数,然后用/\d(?=(\d{3})+$)/g处理整数部分。- 因为经过了
parseFloat,末尾无意义的零会被去掉,例如1234.560最终显示为1,234.56。 - 当前拼接方式会始终保留小数点,没有小数时结果也会以
.结尾,实际使用时可以根据展示要求决定是否保留。
可以先把数字保留至多三位小数,再用正则从整数部分右侧开始每三位插入一个逗号。 parseToMoney 通过 toFixed(3)、parseFloat 和 split 拆出整数与小数,然后用 /\d(?=(\d{3})+$)/g 处理整数部分。因为经过了 parseFloat,末尾无意义的零会被去掉,例如 1234.560 最终显示为 1,234.56。当前拼接方式会始终保留小数点,没有小数时结果也会以 . 结尾,实际使用时可以根据展示要求决定是否保留。
// 保留三位小数
parseToMoney(1234.56); // return '1,234.56'
parseToMoney(123456789); // return '123,456,789'
parseToMoney(1087654.321); // return '1,087,654.321'
function parseToMoney(num) {
  num = parseFloat(num.toFixed(3));
  let [integer, decimal] = String.prototype.split.call(num, '.');
  integer = integer.replace(/\d(?=(\d{3})+$)/g, '$&,');
  return integer + '.' + (decimal ? decimal : '');
}
💬 面试官追问
支付页调用示例函数格式化
123456789,结果末尾出现'123,456,789.',而设计稿不允许无意义的小数点,你会怎么改?当前返回语句无论是否存在小数部分都会拼接
'.',所以整数必然带尾点。应根据decimal是否存在决定是否拼接小数点,例如返回decimal ? integer + '.' + decimal : integer;还要补充整数、零、负数和已有三位小数的用例。账单页面要求“最多保留三位小数”,输入
1.9999经toFixed(3)后变成2.000,随后又显示成'2',这是截断还是四舍五入方案?toFixed(3)执行的是舍入而不是截断,而随后的parseFloat会删除末尾的零,因此实际语义是“舍入到最多三位”。若产品要求固定三位小数,就不能用parseFloat去零;若要求截断,也需要单独实现并明确负数处理,不能继续依赖toFixed。财务系统传入超出安全整数范围的金额,前端用该函数格式化后末位发生变化,你会怎样处理职责边界?
函数接收
Number时,精度可能在格式化之前已经丢失,千位分隔逻辑无法恢复原始数字。高精度金额应由上游以字符串、最小货币单位或可靠的十进制表示传递,再基于字符串分组;格式化层必须避免先parseFloat,同时校验符号和小数格式。线上偶发
num.toFixed is not a function,日志显示接口有时返回字符串'1234.56'或null,你会怎么排查和兜底?先核对接口契约并统计异常输入类型,因为实现默认
num是具有toFixed的有限数字。入口可选择严格拒绝非数字并返回明确错误,也可在产品允许时显式解析合法数字字符串;null、空字符串、NaN和无穷值不应被静默格式化成误导性金额。国际化负责人要求使用
Intl.NumberFormat,业务开发想保留正则手写方案以控制输出,你会如何取舍?仅处理固定英文逗号分组且规则简单时,手写方案便于展示原理,但生产国际化金额更适合
Intl.NumberFormat,它能按locale处理分组符和小数规则。使用标准API仍要显式配置最小、最大小数位;若后端要求稳定的机器格式,则不应让用户locale改变协议数据。负数
-1087654.321、小于一的0.125和科学计数法输入同时进入报表页,现有正则是否足以覆盖这些数据?常规负数和普通小数在转成十进制字符串后可被当前分组正则处理,但科学计数法字符串含有
e时不会按预期分组。应先定义允许的数值范围与输出规范,再针对符号、整数段和小数段分别处理;极大或极小的Number还伴随精度与表示形式风险。
# 2 判断是否是电话号码
⚡ 30 秒速记
- 可以使用正则
/^1[34578]\d{9}$/判断输入是否符合这段代码定义的手机号码格式。 - 它要求号码以
1开头,第二位只能是3、4、5、7或8,后面再跟九位数字,并且整段内容必须完全匹配。 - 这样能拦住位数错误、包含字母或夹杂其他字符的输入。
- 不过这条规则只覆盖正则中列出的号段,因此更适合按既定格式做基础校验,不能把未列入的号码直接等同于无效号码。
可以使用正则 /^1[34578]\d{9}$/ 判断输入是否符合这段代码定义的手机号码格式。 它要求号码以 1 开头,第二位只能是 3、4、5、7 或 8,后面再跟九位数字,并且整段内容必须完全匹配。这样能拦住位数错误、包含字母或夹杂其他字符的输入。不过这条规则只覆盖正则中列出的号段,因此更适合按既定格式做基础校验,不能把未列入的号码直接等同于无效号码。
function isPhone(tel) {
    var regx = /^1[34578]\d{9}$/;
    return regx.test(tel);
}
💬 面试官追问
注册页里用户输入
16612345678,运营商确认号码有效,但/^1[34578]\d{9}$/返回false,你怎么解释这个现象?失败原因是第二位字符集合被固定为
3、4、5、7、8,不在集合中的合法号段会被误拒绝。该正则只能验证它编写时认可的格式,不能等同于完整、长期有效的手机号规则;业务若要求确认号码归属,应以短信验证或服务端权威数据为准。登录页每天接收大量手机号输入,产品只要求拦住明显格式错误,你会怎样改造这段校验并安排前后端职责?
前端可采用较宽松的格式检查,例如确认输入为
1开头的11位数字,并在提交前去除明确允许的空白。服务端必须重复校验,真正证明号码可用仍需短信验证码;规则过严会误伤新号段,规则过松则会放入更多无效请求。同一账户系统准备支持中国大陆手机号、国际号码和座机,产品希望继续只用一个正则,你会接受这个选型吗?
不宜把不同编号体系硬塞进一个正则,应先由国家或号码类型决定解析规则,再分别校验并保存标准化结果。国际号码还涉及国家代码、分隔符和本地书写差异,单个正则很快会失控;若业务只支持大陆手机号,就应在页面上明确这一约束。
手机号登录上线后出现“部分新用户始终收不到验证码”,前端提示却是“号码格式错误”,你会按什么顺序排查?
先收集被拒号码的脱敏样本,确认失败发生在前端正则、服务端校验还是短信通道,再核对第二位是否落在旧集合之外。若前端提前拦截,请求根本不会到达服务端;修复时还要统一两端规则,并监控不同校验失败原因,避免把通道故障误报成格式错误。
安全同学主张手机号必须用严格正则,产品同学主张只校验
11位数字,你会如何裁决?若目标只是减少输入错误,应倾向稳定且宽松的格式校验,把号码所有权交给短信验证码确认。严格号段表只有在存在可靠更新来源和同步机制时才值得维护,否则新增号段会造成真实用户流失;宽松校验的代价是服务端会接收更多无效号码。
# 3 验证是否是邮箱
⚡ 30 秒速记
- 可以通过正则校验邮箱是否由合法的本地部分、
@、域名和至少一个点号后缀组成。 - 这里的
/^([a-zA-Z0-9_\-])+@([a-zA-Z0-9_\-])+(\.[a-zA-Z0-9_\-])+$/只接受字母、数字、下划线和连字符,并要求整个字符串完整匹配。 - 它适合表单中做简单的格式过滤,例如排除缺少
@或域名后缀的输入。 - 需要注意,这只是当前规则允许的邮箱范围,不能代表对所有现实邮箱格式的完整覆盖。
可以通过正则校验邮箱是否由合法的本地部分、@、域名和至少一个点号后缀组成。 这里的 /^([a-zA-Z0-9_\-])+@([a-zA-Z0-9_\-])+(\.[a-zA-Z0-9_\-])+$/ 只接受字母、数字、下划线和连字符,并要求整个字符串完整匹配。它适合表单中做简单的格式过滤,例如排除缺少 @ 或域名后缀的输入。需要注意,这只是当前规则允许的邮箱范围,不能代表对所有现实邮箱格式的完整覆盖。
function isEmail(email) {
    var regx = /^([a-zA-Z0-9_\-])+@([a-zA-Z0-9_\-])+(\.[a-zA-Z0-9_\-])+$/;
    return regx.test(email);
}
💬 面试官追问
邀请成员页面输入
dev+alert@example.com后被当前正则拒绝,但用户坚持地址可用,你如何定位限制来自哪里?当前本地部分只允许字母、数字、下划线和连字符,因此
+会直接导致匹配失败。这个表达式验证的是一小部分常见写法,并非所有合法邮箱;若业务需要接纳更广泛地址,应放宽前端检查,并通过验证邮件确认可达性。营销报名页只需要过滤明显写错的邮箱,前端、服务端和邮件发送环节分别应承担什么校验?
前端适合检查是否存在合理的本地部分、
@和域名结构,服务端再做同样的基础约束与长度限制。邮箱是否真实可用不能靠该正则证明,应由验证链接或投递结果确认;过度追求完整语法会增加维护成本,也仍无法保证邮箱存在。企业客户要求接受带多级域名的地址,同时又提出国际化域名需求,继续扩展
/^([a-zA-Z0-9_\-])+@...$/是否合适?多级域名在当前
(\.[a-zA-Z0-9_\-])+结构下可以匹配,但字符范围仍局限于ASCII,国际化地址会超出它的能力。应先明确是否支持国际化邮箱及其标准化方式,再选择成熟解析方案;盲目堆叠字符集合容易产生误判和难以审计的规则。注册转化突然下降,日志显示大量邮箱在浏览器端被拦截而服务端没有请求,你会查看哪些样本和代码路径?
先按脱敏后的失败特征统计字符类型,重点检查
+、点号、较长域名及非ASCII字符,再复现RegExp.test的返回值。还要确认输入是否带首尾空格以及前后端规则是否一致;若只记录“格式错误”而没有失败阶段,定位成本会明显上升。后端同学建议只判断字符串中有一个
@,前端同学希望实现完整邮箱语法,你会选哪种边界?应选择介于两者之间的基础结构校验,拦截空值、缺少本地部分或域名等明显错误,同时避免声称覆盖完整邮箱规范。最终可用性由验证邮件确认;只看
@会放过大量错误输入,而复杂正则会误拒合法地址并形成持续维护负担。
# 4 验证是否是身份证
⚡ 30 秒速记
- 可以用正则同时判断输入是否为
15位数字,或符合18位身份证号码的基本字符格式。 - 这段规则允许
18位全部为数字,也允许前17位是数字、最后一位为数字或X、x,并通过首尾锚点避免匹配到额外字符。 - 它适合在提交表单前快速检查长度和字符组成。
- 边界上,这里只做格式验证,没有进一步判断号码内部信息是否真实或有效,因此不能单独作为完整的身份证合法性校验。
可以用正则同时判断输入是否为 15 位数字,或符合 18 位身份证号码的基本字符格式。 这段规则允许 18 位全部为数字,也允许前 17 位是数字、最后一位为数字或 X、x,并通过首尾锚点避免匹配到额外字符。它适合在提交表单前快速检查长度和字符组成。边界上,这里只做格式验证,没有进一步判断号码内部信息是否真实或有效,因此不能单独作为完整的身份证合法性校验。
function isCardNo(number) {
    var regx = /(^\d{15}$)|(^\d{18}$)|(^\d{17}(\d|X|x)$)/;
    return regx.test(number);
}
💬 面试官追问
实名认证页输入一个长度为
18、全部由数字组成的字符串后校验通过,但业务人员说它不可能是真实身份证,为什么正则没有拦住?该正则只检查
15位或18位外形,以及末位允许数字或X/x,不会验证地区码、出生日期和校验位。因而格式匹配不代表证件真实有效;实名认证场景必须增加服务端规则或权威核验,不能把前端正则当作身份凭证。开户页面同时保留前端即时提示和服务端实名校验,这段
isCardNo最适合放在哪一层、承担什么职责?它适合在前端承担最低限度的长度与字符提示,减少明显输错,但服务端仍要重新校验完整规则和业务权限。身份证属于敏感数据,还应限制日志、埋点和错误回显中的明文暴露;前端通过不能成为后端放行依据。
产品决定不再接受
15位旧格式,并要求统一保存末位大写X,你会怎样调整输入处理与存储边界?应先把支持范围明确为
18位,再在校验前或标准化阶段将末位x转为X,存储统一格式。仅修改正则会改变历史用户的输入结果,因此还要评估存量数据和兼容路径;标准化不能修复错误的出生日期或校验位。实名认证上线后出现“前端通过、服务端拒绝”的集中投诉,样本多为末位
X,你会怎样排查两端差异?先对比前后端对长度、大小写和校验位的规则,使用脱敏测试样本逐层复现,确认是否在传输或标准化时改变了末位字符。还要检查当前表达式分支是否完整锚定以及服务端返回的具体失败码;排查日志不得记录完整身份证号。
风控希望正则一次完成地区、日期和校验位验证,研发希望拆成多个步骤,你支持哪一种?
应拆分格式、日期、地区规则和校验位计算,让每一步都能测试并返回清晰原因。正则适合约束位数和字符形态,但把动态地区数据与校验算法塞入表达式会降低可维护性;拆分方案代码更多,却更便于审计和规则更新。
# 5 用正则写一个根据name获取cookie中的值的方法
⚡ 30 秒速记
- 可以用正则匹配
document.cookie,再通过match[2]取出指定name对应的值。 - 例如构造
new RegExp('(^| )' + name + '=([^;]*)'),其中(^| )兼容首项和空格开头的后续项,([^;]*)负责截取分号前的内容。 - 匹配成功后返回
unescape(match[2]),用于解码可能出现的%xxx字符序列;匹配失败时则返回undefined。
可以用正则匹配 document.cookie,再通过 match[2] 取出指定 name 对应的值。 例如构造 new RegExp('(^| )' + name + '=([^;]*)'),其中 (^| ) 兼容首项和空格开头的后续项,([^;]*) 负责截取分号前的内容。匹配成功后返回 unescape(match[2]),用于解码可能出现的 %xxx 字符序列;匹配失败时则返回 undefined。
function getCookie(name) {
  var match = document.cookie.match(new RegExp('(^| )' + name + '=([^;]*)'));
  if (match) return unescape(match[2]);
}
- 获取页面上的
cookie可以使用document.cookie
这里获取到的是类似于这样的字符串:
'username=poetry; user-id=12345; user-roles=home, me, setting'
可以看到这么几个信息:
- 每一个cookie都是由
name=value这样的形式存储的 - 每一项的开头可能是一个空串
''(比如username的开头其实就是), 也可能是一个空字符串' '(比如user-id的开头就是) - 每一项用
";"来区分 - 如果某项中有多个值的时候,是用
","来连接的(比如user-roles的值) - 每一项的结尾可能是有
";"的(比如username的结尾),也可能是没有的(比如user-roles的结尾)
- 所以我们将这里的正则拆分一下:
'(^| )'表示的就是获取每一项的开头,因为我们知道如果^不是放在[]里的话就是表示开头匹配。所以这里(^| )的意思其实就被拆分为(^)表示的匹配username这种情况,它前面什么都没有是一个空串(你可以把(^)理解为^它后面还有一个隐藏的'');而|表示的就是或者是一个" "(为了匹配user-id开头的这种情况)+name+这没什么好说的=([^;]*)这里匹配的就是=后面的值了,比如poetry;刚刚说了^要是放在[]里的话就表示"除了^后面的内容都能匹配",也就是非的意思。所以这里([^;]*)表示的是除了";"这个字符串别的都匹配(*应该都知道什么意思吧,匹配0次或多次)- 有的大佬等号后面是这样写的
'=([^;]*)(;|$)',而最后为什么可以把'(;|$)'给省略呢?因为其实最后一个cookie项是没有';'的,所以它可以合并到=([^;]*)这一步。
- 最后获取到的
match其实是一个长度为4的数组。比如:
[
  "username=poetry;",
  "",
  "poetry",
  ";"
]
- 第0项:全量
- 第1项:开头
- 第2项:中间的值
- 第3项:结尾
所以我们是要拿第2项match[2]的值。
- 为了防止获取到的值是
%xxx这样的字符序列,需要用unescape()方法解码。
💬 面试官追问
页面同时存在
id=1; user-id=2,调用getCookie('id')时你如何证明当前(^| )边界不会误取user-id,又有哪些格式假设?表达式要求名称前是字符串开头或一个空格,所以不会从
user-id中间开始匹配id。但它假设分号后恰好有空格;若document.cookie返回id=1;user=2,后续项可能匹配失败,更稳妥的边界应围绕开头或分号处理。购物车页面要读取名称由配置中心传入的
cookie,有人直接拼进new RegExp,你会要求补什么防护?必须先转义名称中的正则元字符,否则配置值里的
.、[等字符会改变匹配含义,导致错取或匹配异常。也可按分号拆分每个name=value后精确比较名称,避免动态正则;拆分实现仍需保留值中第一个等号之后的内容。旧代码用
unescape(match[2])解码,迁移时团队想替换成decodeURIComponent,能否直接全量替换?不能在未核对写入编码方式时直接替换,因为两者语义并不等价,历史值还可能含有非法百分号序列。应先抽样确认
cookie的编码约定,再用decodeURIComponent配合异常处理迁移;未经编码的值或旧格式需要兼容路径。线上只有部分用户读不到登录态,控制台里
document.cookie看不到目标项,你会先查正则还是查cookie属性?先确认目标项是否允许当前页面读取,包括
HttpOnly、Path、Domain、过期状态和当前协议;不可见时修改正则没有意义。若目标项可见,再检查分号空格、名称转义和解码异常;客户端本就无法读取HttpOnly的cookie。安全评审要求登录凭证禁止被脚本读取,但现有页面依赖
getCookie获取令牌,前端便利性和安全性冲突时怎么选?登录凭证应优先放入带
HttpOnly的cookie,由浏览器随请求发送,前端脚本不再读取其值,从而降低被XSS窃取的风险。页面若需要展示登录状态,可由受控接口返回非敏感信息;代价是必须同步处理SameSite、Secure和CSRF防护。接口返回
Set-Cookie后,开发者马上用document.cookie查不到它,这与响应头、同源策略和当前函数有什么关系?Set-Cookie由浏览器按属性规则保存,并不意味着脚本一定可见;带 `HttpOnly的项不会出现在document.cookie`` 中,路径或域不匹配也会隐藏。当前函数只能解析当前页面可见的字符串,无法枚举或绕过浏览器的访问边界。
# 31 函数柯里化相关
# 1 实现一个JS函数柯里化
⚡ 30 秒速记
- 实现柯里化可以用闭包持续收集参数,参数数量达到原函数的形参数量后再执行原函数。
- 我一般通过
fn.length判断还差多少参数,每次调用把新参数合并到闭包数组中;数量不足就继续返回收集函数,足够时用fn.apply执行。 - 这样既支持
curry(fn)(1)(2)(3),也支持分批传入多个参数,本质上实现了参数复用和延迟执行。
实现柯里化可以用闭包持续收集参数,参数数量达到原函数的形参数量后再执行原函数。 我一般通过 fn.length 判断还差多少参数,每次调用把新参数合并到闭包数组中;数量不足就继续返回收集函数,足够时用 fn.apply 执行。这样既支持 curry(fn)(1)(2)(3),也支持分批传入多个参数,本质上实现了参数复用和延迟执行。
预先处理的思想,利用闭包的机制
- 柯里化的定义:接收一部分参数,返回一个函数接收剩余参数,接收足够参数后,执行原函数
- 函数柯里化的主要作用和特点就是
参数复用、提前返回和延迟执行
- 柯里化把多次传入的参数合并,柯里化是一个高阶函数
- 每次都返回一个新函数
- 每次入参都是一个
当柯里化函数接收到足够参数后,就会执行原函数,如何去确定何时达到足够的参数呢?
有两种思路:
- 通过函数的
length属性,获取函数的形参个数,形参的个数就是所需的参数个数 - 在调用柯里化工具函数时,手动指定所需的参数个数
将这两点结合一下,实现一个简单 curry 函数
通用版
// 写法1
function curry(fn, args) {
  var length = fn.length;
  var args = args || [];
  return function(){
    newArgs = args.concat(Array.prototype.slice.call(arguments));
    if (newArgs.length < length) {
        return curry.call(this,fn,newArgs);
    }else{
        return fn.apply(this,newArgs);
    }
  }
}
// 写法2 推荐
function curry(fn) {
    const fnArgsLength = fn.length // 传入函数的参数长度
    let args = [] // 收集传入的参数

    function calc(...newArgs) {
        // 积累参数保存到闭包中
        args = [
            ...args,
            ...newArgs
        ]
        // 积累的参数长度跟传入函数的参数长度对比
        if (args.length < fnArgsLength) {
            // 参数不够,返回函数
            return calc
        } else {
            // 参数够了,返回执行结果
            return fn.apply(this, args.slice(0, fnArgsLength)) // 传入超过fnArgsLength长度的参数没有意义
        }
    }

    // 返回一个函数
    return calc
}
// 写法3
// 分批传入参数
// redux 源码的compose也是用了类似柯里化的操作
const curry = (fn, arr = []) => {// arr就是我们要收集每次调用时传入的参数
  let len = fn.length; // 函数的长度,就是参数的个数

  return function(...args) {
    let newArgs = [...arr, ...args] // 收集每次传入的参数

    // 如果传入的参数个数等于我们指定的函数参数个数,就执行指定的真正函数
    if(newArgs.length === len) {
      return fn(...newArgs)
    } else {
      // 递归收集参数
      return curry(fn, newArgs)
    }
  }
}
// 测试
function multiFn(a, b, c) {
  return a * b * c;
}

var multi = curry(multiFn);

multi(2)(3)(4);
multi(2,3,4);
multi(2)(3,4);
multi(2,3)(4)
ES6写法
const curry = (fn, arr = []) => (...args) => (
  arg => arg.length === fn.length
    ? fn(...arg)
    : curry(fn, arg)
)([...arr, ...args])
// 测试
let curryTest=curry((a,b,c,d)=>a+b+c+d)
curryTest(1,2,3)(4) //返回10
curryTest(1,2)(4)(3) //返回10
curryTest(1,2)(3,4) //返回10
// 柯里化求值
// 指定的函数
function sum(a,b,c,d,e) {
  return a + b + c + d + e
}

// 传入指定的函数,执行一次
let newSum = curry(sum)

// 柯里化 每次入参都是一个参数
newSum(1)(2)(3)(4)(5)

// 偏函数
newSum(1)(2)(3,4,5)
// 柯里化简单应用
// 判断类型,参数多少个,就执行多少次收集
function isType(type, val) {
  return Object.prototype.toString.call(val) === `[object ${type}]`
}

let newType = curry(isType)

// 相当于把函数参数一个个传了,把第一次先缓存起来
let isString = newType('String')
let isNumber = newType('Number')

isString('hello world')
isNumber(999)
💬 面试官追问
工具库用推荐写法生成
const add = curry((a, b) => a + b),连续执行add(1)(2)后又执行add(3)(4),为什么第二次调用可能得到意外结果?推荐写法把
args放在共享闭包里并持续修改,第一次执行完成后参数没有清空,后续调用会继承旧状态。可让每次收集参数时返回绑定新参数数组的新函数,避免不同调用链共享可变数据;共享状态实现更短,但不可安全复用。事件处理代码需要先固定
type,稍后收到value再执行isType(type, value),柯里化在这里具体解决了什么?curry(isType)('String')会提前保存type,得到只等待value的isString,实现参数复用和延迟执行。它适合重复使用同一前置参数的场景;若只调用一次,额外闭包和抽象层可能比直接调用更难读。被包装函数声明为
function query(a, b = 10, c) {},团队仍用fn.length判断参数是否收集完成,会出现什么偏差?fn.length不能可靠表达所有业务必需参数,默认参数会影响它反映的形参数量,因此可能在预期之前执行原函数。此类接口应显式传入目标参数个数,或改用明确的结束信号;依赖length简洁,但只适合参数声明规则受控的函数。线上出现两条并发调用链
task(1)和task(2),随后分别补参数却互相污染,你会怎样定位柯里化实现?先检查闭包中的参数数组是否被所有返回函数共享修改,再用交错调用复现每一步收集到的参数。推荐写法中的外层
args是重点,应改为递归传递不可变的新数组;若原函数自身也有状态,还需继续区分污染来源。组件方法依赖调用时的
this,经过curry后结果变成undefined,你会怎样定义this应取自哪一次调用?必须先约定
this来自最终触发执行的调用,还是首次创建偏函数时就固定,并据此使用apply或显式绑定。不同调用层级的this可能变化,递归时随意使用curry.call(this, ...)容易造成语义漂移;通用工具无法同时满足所有约定。代码评审中有人把
curry、偏函数和bind当成同一种能力,你会用当前isType示例怎样区分?curry(isType)按参数数量持续返回函数,参数足够后才执行;newType('String')得到的isString则体现了预先固定部分参数的偏函数效果。bind还能固定this并预置参数,但不会自动按fn.length分批收集;三者可重叠使用,执行时机并不相同。
# 2 请实现一个 add 函数,满足以下功能
⚡ 30 秒速记
- 这个
add可以用闭包收集每次调用的参数,并重写返回函数的toString方法完成最终求和。 - 每次继续调用时,把新参数与已有参数合并后再次返回
add,因此add(1)(2, 3)和add(1, 2)(3)都能保存完整参数。 - 真正求值发生在调用
toString()或触发隐式转换时,此时通过reduce累加;需要注意,直接调用得到的仍然是函数。
这个 add 可以用闭包收集每次调用的参数,并重写返回函数的 toString 方法完成最终求和。 每次继续调用时,把新参数与已有参数合并后再次返回 add,因此 add(1)(2, 3) 和 add(1, 2)(3) 都能保存完整参数。真正求值发生在调用 toString() 或触发隐式转换时,此时通过 reduce 累加;需要注意,直接调用得到的仍然是函数。
add(1); 			// 1
add(1)(2);  	// 3
add(1)(2)(3);// 6
add(1)(2, 3); // 6
add(1, 2)(3); // 6
add(1, 2, 3); // 6
function add(...args) {
  // 在内部声明一个函数,利用闭包的特性保存并收集所有的参数值
  let fn = function(...newArgs) {
   return add.apply(null, args.concat(newArgs))
  }

  // 利用toString隐式转换的特性,当最后执行时隐式转换,并计算最终的值返回
  fn.toString = function() {
    return args.reduce((total,curr)=> total + curr)
  }

  return fn
}
考点:
- 使用闭包, 同时要对JavaScript 的作用域链(原型链)有深入的理解
- 重写函数的
toSting()方法
// 测试,调用toString方法触发求值

add(1).toString(); 			// 1
add(1)(2).toString();  	// 3
add(1)(2)(3).toString();// 6
add(1)(2, 3).toString(); // 6
add(1, 2)(3).toString(); // 6
add(1, 2, 3).toString(); // 6
💬 面试官追问
测试页直接断言
add(1) === 1,但当前实现返回的是函数,为什么示例注释看起来成立而断言会失败?当前实现只在结果发生字符串转换或显式调用
toString()时求和,add(1)本身仍是函数,因此严格相等必然失败。应把契约写成链式调用后通过String(result)等方式取值;若必须直接得到数字,就无法同时保留任意长度的后续调用能力。结算页面把链式结果插入模板字符串,同时又参与
result + 10,只重写toString()是否足以保证两处都按数字求和?只重写
toString()依赖具体的隐式转换路径,运算符还会通过对象的原始值转换决定按数字相加还是字符串拼接。更稳妥的是实现Symbol.toPrimitive,按hint返回累计值,并补充Number(result)、模板字符串和加法测试;代价是结果依旧是可调用对象,不是真正的数字。埋点
SDK允许add(1)(2, 3)()用空调用结束计算,当前代码上线后会出现什么现象,准备怎样约束?空调用会继续返回一个新的函数,因为
newArgs为空时累计参数没有变化,并不会自然结束链条。可以约定空调用返回求和值,或禁止空调用并要求显式执行valueOf();两种语义必须二选一,否则函数返回类型会随参数个数变化。线上出现
add(1)('2')(3)最终展示成123,你会从哪一层确认是闭包失效还是输入语义错误?闭包仍然正确保存了参数,故障来自
reduce中的+遇到字符串后转为拼接。先记录每次传入值的类型并复现归约顺序,再决定严格拒绝非数字还是用Number归一化;强制转换还要处理NaN、空字符串和精度风险。代码评审中有人主张保存全部
args,另一人主张闭包只保存累计和;在高频、长链调用场景下你选哪种?若需求只是数值求和,闭包保存累计和更直接,也不会让参数数组随链长持续增长。保存完整
args便于延迟校验或重放,但每次concat都会创建新数组;一旦需要撤销、审计或改变归约规则,累计和方案就丢失了必要信息。
# 3 实现 (5).add(3).minus(2) 功能
⚡ 30 秒速记
- 可以在
Number.prototype上实现add和minus,让(5).add(3).minus(2)最终得到6。 - 两个方法分别通过
this.valueOf()取得当前数字,再完成加法或减法并返回新的数值,所以返回结果还能继续调用原型上的方法。 - 这个写法直接修改了内置对象原型,使用时要注意影响范围;如果只是实现
add(1)(2),也可以返回一个接收第二个参数的函数。
可以在 Number.prototype 上实现 add 和 minus,让 (5).add(3).minus(2) 最终得到 6。 两个方法分别通过 this.valueOf() 取得当前数字,再完成加法或减法并返回新的数值,所以返回结果还能继续调用原型上的方法。这个写法直接修改了内置对象原型,使用时要注意影响范围;如果只是实现 add(1)(2),也可以返回一个接收第二个参数的函数。
例: 5 + 3 - 2,结果为 6
Number.prototype.add = function(n) {
  return this.valueOf() + n;
};
Number.prototype.minus = function(n) {
  return this.valueOf() - n;
};
实现add(1)(2) =3
// 题意的答案
const add = (num1) => (num2)=> num2 + num1;

// 整了一个加强版 可以无限链式调用 add(1)(2)(3)(4)(5)....
function add(x) {
  // 存储和
  let sum = x;

  // 函数调用会相加,然后每次都会返回这个函数本身
  let tmp = function (y) {
    sum = sum + y;
    return tmp;
  };

  // 对象的toString必须是一个方法 在方法中返回了这个和
  tmp.toString = () => sum
  return tmp;
}

alert(add(1)(2)(3)(4)(5))
无限链式调用实现的关键在于 对象的 toString 方法: 每个对象都有一个
toString()方法,当该对象被表示为一个文本值时,或者一个对象以预期的字符串方式引用时自动调用。
也就是我在调用很多次后,他们的结果会存在add函数中的sum变量上,当我alert的时候 add会自动调用 toString方法 打印出 sum, 也就是最终的结果
💬 面试官追问
单元测试写成
(5).add(3).minus(2)能通过,但同事写5.add(3)却语法报错,这是Number.prototype实现有问题吗?这不是原型方法失效,而是数字字面量后的点可能被解析为小数点,
(5).add(3)或5..add(3)才能明确访问属性。工程代码不应依赖这种生僻写法,可用普通函数或包装对象表达链式计算,避免格式化工具和阅读者产生歧义。共享组件库上线后给所有数字新增
add和minus,另一个团队的属性遍历或同名补丁出现异常,你如何收敛影响?直接赋值会修改全局
Number.prototype,还可能与其他库的同名成员冲突,因此不适合作为公共库默认行为。至少应使用不可枚举的属性描述符并检查已有成员,更稳妥的是返回独立计算器对象;后者需要改变调用入口,无法完全保留字面量语法。财务页面要求
(0.1).add(0.2).minus(0.3)精确得到0,沿用当前实现能承诺吗?不能承诺,因为方法最终仍执行
JavaScriptNumber的浮点运算,典型小数可能产生表示误差。应根据金额单位改用整数最小单位或明确的十进制定点方案,并在输入输出处统一尺度;简单四舍五入只能掩盖部分误差,还可能改变业务规则。监控发现
(5).add('3').minus(2)得到51,值为何没有按预期得到6,你会怎样定位和修复?add中的+遇到字符串会先形成'53',随后minus的减法又把它转成数字并得到51。应在方法入口校验参数为有限数字,并为字符串、NaN、Infinity建立失败用例;若允许数字字符串,则必须显式转换并约定空值规则。产品坚持保留
(5).add(3).minus(2)的可读性,架构组则禁止扩展内建原型,你会给出什么折中接口?可以设计
calc(5).add(3).minus(2).value(),把状态和方法限制在自有对象中,既保留链式语义又不污染全局原型。代价是多一个包装和终结调用,同时要决定对象是可变累加还是每步返回新对象;后者更易推理,但会产生更多临时对象。
# 32 字符串相关
# 1 查找字符串中出现最多的字符和个数
⚡ 30 秒速记
- 可以先将字符串排序,让相同字符连续排列,再用正则匹配连续字符并记录最长的一组。
split('').sort().join('')会把相同字符聚到一起,随后用/(\w)\1+/g找出每段重复内容。- 遍历匹配结果时比较
$0.length,同步更新字符$1和次数;例如abbcccddddd最终得到字符d,共5次。
可以先将字符串排序,让相同字符连续排列,再用正则匹配连续字符并记录最长的一组。 split('').sort().join('') 会把相同字符聚到一起,随后用 /(\w)\1+/g 找出每段重复内容。遍历匹配结果时比较 $0.length,同步更新字符 $1 和次数;例如 abbcccddddd 最终得到字符 d,共 5 次。
例: abbcccddddd -> 字符最多的是d,出现了5次
let str = "abcabcabcbbccccc";
let num = 0;
let char = '';

 // 使其按照一定的次序排列
str = str.split('').sort().join('');
// "aaabbbbbcccccccc"

// 定义正则表达式
let re = /(\w)\1+/g;
str.replace(re,($0,$1) => {
    if(num < $0.length){
        num = $0.length;
        char = $1;
    }
});
console.log(`字符最多的是${char},出现了${num}次`);
💬 面试官追问
用户名分析页输入
'abca'时当前正则能找到a,但输入'a'或所有字符都只出现一次却返回空字符,原因是什么?正则
/(\w)\1+/g要求同一字符至少连续出现两次,单个字符组成的分组不会触发回调,因此num和char保持初始值。可将量词改为覆盖单次分组,或直接遍历计数;同时要明确空字符串究竟返回空结果还是计数为零。日志统计页面要处理百万级字符文本,现有
split('').sort().join('')再正则扫描是否合适?排序方案需要构造多个中间结果,时间复杂度主要受排序支配,长文本下还会增加内存压力。若只求最高频字符,单次遍历配合
Map即可累计计数并维护最大值;代价是额外保存不同字符的计数,字符种类极多时仍需评估内存。国际化页面传入中文、空格和标点,当前
\w只统计出部分内容,需求改为统计所有可见字符时怎么调整?问题来自
\w的匹配范围,它不能代表所有中文、标点或空格,而排序本身也没有解决字符定义。使用遍历和Map可避免该限制,并在入口明确是否忽略空白、大小写和标点;若还要按用户感知字符统计,普通代码单元遍历也可能拆错组合字符。线上报表同一批数据有时显示
a、有时显示b,排查后发现两者次数相同,接口应该怎样稳定返回?现有判断只在次数严格增大时更新,平局结果取决于排序后的分组顺序,而不是原字符串首次出现顺序。应先定义平局规则,例如返回全部最高频字符或选择原文最早出现者,再在计数时保存首次位置;未定义规则前,任一单值结果都可能与产品预期冲突。
代码评审在“排序后分组”和“哈希计数”之间争执,若还要求输出按频次排序的完整字符榜单,你会怎么选?
只求最大值时优先用
Map单次计数;完整榜单仍可先计数,再对不同字符的条目排序,而不必排序整段文本。若字符种类接近文本长度,榜单排序成本仍会上升;排序分组方案代码直观,但会改写顺序并制造更多中间字符串。
# 2 字符串查找
⚡ 30 秒速记
- 从字符串
b的开头逐个位置检查,并在首字符相同时继续比较a的剩余字符,就能返回首次完整匹配的位置。 - 外层遍历负责寻找候选起点,内层遍历逐字符确认,只要有一个字符不同,这个起点就不成立。
- 找到完整匹配时立即返回当前位置,遍历结束仍未命中则返回
-1;例如34在1234567中返回2。
从字符串 b 的开头逐个位置检查,并在首字符相同时继续比较 a 的剩余字符,就能返回首次完整匹配的位置。 外层遍历负责寻找候选起点,内层遍历逐字符确认,只要有一个字符不同,这个起点就不成立。找到完整匹配时立即返回当前位置,遍历结束仍未命中则返回 -1;例如 34 在 1234567 中返回 2。
请使用最基本的遍历来实现判断字符串 a 是否被包含在字符串 b 中,并返回第一次出现的位置(找不到返回 -1)。
a='34';b='1234567'; // 返回 2
a='35';b='1234567'; // 返回 -1
a='355';b='12354355'; // 返回 5
isContain(a,b);
function isContain(a, b) {
  for (let i in b) {
    if (a[0] === b[i]) {
      let tmp = true;
      for (let j in a) {
        if (a[j] !== b[~~i + ~~j]) {
          tmp = false;
        }
      }
      if (tmp) {
        return i;
      }
    }
  }
  return -1;
}
💬 面试官追问
搜索框传入空模式串
a = ''、正文b = 'abc',当前实现会返回什么,是否符合你定义的首次位置?当前代码访问
a[0]得到undefined,遍历正文时不会匹配,最终返回-1。常见接口会把空串视为在索引0处出现,但题目没有明确该语义;实现前应固定契约并增加空模式、空正文和二者都为空的测试。编辑器在几十个字符上运行正常,换成百万字符正文和数千字符关键词后,最坏情况下这段双层遍历有什么风险?
朴素匹配在大量相同前缀的文本中会反复比较,最坏比较次数接近正文长度与关键词长度的乘积。规模可控时它符合“最基本遍历”的要求;若成为高频搜索路径,可选择
KMP等线性匹配方案,但实现复杂度和维护成本更高。接口约定返回数字索引,现有实现匹配成功时却执行
return i,调用方用严格类型校验为什么会失败?for...in枚举得到的键是字符串,所以成功结果可能是'2',而失败结果却是数字-1,返回类型不一致。应改用数值下标的普通for循环,并将外层上界限制为b.length - a.length;源码中的~~i只是临时转换,不能修正最终返回值。线上偶发搜索结果错误,你看到有人给字符串对象挂了可枚举属性,而实现使用
for...in,排查重点是什么?for...in面向可枚举属性,不是遍历字符串索引的可靠工具,额外属性或原型扩展可能进入循环并破坏下标假设。改为数值索引循环即可限定访问范围,同时记录失败样本中的输入类型;若传入的不是原始字符串,还应在入口拒绝或规范化。评审有人建议直接用
b.indexOf(a),有人坚持保留手写双循环作为生产实现,你如何裁决?面试题要求基本遍历时应展示双循环,并解释匹配成功、越界和空串语义。生产代码若无特殊匹配规则,优先使用标准
indexOf,可读性和可靠性更好;只有需要教学、自定义比较或特定算法约束时,才值得维护手写版本。
# 3 字符串最长的不重复子串
⚡ 30 秒速记
- 这道题可以维护左右边界,让当前区间始终是不含重复字符的连续子串,并记录出现过的最大长度。
- 每次右边界扩展时,先在当前片段中查找新字符;如果已经存在,就把左边界移动到重复字符之后,否则更新最大值。
- 这里求的是子串而不是子序列,所以字符必须连续,例如
pwwkew的结果是3,空字符串则直接返回0。
这道题可以维护左右边界,让当前区间始终是不含重复字符的连续子串,并记录出现过的最大长度。 每次右边界扩展时,先在当前片段中查找新字符;如果已经存在,就把左边界移动到重复字符之后,否则更新最大值。这里求的是子串而不是子序列,所以字符必须连续,例如 pwwkew 的结果是 3,空字符串则直接返回 0。
题目描述
给定一个字符串 s ,请你找出其中不含有重复字符的 最长子串 的长度。


示例 1:

输入: s = "abcabcbb"
输出: 3
解释: 因为无重复字符的最长子串是 "abc",所以其长度为 3。

示例 2:

输入: s = "bbbbb"
输出: 1
解释: 因为无重复字符的最长子串是 "b",所以其长度为 1。

示例 3:

输入: s = "pwwkew"
输出: 3
解释: 因为无重复字符的最长子串是 "wke",所以其长度为 3。
     请注意,你的答案必须是 子串 的长度,"pwke" 是一个子序列,不是子串。

示例 4:

输入: s = ""
输出: 0
答案
const lengthOfLongestSubstring = function (s) {
  if (s.length === 0) {
    return 0;
  }

  let left = 0;
  let right = 1;
  let max = 0;
  while (right <= s.length) {
    let lr = s.slice(left, right);
    const index = lr.indexOf(s[right]);

    if (index > -1) {
      left = index + left + 1;
    } else {
      lr = s.slice(left, right + 1);
      max = Math.max(max, lr.length);
    }
    right++;
  }
  return max;
};
💬 面试官追问
候选人在白板上把
'pwwkew'的答案写成'pwke'、长度4,你会用哪处连续性约束指出错误?'pwke'的字符并不在原字符串中连续出现,因此它是子序列而不是子串。滑动窗口必须始终对应[left, right]的连续区间,遇到重复字符时移动左边界,而不能跳过中间字符后继续拼接。输入框每次键入都要在一段很长的文本上重新计算,当前实现反复执行
slice和indexOf,性能瓶颈在哪里?每轮都会创建窗口子串并在线性搜索重复字符,窗口较长时会重复扫描和分配,整体可能退化为平方级工作量。可用
Map记录字符最近出现位置,让左边界直接跳到Math.max(left, lastIndex + 1);代价是需要保存不同字符的索引。需求从“返回最长长度”改成“同时返回最早出现的最长子串及起止位置”,滑动窗口状态要增加什么?
除
left和最大长度外,还要在发现更长窗口时保存最佳起点,结束后通过起点和长度截取结果。长度相等时不更新即可保留最早窗口,但必须明确索引按代码单元还是用户感知字符计算;两种索引不能直接混用。线上用例
'abba'被错误实现算成3,日志显示重复a时左边界从2退回了1,应该修哪条更新规则?左边界只能单调向右移动,重复字符的旧位置若已经在窗口之外,就不能把窗口重新扩回去。更新应使用
left = Math.max(left, lastIndex + 1),并在更新最近位置后再计算窗口长度;'abba'、'tmmzuxt'等用例能暴露回退错误。团队在
Set滑动窗口和“最近位置Map”之间选型,正文可能有大量连续重复字符,你倾向哪一种?两者都能保持窗口无重复,
Set方案遇到冲突时逐个删除左侧字符,逻辑直观;Map能利用最近位置一次跳过无效区间。若只求长度,Map通常状态更直接;若窗口内容还要被持续消费,Set可能更贴近需求,但仍要维护左边界。
# 33 实现工具函数
# 1 对象扁平化
⚡ 30 秒速记
- 对象扁平化可以递归遍历每一层属性,把访问路径用
.拼成新键,并把最终值写入结果对象。 - 当前值存在且类型为
object时继续向下处理,否则说明已经到达可保存的值。 - 比如
{a:{b:{c:1}}}会得到键a.b.c、值1;这种实现同样会继续遍历数组等对象类型,而null因为条件不成立会被直接保留。
对象扁平化可以递归遍历每一层属性,把访问路径用 . 拼成新键,并把最终值写入结果对象。 当前值存在且类型为 object 时继续向下处理,否则说明已经到达可保存的值。比如 {a:{b:{c:1}}} 会得到键 a.b.c、值 1;这种实现同样会继续遍历数组等对象类型,而 null 因为条件不成立会被直接保留。
function objectFlat(obj = {}) {
  const res = {}
  function flat(item, preKey = '') {
    Object.entries(item).forEach(([key, val]) => {
      const newKey = preKey ? `${preKey}.${key}` : key
      if (val && typeof val === 'object') {
        flat(val, newKey)
      } else {
        res[newKey] = val
      }
    })
  }
  flat(obj)
  return res
}

// 测试
const source = { a: { b: { c: 1, d: 2 }, e: 3 }, f: { g: 2 } }
console.log(objectFlat(source));
💬 面试官追问
配置页传入
{a: null, b: [1, {c: 2}]},当前递归会分别产出哪些键;如果产品要求数组保持整体,你会改哪条判断?当前结果包含
a: null、b.0: 1和b.1.c: 2,因为数组也满足对象判断并被递归。若数组必须保持整体,应使用Object.prototype.toString或Array.isArray区分,只递归普通对象;代价是必须先明确日期、集合等对象的处理规则。埋点平台要扁平化一批层级不固定的事件属性,并用点号路径上传,你会怎样处理原始键名本身含
.的情况?不能直接拼接,否则
{a: {b: 1}}与{'a.b': 1}都会生成a.b,反向还原时发生冲突。应禁止该字符、转义路径片段,或改用片段数组作为中间表示;转义方案必须同时定义反转规则,否则数据仍不可逆。表单页从服务端收到一个嵌套数千层的对象,浏览器执行
objectFlat时出现调用栈溢出,你会怎样调整实现?应把递归改为显式栈或队列,逐项保存当前值与路径,避免深度直接占用
JavaScript调用栈。时间复杂度仍取决于遍历的属性数,且路径字符串会持续分配内存;面对异常深度还应设置上限并记录被截断的数据。线上只有部分用户的扁平化任务卡死,日志显示输入由插件生成,你会先检查哪类结构,怎样避免无限递归?
先检查输入是否存在循环引用,例如子属性重新指向祖先;当前实现没有访问记录,会在该路径上持续递归。可用
WeakSet记录当前递归链并在重复对象处抛错或跳过,但共享同一对象不一定等于循环,不能用永久去重误删合法路径。搜索参数只需要读取少量固定路径,同事主张先把整个大对象扁平化再查询,你是否会接受这个选型?
若只读取少量已知路径,直接按路径访问更合适,完整扁平化会遍历无关属性并创建大量键字符串。只有下游需要统一枚举、索引或传输全部叶子节点时,扁平结构才更有价值;同时要承担键冲突、类型丢失和不可逆转换的成本。
# 2 实现一个管理本地缓存过期的函数
⚡ 30 秒速记
- 可以在写入
localStorage时同时保存数据、写入时间和有效期,读取时再判断缓存是否过期。 - 设置了
expires就把完整配置序列化保存,未设置时则按普通缓存处理,对象和数组需要先转成JSON字符串。 - 读取后如果当前时间减去
startTime大于expires,就删除对应缓存并返回false;否则返回原来的value。 - 例如有效期设为
5000,表示写入五秒后再次读取会被视为过期。
可以在写入 localStorage 时同时保存数据、写入时间和有效期,读取时再判断缓存是否过期。 设置了 expires 就把完整配置序列化保存,未设置时则按普通缓存处理,对象和数组需要先转成 JSON 字符串。读取后如果当前时间减去 startTime 大于 expires,就删除对应缓存并返回 false;否则返回原来的 value。例如有效期设为 5000,表示写入五秒后再次读取会被视为过期。
封装一个可以设置过期时间的
localStorage存储函数
class Storage{
  constructor(name){
      this.name = 'storage';
  }
  //设置缓存
  setItem(params){
      let obj = {
          name:'', // 存入数据  属性
          value:'',// 属性值
          expires:"", // 过期时间
          startTime:new Date().getTime()//记录何时将值存入缓存,毫秒级
      }
      let options = {};
      //将obj和传进来的params合并
      Object.assign(options,obj,params);
      if(options.expires){
      //如果options.expires设置了的话
      //以options.name为key,options为值放进去
          localStorage.setItem(options.name,JSON.stringify(options));
      }else{
      //如果options.expires没有设置,就判断一下value的类型
          let type = Object.prototype.toString.call(options.value);
          //如果value是对象或者数组对象的类型,就先用JSON.stringify转一下,再存进去
          if(Object.prototype.toString.call(options.value) == '[object Object]'){
              options.value = JSON.stringify(options.value);
          }
          if(Object.prototype.toString.call(options.value) == '[object Array]'){
              options.value = JSON.stringify(options.value);
          }
          localStorage.setItem(options.name,options.value);
      }
  }
  //拿到缓存
  getItem(name){
      let item = localStorage.getItem(name);
      //先将拿到的试着进行json转为对象的形式
      try{
          item = JSON.parse(item);
      }catch(error){
      //如果不行就不是json的字符串,就直接返回
          item = item;
      }
      //如果有startTime的值,说明设置了失效时间
      if(item.startTime){
          let date = new Date().getTime();
          //何时将值取出减去刚存入的时间,与item.expires比较,如果大于就是过期了,如果小于或等于就还没过期
          if(date - item.startTime > item.expires){
          //缓存过期,清除缓存,返回false
              localStorage.removeItem(name);
              return false;
          }else{
          //缓存未过期,返回值
              return item.value;
          }
      }else{
      //如果没有设置失效时间,直接返回值
          return item;
      }
  }
  //移出缓存
  removeItem(name){
      localStorage.removeItem(name);
  }
  //移出全部缓存
  clear(){
      localStorage.clear();
  }
}
用法
let storage = new Storage();
storage.setItem({
  name:"name",
  value:"ppp"
})
下面我把值取出来
let value = storage.getItem('name');
console.log('我是value',value);
设置5秒过期
let storage = new Storage();
storage.setItem({
  name:"name",
  value:"ppp",
  expires: 5000
})
// 过期后再取出来会变为 false
let value = storage.getItem('name');
console.log('我是value',value);
💬 面试官追问
用户设置页缓存了字符串
"null"、空字符串和未命中的键,当前getItem分别可能返回什么;业务层还能可靠区分它们吗?JSON.parse会把字符串"null"解析成null,空字符串保持为空字符串,未命中的键也会经JSON.parse(null)得到null。因此未命中与真实的null值无法可靠区分,应返回带状态的结果或统一使用封装结构;用false表示过期同样会与合法布尔值冲突。购物车页希望缓存商品列表十分钟,并要求刷新后仍还原为数组;你会怎样统一有过期和无过期两条存储路径?
应始终写入同一种
JSON包装结构,例如保存value、startTime和可选的expires,读取时统一解析与判定。当前代码只在无过期时预先序列化对象或数组,导致返回类型不一致;统一封装更稳定,但历史数据需要兼容或迁移。产品把
expires从相对毫秒改成服务端下发的绝对时间戳,现有date - startTime > expires为什么会失效,接口应怎样重定义?绝对时间戳不能再与已用时比较,否则单位相同但语义完全不同。可直接保存
expireAt并判断Date.now() >= expireAt,或继续保存持续时长并明确字段名为ttl;两种格式并存时必须带版本或做严格识别。线上反馈缓存明明设置了五秒却长期不失效,你看到调用参数里
expires是字符串"0"或负数,会怎样定位并收紧边界?先记录实际写入值、类型、
startTime和读取时刻,确认是否发生字符串转换或非法时长。入口应要求expires为有限的非负数字,并明确0是立即过期还是永不过期;当前基于真假值的分支会让数字0直接进入无过期路径。认证负责人想用这层
localStorage封装保存登录令牌并自动过期,前端负责人反对,你如何裁决?过期封装只能控制读取时机,不能阻止页面脚本或注入脚本直接读取
localStorage,因此不能把它当作安全边界。令牌存储应服从整体认证与服务端失效策略;即使保留本地过期,也只能用于体验优化,还要处理退出登录、跨标签页同步和服务端撤销。
# 3 实现lodash的chunk方法--数组按指定长度拆分
⚡ 30 秒速记
- 实现
chunk时,可以按size递增遍历数组,并用slice截取每一段放进结果数组。 - 每次从下标
i截取到i + size,最后一段即使长度不足也会被正常保留,因此不需要额外补位。 - 比如长度为
4的数组按3拆分,结果就是一个三元素数组和一个单元素数组。 - 需要注意
size为0时应直接返回空数组,否则循环步长为零会导致无法结束。
实现 chunk 时,可以按 size 递增遍历数组,并用 slice 截取每一段放进结果数组。 每次从下标 i 截取到 i + size,最后一段即使长度不足也会被正常保留,因此不需要额外补位。比如长度为 4 的数组按 3 拆分,结果就是一个三元素数组和一个单元素数组。需要注意 size 为 0 时应直接返回空数组,否则循环步长为零会导致无法结束。
题目
/**
 * @param input
 * @param size
 * @returns {Array}
 */
_.chunk(['a', 'b', 'c', 'd'], 2)
// => [['a', 'b'], ['c', 'd']]

_.chunk(['a', 'b', 'c', 'd'], 3)
// => [['a', 'b', 'c'], ['d']]

_.chunk(['a', 'b', 'c', 'd'], 5)
// => [['a', 'b', 'c', 'd']]

_.chunk(['a', 'b', 'c', 'd'], 0)
// => []
实现
function chunk(arr, length) {
  let newArr = [];
  for (let i = 0; i < arr.length; i += length) {
    newArr.push(arr.slice(i, i + length));
  }
  return newArr;
}
💬 面试官追问
导出页调用
chunk(rows, 0)后浏览器卡死,而题目示例要求返回[];当前循环为什么停不下来,你会怎样修正?循环步长是
length,当它为0时i永远不变,因此会无限循环。进入循环前应校验并规范化分组长度,对0或无效值直接返回[];负数、NaN、小数和字符串也要给出明确契约,不能依赖隐式转换。批量请求页面有十万条
id,每组五十条提交;你会直接使用当前slice实现,还是改成原地修改数组?若调用方还需要原数组,当前
slice方案更安全,每组都是浅拷贝且不会改变输入顺序。原地splice会破坏调用方数据,也可能让共享状态出现难查问题;数据量较大时仍需关注结果数组和切片副本的内存占用。消息消费逻辑改为边接收边分组,输入不再是完整数组而是迭代器,当前
arr.length与slice都不可用,你会怎样调整抽象?应改为遍历迭代器并维护一个临时批次,达到
size时产出,结束后再产出不足一组的剩余项。若数据流可能无限,使用生成器可以避免一次保存全部结果;代价是返回值从普通数组变为惰性序列,调用方需要同步修改。线上批处理偶发漏掉最后几条数据,监控显示总数不能被分组长度整除,你会如何验证是拆分还是消费环节的问题?
先断言所有分组长度不超过
size,拼接后的元素数量与顺序必须和输入一致,并重点检查最后一组。当前slice(i, i + length)会保留尾部不足一组的数据,若断言通过,应继续检查消费方是否错误地只处理满组或提前结束。团队争论应该手写
for加slice,还是直接引入完整的lodash只用chunk;你会依据什么取舍?功能仅是数组分组且边界契约简单时,局部实现足够清晰,也能避免为单个函数扩大依赖面。项目本就统一使用
lodash且需要与其参数语义保持一致时,复用成熟实现更稳妥;手写版本若声称兼容,就必须补齐类型规范化与对照测试。
# 4 手写深度比较isEqual
⚡ 30 秒速记
- 深度比较
isEqual的本质是递归比较两个对象中每个同名属性的值。 - 如果任一参数不是对象或为
null,直接用===判断;如果两个参数引用同一个变量,则可以立即返回true。 - 继续递归前先比较
Object.keys的数量,数量不同就不用再往下检查。 - 键数量相同时逐项调用
isEqual,任一属性不相等就返回false,全部通过才算相等。
深度比较 isEqual 的本质是递归比较两个对象中每个同名属性的值。 如果任一参数不是对象或为 null,直接用 === 判断;如果两个参数引用同一个变量,则可以立即返回 true。继续递归前先比较 Object.keys 的数量,数量不同就不用再往下检查。键数量相同时逐项调用 isEqual,任一属性不相等就返回 false,全部通过才算相等。
思路:深度比较两个对象,就是要深度比较对象的每一个元素。=> 递归
- 递归退出条件:
- 被比较的是两个值类型变量,直接用“===”判断
- 被比较的两个变量之一为
null,直接判断另一个元素是否也为null
- 提前结束递推:
- 两个变量
keys数量不同 - 传入的两个参数是同一个变量
- 两个变量
- 递推工作:深度比较每一个
key
function isEqual(obj1, obj2){
    //其中一个为值类型或null
    if(!isObject(obj1) || !isObject(obj2)){
        return obj1 === obj2;
    }

    //判断是否两个参数是同一个变量
    if(obj1 === obj2){
        return true;
    }

    //判断keys数是否相等
    const obj1Keys = Object.keys(obj1);
    const obj2Keys = Object.keys(obj2);
    if(obj1Keys.length !== obj2Keys.length){
        return false;
    }

    //深度比较每一个key
    for(let key in obj1){
        if(!isEqual(obj1[key], obj2[key])){
            return false;
        }
    }

    return true;
}
💬 面试官追问
权限页比较
{role: undefined}与{other: undefined},两边键数量相同,当前循环可能给出什么结果;根因在哪里?当前实现可能返回
true,因为它只比较obj1[key]与obj2[key],缺少对obj2是否拥有同名键的检查。应遍历Object.keys(obj1)并用Object.prototype.hasOwnProperty.call(obj2, key)验证键存在,再递归比较对应值。状态管理层每次渲染都对两个包含数组的普通
JSON状态做深度比较,你会怎样减少不必要的递归成本?先保留
obj1 === obj2的引用相等快速路径,再比较键数量并在首个差异处立即返回。若上游采用不可变更新,引用变化就能缩小需要深比的范围;盲目对整棵大状态树递归会把渲染成本绑定到数据规模。需求从比较普通
JSON数据扩展到Date、RegExp和Map,继续只用Object.keys会出现什么偏差?这些对象可能没有可枚举自有键,当前逻辑会把内容不同的实例误判为相等。应先按对象标签分派,分别比较时间值、正则表达式内容或集合条目;支持类型越多,语义越复杂,不能宣称一个普通对象递归函数等价于通用
isEqual。线上页面比较接口响应时出现
Maximum call stack size exceeded,响应对象被中间层挂了父节点引用,你会怎样确认并修复?先构造最小循环结构复现,并检查递归路径是否重新访问了同一对对象;当前代码没有循环检测,会不断深入。可用成对的访问映射记录
obj1与obj2的对应关系,但映射不一致必须判为不等,否则不同拓扑可能被误判。代码评审中有人要求把比较改成
JSON.stringify(a) === JSON.stringify(b)以缩短代码,你会接受吗?不应把字符串化当作通用深比较,因为属性顺序、不可序列化值和特殊对象都会影响结果,循环引用也会破坏流程。对受控的普通
JSON数据可在明确规范后使用,但递归比较更容易定义键存在性和提前退出;两者都必须声明支持边界。
# 5 实现一个JSON.stringify
⚡ 30 秒速记
- 实现简化版
JSON.stringify,可以先区分普通值、数组和对象,再递归拼接对应的JSON字符串。 Boolean、Number和String会转换为对应原始值,字符串等类型需要补上引号;对象属性则继续递归处理。- 数组使用方括号并只拼值,对象使用花括号并同时拼接键名,而且不可枚举属性不会进入结果。
- 还要留意
undefined、函数和symbol在对象与数组中的处理不同,循环引用也需要作为边界情况处理。
实现简化版 JSON.stringify,可以先区分普通值、数组和对象,再递归拼接对应的 JSON 字符串。 Boolean、Number 和 String 会转换为对应原始值,字符串等类型需要补上引号;对象属性则继续递归处理。数组使用方括号并只拼值,对象使用花括号并同时拼接键名,而且不可枚举属性不会进入结果。还要留意 undefined、函数和 symbol 在对象与数组中的处理不同,循环引用也需要作为边界情况处理。
JSON.stringify(value[, replacer [, space]]):
Boolean | Number| String类型会自动转换成对应的原始值。undefined、任意函数以及symbol,会被忽略(出现在非数组对象的属性值中时),或者被转换成null(出现在数组中时)。- 不可枚举的属性会被忽略如果一个对象的属性值通过某种间接的方式指回该对象本身,即循环引用,属性也会被忽略
- 如果一个对象的属性值通过某种间接的方式指回该对象本身,即循环引用,属性也会被忽略
function jsonStringify(obj) {
    let type = typeof obj;
    if (type !== "object") {
        if (/string|undefined|function/.test(type)) {
            obj = '"' + obj + '"';
        }
        return String(obj);
    } else {
        let json = []
        let arr = Array.isArray(obj)
        for (let k in obj) {
            let v = obj[k];
            let type = typeof v;
            if (/string|undefined|function/.test(type)) {
                v = '"' + v + '"';
            } else if (type === "object") {
                v = jsonStringify(v);
            }
            json.push((arr ? "" : '"' + k + '":') + String(v));
        }
        return (arr ? "[" : "{") + String(json) + (arr ? "]" : "}")
    }
}
jsonStringify({x : 5}) // "{"x":5}"
jsonStringify([1, "false", false]) // "[1,"false",false]"
jsonStringify({b: undefined}) // "{"b":"undefined"}"
💬 面试官追问
日志页执行
jsonStringify({b: undefined, c: () => 1}),当前结果把两者写成字符串;这与题目列出的对象属性规则有什么冲突?当前实现会生成类似
{"b":"undefined","c":"() => 1"},而题目规则要求对象属性值中的undefined和函数被忽略。遍历对象时应跳过这些属性,数组中则写成null;两种容器不能共用简单的字符串包裹分支。埋点
SDK要序列化包含引号、反斜杠和换行符的用户输入,当前直接执行"+ 值 +"会造成什么风险?直接拼接不会转义特殊字符,可能产生无法解析的
JSON,日志拼接时还会破坏记录边界。字符串分支必须实现引号、反斜杠和控制字符的转义;字符处理不完整时不应替代原生JSON.stringify承担生产数据编码。同事要求这个实现新增
replacer和space,同时保持现有递归结构,你会怎样拆分职责?应把值转换、属性筛选、字符串转义和缩进输出拆开,再让
replacer在递归访问每个值时参与转换。space只负责格式,不应改变属性选择;能力扩展会显著增加兼容面,若目标是完全对齐原生行为,继续手写的维护成本很高。线上错误上报在处理带父节点引用的对象时页面崩溃,你会怎样定位
jsonStringify的递归故障并限定行为?先用对象自引用和间接循环分别复现,记录当前递归链,确认重复引用发生在哪条属性路径。可用
WeakSet检测祖先引用并按约定跳过或报错;共享子对象不一定形成循环,若永久标记所有访问对象会错误丢失后续属性。数组序列化出现
[1,"undefined",3],产品要求输出可被标准JSON解析的占位结果;你会怎样处理空位、undefined、函数和symbol?这些值位于数组时都应输出
null占位,才能保持索引和长度语义,而不是转成字符串或直接删掉。实现时应按索引生成每个位置的结果,并区分数组与普通对象;若只用for...in,数组空位可能不会被遍历。基础库负责人主张上线这份手写实现以减少对原生
API的依赖,业务负责人希望继续使用JSON.stringify,你如何选择?生产序列化应优先使用原生
JSON.stringify,因为当前实现连属性过滤、字符串转义、循环结构和特殊值语义都未完整覆盖。手写版本适合展示递归与容器差异,除非运行环境确实缺少原生能力并有完整兼容测试,否则替换只会扩大数据损坏风险。
# 6 实现一个JSON.parse
⚡ 30 秒速记
- 可以通过
eval('(' + text + ')')或new Function('return ' + text)()解析JSON字符串。 - 两者本质上都会动态编译并执行传入的
JavaScript代码,所以能得到字符串描述的对象或值。 - 问题是输入一旦被恶意修改,就可能执行任意代码并带来
XSS风险,因此实际编程中并不推荐直接使用。 - 如果确实采用
eval,至少要先用正则严格校验参数;标准JSON.parse还支持用reviver在返回前转换结果。
可以通过 eval('(' + text + ')') 或 new Function('return ' + text)() 解析 JSON 字符串。 两者本质上都会动态编译并执行传入的 JavaScript 代码,所以能得到字符串描述的对象或值。问题是输入一旦被恶意修改,就可能执行任意代码并带来 XSS 风险,因此实际编程中并不推荐直接使用。如果确实采用 eval,至少要先用正则严格校验参数;标准 JSON.parse 还支持用 reviver 在返回前转换结果。
JSON.parse(text[, reviver])
用来解析JSON字符串,构造由字符串描述的JavaScript值或对象。提供可选的reviver函数用以在返回之前对所得到的对象执行变换(操作)
第一种:直接调用 eval
function jsonParse(opt) {
    return eval('(' + opt + ')');
}
jsonParse(jsonStringify({x : 5}))
// Object { x: 5}
jsonParse(jsonStringify([1, "false", false]))
// [1, "false", falsr]
jsonParse(jsonStringify({b: undefined}))
// Object { b: "undefined"}
避免在不必要的情况下使用
eval,eval()是一个危险的函数,他执行的代码拥有着执行者的权利。如果你用eval()运行的字符串代码被恶意方(不怀好意的人)操控修改,您最终可能会在您的网页/扩展程序的权限下,在用户计算机上运行恶意代码。它会执行JS代码,有XSS漏洞。
如果你只想记这个方法,就得对参数json做校验。
var rx_one = /^[\],:{}\s]*$/;
var rx_two = /\\(?:["\\\/bfnrt]|u[0-9a-fA-F]{4})/g;
var rx_three = /"[^"\\\n\r]*"|true|false|null|-?\d+(?:\.\d*)?(?:[eE][+\-]?\d+)?/g;
var rx_four = /(?:^|:|,)(?:\s*\[)+/g;
if (
    rx_one.test(
        json
            .replace(rx_two, "@")
            .replace(rx_three, "]")
            .replace(rx_four, "")
    )
) {
    var obj = eval("(" +json + ")");
}
第二种:Function
核心:Function与eval有相同的字符串参数特性
var func = new Function(arg1, arg2, ..., functionBody);
在转换JSON的实际应用中,只需要这么做
var jsonStr = '{ "age": 20, "name": "jack" }'
var json = (new Function('return ' + jsonStr))();
eval与Function都有着动态编译js代码的作用,但是在实际的编程中并不推荐使用
💬 面试官追问
安全评审给你一段
{"role":"user"},你用eval('(' + text + ')')解析;同事把输入换成JavaScript对象字面量或夹带函数调用时,为什么它仍可能成功执行?eval解析的是JavaScript表达式,并不会严格遵守JSON语法,因此可能接受JSON本应拒绝的内容,甚至执行输入中的代码。外部可控字符串会把数据解析变成代码执行入口;正则预检也很难覆盖全部语法与转义边界,生产环境应直接使用JSON.parse。后台配置页要求兼容
JSON.parse(text, reviver),现有手写版只返回eval或Function的结果,你会怎样补齐删除字段和自底向上转换的语义?解析完成后要从根包装对象开始递归遍历,并在处理完子节点后调用
reviver.call(holder, key, value);返回undefined时删除对应属性,否则写回新值。还需单独处理根键"",并防范超深嵌套造成调用栈溢出,复杂需求仍应使用原生实现。日志平台每天接收大量第三方
JSON,架构师主张沿用四段正则校验后再eval,安全负责人要求彻底禁用动态执行,你支持哪一边?应支持禁用动态执行,因为校验链即使能挡住部分非法字符,也把安全性绑定在复杂正则是否完整,维护风险远高于标准解析器。大量输入还会重复执行替换和动态编译;除受控教学演示外,应使用
JSON.parse,并在外层限制长度与捕获语法异常。线上监控发现同一份配置传给手写解析器能成功,传给
JSON.parse却抛错,输入里出现单引号、尾逗号和undefined,你会怎样定位差异?先保存原始文本并逐项缩减,确认是哪种
JavaScript扩展语法被eval或Function接受,而JSON规范不接受。再用原生JSON.parse建立对照用例,要求生产方输出双引号、无尾逗号且不含 `undefined``;不能靠放宽解析掩盖上游数据契约错误。插件系统只需要读取可信的静态配置,开发者认为
new Function('return ' + text)比eval更干净,代码评审时你会如何取舍?Function仍会动态编译并执行字符串,输入一旦可被篡改,同样可能运行任意代码,因此不因作用域差异而成为安全解析器。静态JSON应交给JSON.parse;若配置确实需要可执行表达式,就应明确它是代码并放进隔离环境,而不是伪装成数据格式。
# 7 解析 URL Params 为对象
⚡ 30 秒速记
- 解析
URL Params时,可以先取出?后的查询串,再按&和=拆成键值并写入对象。 - 值需要通过
decodeURIComponent解码,纯数字字符串可用parseFloat转成数字。 - 遇到重复的
key,用数组保留所有值,避免后面的参数覆盖前面的参数。 - 对于只有参数名、没有
value的情况,可以约定为true;这段实现默认输入中存在符合预期的查询串。
解析 URL Params 时,可以先取出 ? 后的查询串,再按 & 和 = 拆成键值并写入对象。 值需要通过 decodeURIComponent 解码,纯数字字符串可用 parseFloat 转成数字。遇到重复的 key,用数组保留所有值,避免后面的参数覆盖前面的参数。对于只有参数名、没有 value 的情况,可以约定为 true;这段实现默认输入中存在符合预期的查询串。
let url = 'http://www.domain.com/?user=anonymous&id=123&id=456&city=%E5%8C%97%E4%BA%AC&enabled';
parseParam(url)
/* 结果
{ user: 'anonymous',
  id: [ 123, 456 ], // 重复出现的 key 要组装成数组,能被转成数字的就转成数字类型
  city: '北京', // 中文需解码
  enabled: true, // 未指定值得 key 约定为 true
}
*/
function parseParam(url) {
  const paramsStr = /.+\?(.+)$/.exec(url)[1]; // 将 ? 后面的字符串取出来
  const paramsArr = paramsStr.split('&'); // 将字符串以 & 分割后存到数组中
  let paramsObj = {};
  // 将 params 存到对象中
  paramsArr.forEach(param => {
    if (/=/.test(param)) { // 处理有 value 的参数
      let [key, val] = param.split('='); // 分割 key 和 value
      val = decodeURIComponent(val); // 解码
      val = /^\d+$/.test(val) ? parseFloat(val) : val; // 判断是否转为数字

      if (paramsObj.hasOwnProperty(key)) { // 如果对象有 key,则添加一个值
        paramsObj[key] = [].concat(paramsObj[key], val);
      } else { // 如果对象没有这个 key,创建 key 并设置值
        paramsObj[key] = val;
      }
    } else { // 处理没有 value 的参数
      paramsObj[param] = true;
    }
  })

  return paramsObj;
}
💬 面试官追问
订单页收到
?coupon=A=B&enabled&empty=&id=001,现有代码用param.split('=')并把纯数字转成数值,最终哪些业务含义可能被改坏?coupon的值会在第二个等号后被截断,empty应保留空字符串,而enabled才按约定成为true;id=001自动转为数字还会丢失前导零。应只按首个=分隔,并把类型转换限定在明确字段契约内,不能仅凭正则猜测业务类型。搜索结果页既可能传完整
URL,也可能只传?q=北京,还可能没有查询串;当前/.+\?(.+)$/直接取[1],你会怎样改造调用边界?应先可靠取得查询部分,无匹配时返回空对象,而不是解引用
null导致页面崩溃;浏览器环境可用URL与URLSearchParams处理完整地址。若必须手写,还要剥离#fragment、区分空查询串,并明确相对地址需要哪一个基准URL。埋点网关每批处理数十万条查询参数,产品要求重复键保持顺序,后端又要求所有值都保留字符串,你会调整现有实现的哪些策略?
重复键仍可按出现顺序累积为数组,但应移除
^\d+$驱动的隐式数值转换,避免编号、超长整数和前导零失真。解析过程保持单次线性扫描,并按字段schema在后续层转换类型;数组分配和超长输入仍需设置上限,防止资源被异常请求拖垮。客服反馈分享链接里的中文偶发打不开,日志显示
%E5%ZZ、hello+world和末尾#tab,你会按什么顺序排查?先保留原始
URL,分别检查非法百分号编码、加号语义以及片段是否被误算进参数值;decodeURIComponent遇到坏编码会抛异常,必须明确拒绝还是保留原文。若按表单查询语义解析,还需在解码前把+视为空格,但普通URI场景不能盲目套用。权限跳转页的参数会直接合并进普通对象,安全同事担心
__proto__等特殊键;继续手写对象归并还是切到标准API,你怎么选?优先用
URLSearchParams获取有序键值,再写入Object.create(null)、Map或经过白名单筛选的业务对象,避免特殊属性影响原型行为。标准API能处理解码和重复项,但不会替你完成数组聚合与类型约定;这些仍需在显式schema层实现。
# 8 转化为驼峰命名
⚡ 30 秒速记
- 可以用
replace(/-\w/g, callback)找到连字符及其后的字符,再去掉连字符并把字母转成大写。 - 比如
get-element-by-id会依次把-e、-b、-i转成E、B、I,最终得到getElementById。 - 本质上是一次正则匹配加局部替换,代码比较直接。
- 这个写法针对由
-分隔且后面确实跟有单个单词字符的输入,其他命名格式需要另外处理。
可以用 replace(/-\w/g, callback) 找到连字符及其后的字符,再去掉连字符并把字母转成大写。 比如 get-element-by-id 会依次把 -e、-b、-i 转成 E、B、I,最终得到 getElementById。本质上是一次正则匹配加局部替换,代码比较直接。这个写法针对由 - 分隔且后面确实跟有单个单词字符的输入,其他命名格式需要另外处理。
var s1 = "get-element-by-id"

// 转化为 getElementById

var f = function(s) {
    return s.replace(/-\w/g, function(x) {
        return x.slice(1).toUpperCase();
    })
}
💬 面试官追问
组件库把
get-element-by-id转成getElementById没问题,但输入换成alreadyCamel、foo--bar、-webkit-transform和结尾的name-,当前/-\w/g会出现什么不一致?普通驼峰字符串保持不变,但连续连字符只会消费其中一个匹配,前导连字符会把首字母大写,末尾连字符则会被保留。实现前必须明确目标是变量名、
CSS属性还是通用标识符;不同语义下前缀、空段和尾部分隔符不能共用一套规则。表单生成器要把后端的短横线字段映射为前端属性,同时还要能把提交结果映射回去;只保留当前单向替换函数够吗?
不够,驼峰化可能丢失原始分隔信息,多个不同输入有机会映射成同一个键,无法保证可逆。工程上应保存原字段名或建立显式映射表,并在冲突时拒绝覆盖;转换函数适合展示或约定明确的键名,不应充当无损序列化协议。
国际化平台允许数字、下划线和非
ASCII字母出现在键名中,负责人仍想沿用/-\w/g,你会要求先补哪类契约?要先定义哪些字符属于单词、是否只处理短横线、连续分隔符如何折叠,以及数字后的大小写规则。
JavaScript正则中的\w主要覆盖ASCII字母、数字和下划线,不能自然代表所有语言字符;若键名范围扩大,应采用明确字符集或按分隔符扫描。线上样式映射突然把
-webkit-transform变成WebkitTransform,导致依赖webkitTransform的代码取不到值,你如何确认是转换规则而不是数据缺失?先记录转换前后的键并用最小用例复现,检查前导
-w被整体匹配后是否执行了大写,再对照调用方期望的厂商前缀规则。修复时为前导分隔符建立专门策略并补回归测试;直接删除所有连字符可能继续制造键冲突。代码评审中一方主张继续用一行
replace,另一方要引入完整命名转换库;当前只处理受控的kebab-case配置键,你怎么定?受控输入且规则仅为“短横线加一个字符转大写”时,小函数更透明,也更容易用边界用例锁定行为。若随后要支持多种命名法、
Unicode、首字母策略和双向转换,成熟库或统一规范更合适;引入依赖会增加体积和升级成本。
# 9 实现一个函数判断数据类型
⚡ 30 秒速记
- 可以先单独判断
null,再结合typeof和Object.prototype.toString.call返回更准确的类型。 - 普通基本类型直接使用
typeof即可,而对象分支需要从[object Array]这类结果中提取并转成小写。 - 这样能区分普通对象、数组、正则和日期,避免只用
typeof时它们都得到object。 null必须提前处理,否则也会被typeof归到object。
可以先单独判断 null,再结合 typeof 和 Object.prototype.toString.call 返回更准确的类型。 普通基本类型直接使用 typeof 即可,而对象分支需要从 [object Array] 这类结果中提取并转成小写。这样能区分普通对象、数组、正则和日期,避免只用 typeof 时它们都得到 object。null 必须提前处理,否则也会被 typeof 归到 object。
function getType(obj) {
   if (obj === null) return String(obj);
   return typeof obj === 'object'
   ? Object.prototype.toString.call(obj).replace('[object ', '').replace(']', '').toLowerCase()
   : typeof obj;
}

// 调用
getType(null); // -> null
getType(undefined); // -> undefined
getType({}); // -> object
getType([]); // -> array
getType(123); // -> number
getType(true); // -> boolean
getType('123'); // -> string
getType(/123/); // -> regexp
getType(new Date()); // -> date
💬 面试官追问
调试面板里
typeof null是object,数组和日期也都是object;这段getType为什么能区分它们,又为什么要单独判断null?对象分支借助
Object.prototype.toString.call得到类似[object Array]、[object Date]的标签,再规范成小写名称。null必须提前返回,因为它的typeof也是object,但直接按普通对象路径处理会掩盖这个历史特例和预期输出。校验
SDK要识别数组、正则、日期、函数和基础值,并在多个iframe之间运行;你会保留instanceof还是采用当前实现?跨
iframe时对象与当前窗口的构造函数原型可能不同,单靠instanceof容易误判,因此当前基于原型方法调用的方式更稳妥。函数和基础值继续走typeof,对象走标签判断;如果校验涉及对象能力,仍应检查实际接口,而不能只信类型名称。插件作者能传入自定义对象,并设置
Symbol.toStringTag伪装成Date;安全模块还能把getType(value) === 'date'当成可信依据吗?不能,
Object.prototype.toString的标签可能受Symbol.toStringTag影响,类型字符串不等于对象真实具备日期语义。安全敏感路径应结合允许来源、原型或所需操作做验证,并捕获访问属性时的异常;任何单一标签方案都有被代理或自定义对象干扰的边界。线上报表偶发把无效日期当正常日期继续格式化,日志里
getType(new Date('bad'))仍返回date,你怎么定位并修正校验?getType只识别对象类别,不验证内部值是否有效,所以无效日期仍会得到date。排查时同时记录类型和数值状态,并在日期分支检查其时间值是否为NaN;类型判断与业务有效性要分层,否则还会漏掉空字符串、越界数字等情况。表单
schema校验既要报“数组”也要判断“可迭代”,团队争论是扩展getType还是分别做能力检测,你支持哪种设计?应把稳定的类别标签与能力检测分开:
getType返回约定名称,可迭代性则检查是否存在可调用的Symbol.iterator。数组、字符串、集合都可能可迭代,把能力塞进单一类型枚举会产生重叠和优先级冲突;代价是调用方需要组合多个明确断言。
# 10 对象数组列表转成树形结构(处理菜单)
⚡ 30 秒速记
- 对象数组转树的关键,是先按
id建立索引,再根据parentId把每个节点挂到对应父节点的children中。 - 这样查找父节点时可以直接访问映射,不需要反复遍历原数组。
parentId为0的节点直接放入根节点数组,其他节点则归入父级。- 用于菜单数据时,要保证非根节点对应的父节点确实存在,否则这段实现无法正常添加子节点。
对象数组转树的关键,是先按 id 建立索引,再根据 parentId 把每个节点挂到对应父节点的 children 中。 这样查找父节点时可以直接访问映射,不需要反复遍历原数组。parentId 为 0 的节点直接放入根节点数组,其他节点则归入父级。用于菜单数据时,要保证非根节点对应的父节点确实存在,否则这段实现无法正常添加子节点。
[
    {
        id: 1,
        text: '节点1',
        parentId: 0 //这里用0表示为顶级节点
    },
    {
        id: 2,
        text: '节点1_1',
        parentId: 1 //通过这个字段来确定子父级
    }
    ...
]

转成
[
    {
        id: 1,
        text: '节点1',
        parentId: 0,
        children: [
            {
                id:2,
                text: '节点1_1',
                parentId:1
            }
        ]
    }
]
实现代码如下:
function listToTree(data) {
  let temp = {};
  let treeData = [];
  for (let i = 0; i < data.length; i++) {
    temp[data[i].id] = data[i];
  }
  for (let i in temp) {
    if (+temp[i].parentId != 0) {
      if (!temp[temp[i].parentId].children) {
        temp[temp[i].parentId].children = [];
      }
      temp[temp[i].parentId].children.push(temp[i]);
    } else {
      treeData.push(temp[i]);
    }
  }
  return treeData;
}
💬 面试官追问
菜单接口返回两个相同
id、一个不存在的parentId,还有节点把自己设为父节点;当前两轮循环分别会发生什么?重复
id会在temp中静默覆盖,缺失父节点时访问其children会抛错,自引用则会把节点放进自己的children。转换前应校验ID唯一性、父节点存在性和自引用,并明确非法节点是拒绝整批、归入孤儿集合还是提升为根节点。管理后台允许用户反复刷新并复用同一份菜单数据,当前实现直接给原对象添加
children;第二次转换为什么可能出现重复子项?索引保存的是原对象引用,首次运行已经写入
children,再次运行会继续向旧数组追加,因此结果可能重复并污染调用方缓存。应在构建索引时复制节点并初始化新的子数组,或明确函数会修改输入;复制会增加空间消耗,但能获得可预测的幂等行为。组织架构从几十个节点增长到百万级,技术负责人建议对每个父节点都重新扫描列表,当前哈希索引方案是否还值得保留?
两轮索引方案总体按节点数线性处理,比逐父节点反复扫描更适合大规模数据,额外代价是保存索引和树引用的线性空间。百万级场景还要评估一次性内存、输出体积和主线程阻塞,必要时分批构建;分批前必须解决父节点尚未到达时的暂存策略。
线上菜单只显示部分根节点,同一批数据在不同接口排序下展示顺序也变化,你会检查哪些实现细节?
先核对顶级标记是否确实为数值或字符串
0,再检查重复ID是否覆盖、父节点是否缺失,以及对象键枚举是否改变了期望顺序。若顺序属于业务契约,应按原数组遍历连接节点或显式按排序字段排序,不能依赖普通对象的键枚举结果。数据团队希望保留环形依赖用于图分析,前端团队只需要可展开菜单树;你会复用
listToTree还是拆成两套模型?应拆开:菜单树要求每个节点有明确父级且不存在环,而图模型允许多种连接甚至环,二者约束不同。菜单入口先做环和多父级校验,再生成
children;图分析保留边集合与节点索引,否则把环塞进树结构会让递归渲染或序列化失控。
# 11 树形结构转成列表(处理菜单)
⚡ 30 秒速记
- 树形结构转列表可以用深度优先遍历,递归处理
children后,再把当前节点放进结果数组。 - 这段实现得到的是子节点在前、父节点在后的列表,因为
res.push(item)写在递归之后。 - 同时它会通过
delete item.children修改原始节点,最终列表里不再保留树形字段。 - 如果后续还要继续使用原树,就要留意这种原地修改带来的影响。
树形结构转列表可以用深度优先遍历,递归处理 children 后,再把当前节点放进结果数组。 这段实现得到的是子节点在前、父节点在后的列表,因为 res.push(item) 写在递归之后。同时它会通过 delete item.children 修改原始节点,最终列表里不再保留树形字段。如果后续还要继续使用原树,就要留意这种原地修改带来的影响。
[
    {
        id: 1,
        text: '节点1',
        parentId: 0,
        children: [
            {
                id:2,
                text: '节点1_1',
                parentId:1
            }
        ]
    }
]
转成
[
    {
        id: 1,
        text: '节点1',
        parentId: 0 //这里用0表示为顶级节点
    },
    {
        id: 2,
        text: '节点1_1',
        parentId: 1 //通过这个字段来确定子父级
    }
    ...
]
实现代码如下:
function treeToList(data) {
  let res = [];
  const dfs = (tree) => {
    tree.forEach((item) => {
      if (item.children) {
        dfs(item.children);
        delete item.children;
      }
      res.push(item);
    });
  };
  dfs(data);
  return res;
}
💬 面试官追问
菜单页要求父菜单排在子菜单前,但这段
treeToList处理后为什么会出现子节点在前、父节点在后的现象?现有代码在递归处理
children后才执行res.push(item),实际得到的是后序遍历结果,因此子节点先于父节点。若消费端依赖父节点先建立索引,应把入栈操作移到递归之前,并在输出对象中移除children;调整遍历顺序可能影响已有调用方。权限管理页复用传入的菜单树,调用
treeToList后原页面的展开节点突然消失,你会检查哪行代码并怎样修复?应优先检查
delete item.children,它直接修改了输入树中的原对象,其他持有同一引用的组件也会失去子节点。可通过解构生成不含children的新对象再写入结果,同时递归原始子数组;代价是增加对象分配和内存占用。后台一次下发十万级菜单节点,并可能形成上万层单链结构,递归版本上线前你会要求改什么?
节点总量为十万级时遍历本身仍是线性的,但极深单链会让递归调用栈先于数据处理耗尽。应改用显式栈迭代,并根据目标顺序控制子节点压栈方向;一次性保存完整结果仍占用线性空间,无法解决内存上限过低的场景。
线上菜单转换偶发卡死,日志显示某个节点的
children又引用了祖先节点,你会怎样定位和止损?这是输入形成环导致的无限递归,不能再把数据当作严格树处理。遍历时用
Set记录对象引用或业务id,再次访问时中止并上报路径,同时校验重复id;若合法数据允许同一节点被多处引用,按id去重会改变其多父语义。接口同学认为列表已有
parentId,前端只要递归拍平即可;你会怎样确认parentId与嵌套层级冲突时采用哪一个?必须先约定权威来源,否则输出会同时保留嵌套关系推导出的顺序和可能错误的
parentId。若以树结构为准,可在遍历时用父节点id重写子项的parentId;若以字段为准,则应先校验并重建树,任何自动修正都需记录冲突以免掩盖后端数据错误。
# 34 手写常见排序
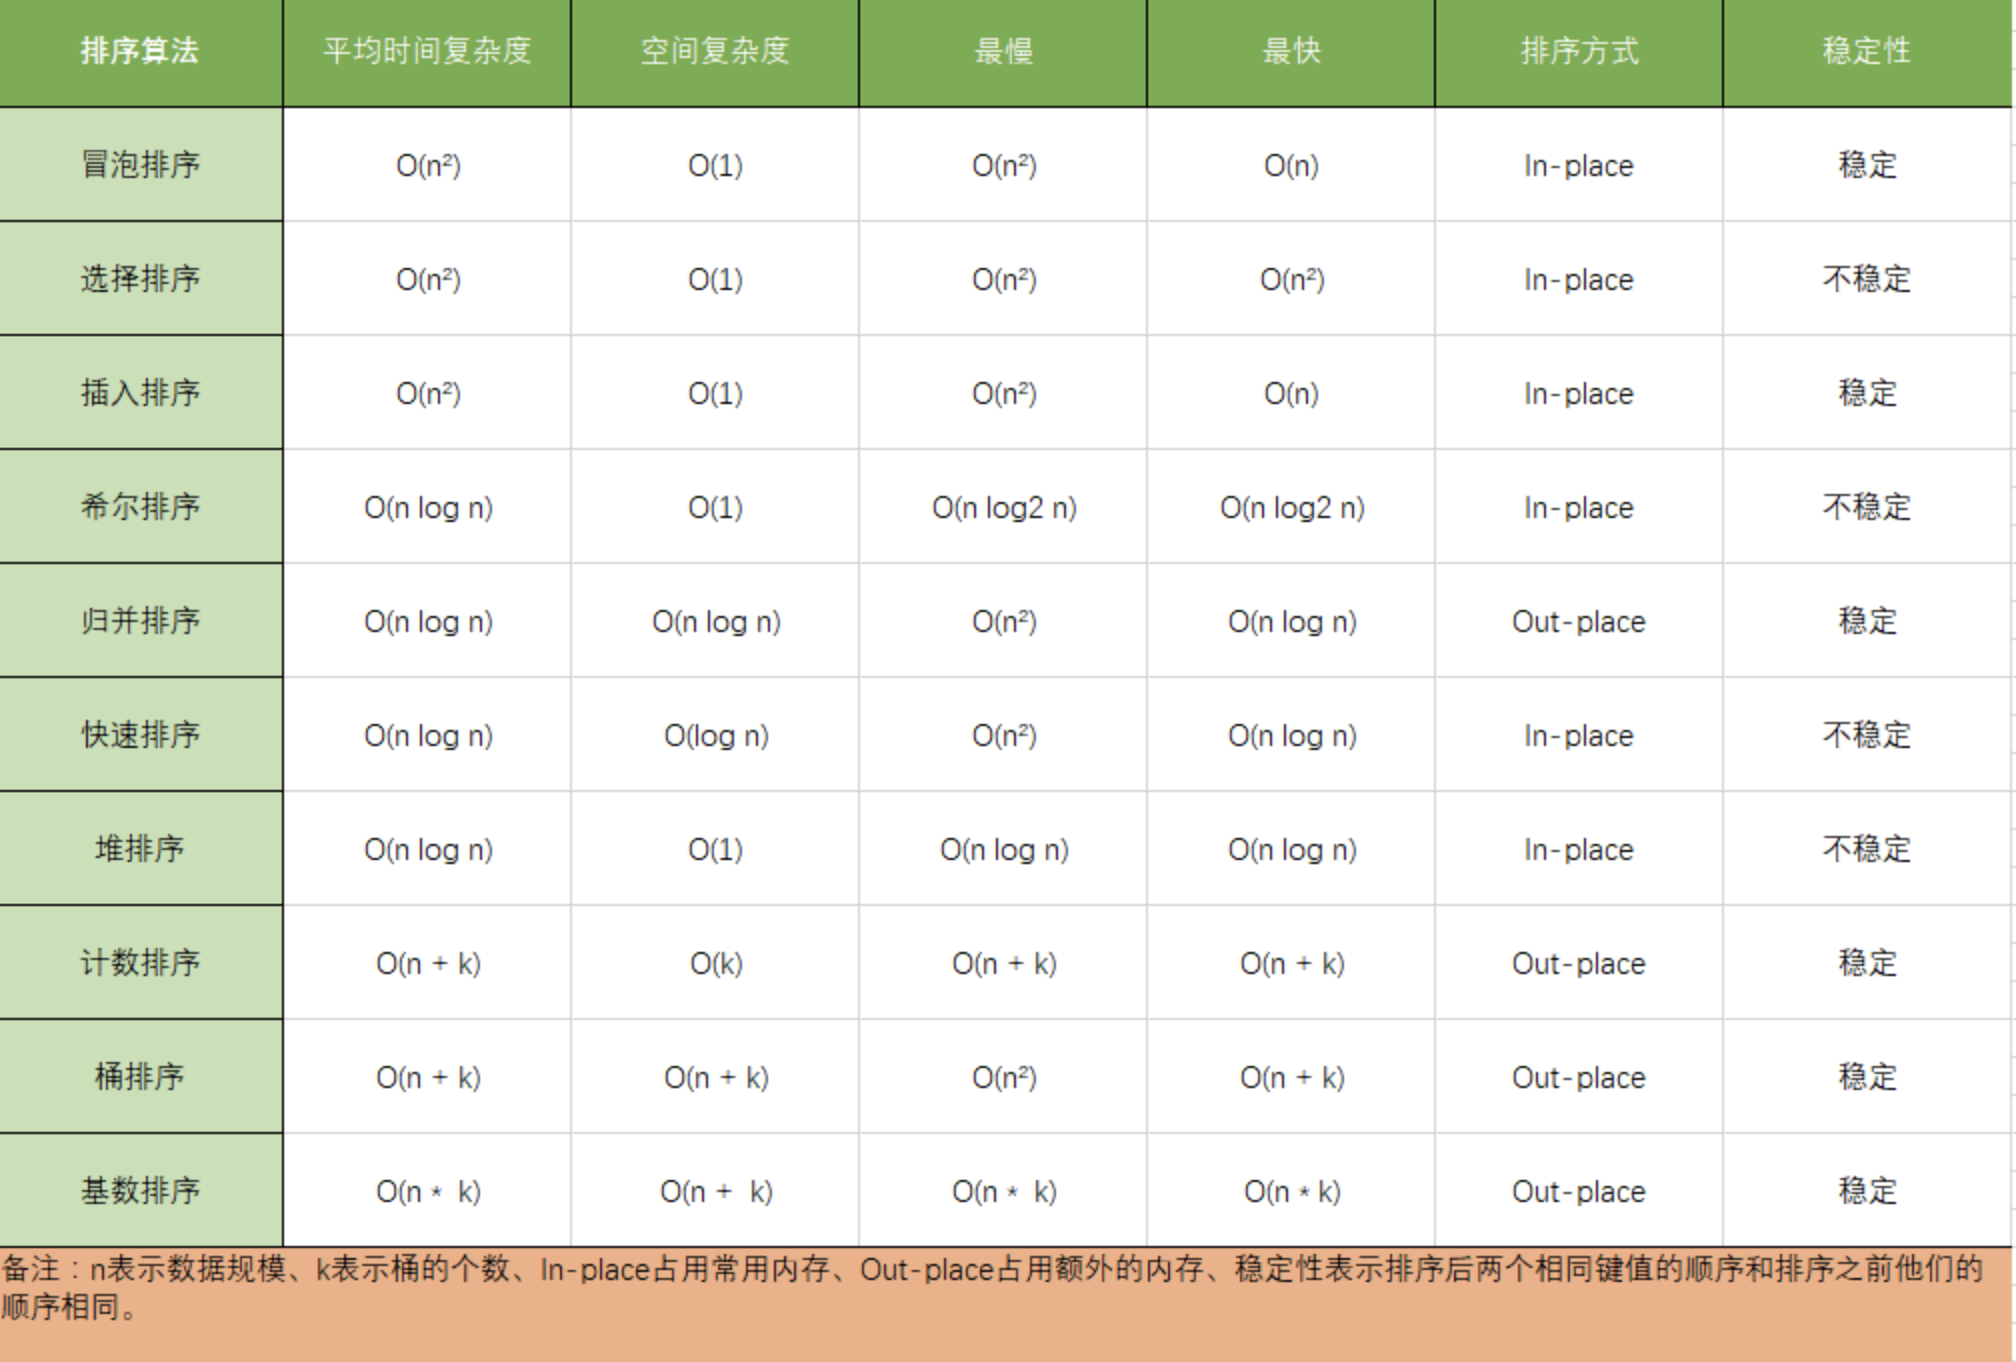
# 1 冒泡排序
⚡ 30 秒速记
- 冒泡排序就是从头比较相邻元素,前一个更大时交换位置,让当前最大值逐轮移动到数组末尾。
- 每完成一轮,末尾都会多一个已经确定位置的元素,所以下一轮的比较范围可以减少一位。
- 代码中的内层循环必须写到
n - i - 1,这样既跳过已排好序的尾部,也不会访问越界。 - 空数组则直接返回
[]。
冒泡排序就是从头比较相邻元素,前一个更大时交换位置,让当前最大值逐轮移动到数组末尾。 每完成一轮,末尾都会多一个已经确定位置的元素,所以下一轮的比较范围可以减少一位。代码中的内层循环必须写到 n - i - 1,这样既跳过已排好序的尾部,也不会访问越界。空数组则直接返回 []。
冒泡排序的原理如下,从第一个元素开始,把当前元素和下一个索引元素进行比较。如果当前元素大,那么就交换位置,重复操作直到比较到最后一个元素,那么此时最后一个元素就是该数组中最大的数。下一轮重复以上操作,但是此时最后一个元素已经是最大数了,所以不需要再比较最后一个元素,只需要比较到
length - 1的位置。
function bubbleSort(list) {
  var n = list.length;
  if (!n) return [];

  for (var i = 0; i < n; i++) {
    // 注意这里需要 n - i - 1
    for (var j = 0; j < n - i - 1; j++) {
      if (list[j] > list[j + 1]) {
        var temp = list[j + 1];
        list[j + 1] = list[j];
        list[j] = temp;
      }
    }
  }
  return list;
}
💬 面试官追问
订单页的数组已经升序,但这段
bubbleSort仍执行完整双重循环;代码评审时你会指出什么,并如何验证优化没有改错结果?当前实现没有记录某一轮是否发生交换,因此即使数组已有序,仍会完成约二次规模的比较。可在每轮设置交换标记,整轮无交换时直接退出,并用空数组、单元素、升序、逆序和重复值验证;最坏情况复杂度依旧是
O(n²)。表格组件把原始数据交给
bubbleSort后,其他组件观察到顺序也变了,这属于什么代码现象,接口应怎样设计?交换操作直接写回
list,所以函数会原地修改调用方数组,共享引用的组件会同步看到变化。若接口承诺无副作用,应先复制数组再排序,或明确命名和文档说明原地行为;复制会额外占用O(n)空间,不能假装仍是常量额外空间。运营要求在浏览器主线程对百万条记录执行这段冒泡排序,同时保证页面可交互,你会接受这个方案吗?
不会接受直接在主线程运行,因为双重循环的最坏时间复杂度为
O(n²),百万级输入会形成不可接受的长任务。应优先减少前端排序数据量、交给后端处理,或改用复杂度更合适的排序;移到Worker只能避免阻塞界面,不能消除算法成本。线上排序结果偶尔出现
NaN、undefined留在意外位置,但函数没有报错,你会怎样排查比较逻辑?判断条件只有
list[j] > list[j + 1],遇到NaN或undefined时比较可能始终为假,于是异常值被静默保留。入口应校验元素类型,或由调用方提供明确比较器和空值顺序,并记录首个非法索引;随意强制转数值可能把脏数据伪装成合法值。同事想用冒泡排序保留相同分数用户的原始先后顺序,而另一位同事建议直接改成选择排序,你会怎么判断?
当前冒泡排序只在左值严格大于右值时交换,相等元素不会互换,因此可保持相同键的相对次序。选择排序把区间最小值与头部远距离交换,通常不能保证这种稳定性;若稳定顺序是业务约束,替换算法前必须用带原始序号的数据验证。
# 2 快速排序
⚡ 30 秒速记
- 这段快速排序会选取中间元素作为
midValue,把其余元素分到left和right,再递归排序并用concat合并。 - 小于基准值的元素进入左侧,其余元素进入右侧,一层遍历配合递归二分,文中给出的时间复杂度是
O(nlogn)。 - 使用
splice会改变原数组,因此循环要读取变化后的arr.length;使用slice不修改原数组,但遍历时必须跳过midIndex。 - 一般更推荐
slice,因为不会影响调用方传入的数据。
这段快速排序会选取中间元素作为 midValue,把其余元素分到 left 和 right,再递归排序并用 concat 合并。 小于基准值的元素进入左侧,其余元素进入右侧,一层遍历配合递归二分,文中给出的时间复杂度是 O(nlogn)。使用 splice 会改变原数组,因此循环要读取变化后的 arr.length;使用 slice 不修改原数组,但遍历时必须跳过 midIndex。一般更推荐 slice,因为不会影响调用方传入的数据。
思路分析
- 找到中间位置
midValue - 遍历数组,小于
midValue放在left,否则放在right - 继续递归,最后
concat拼接返回 - 使用
splice会修改原数组,使用slice不会修改原数组(推荐) - 一层遍历+二分的时间复杂度是
O(nlogn)
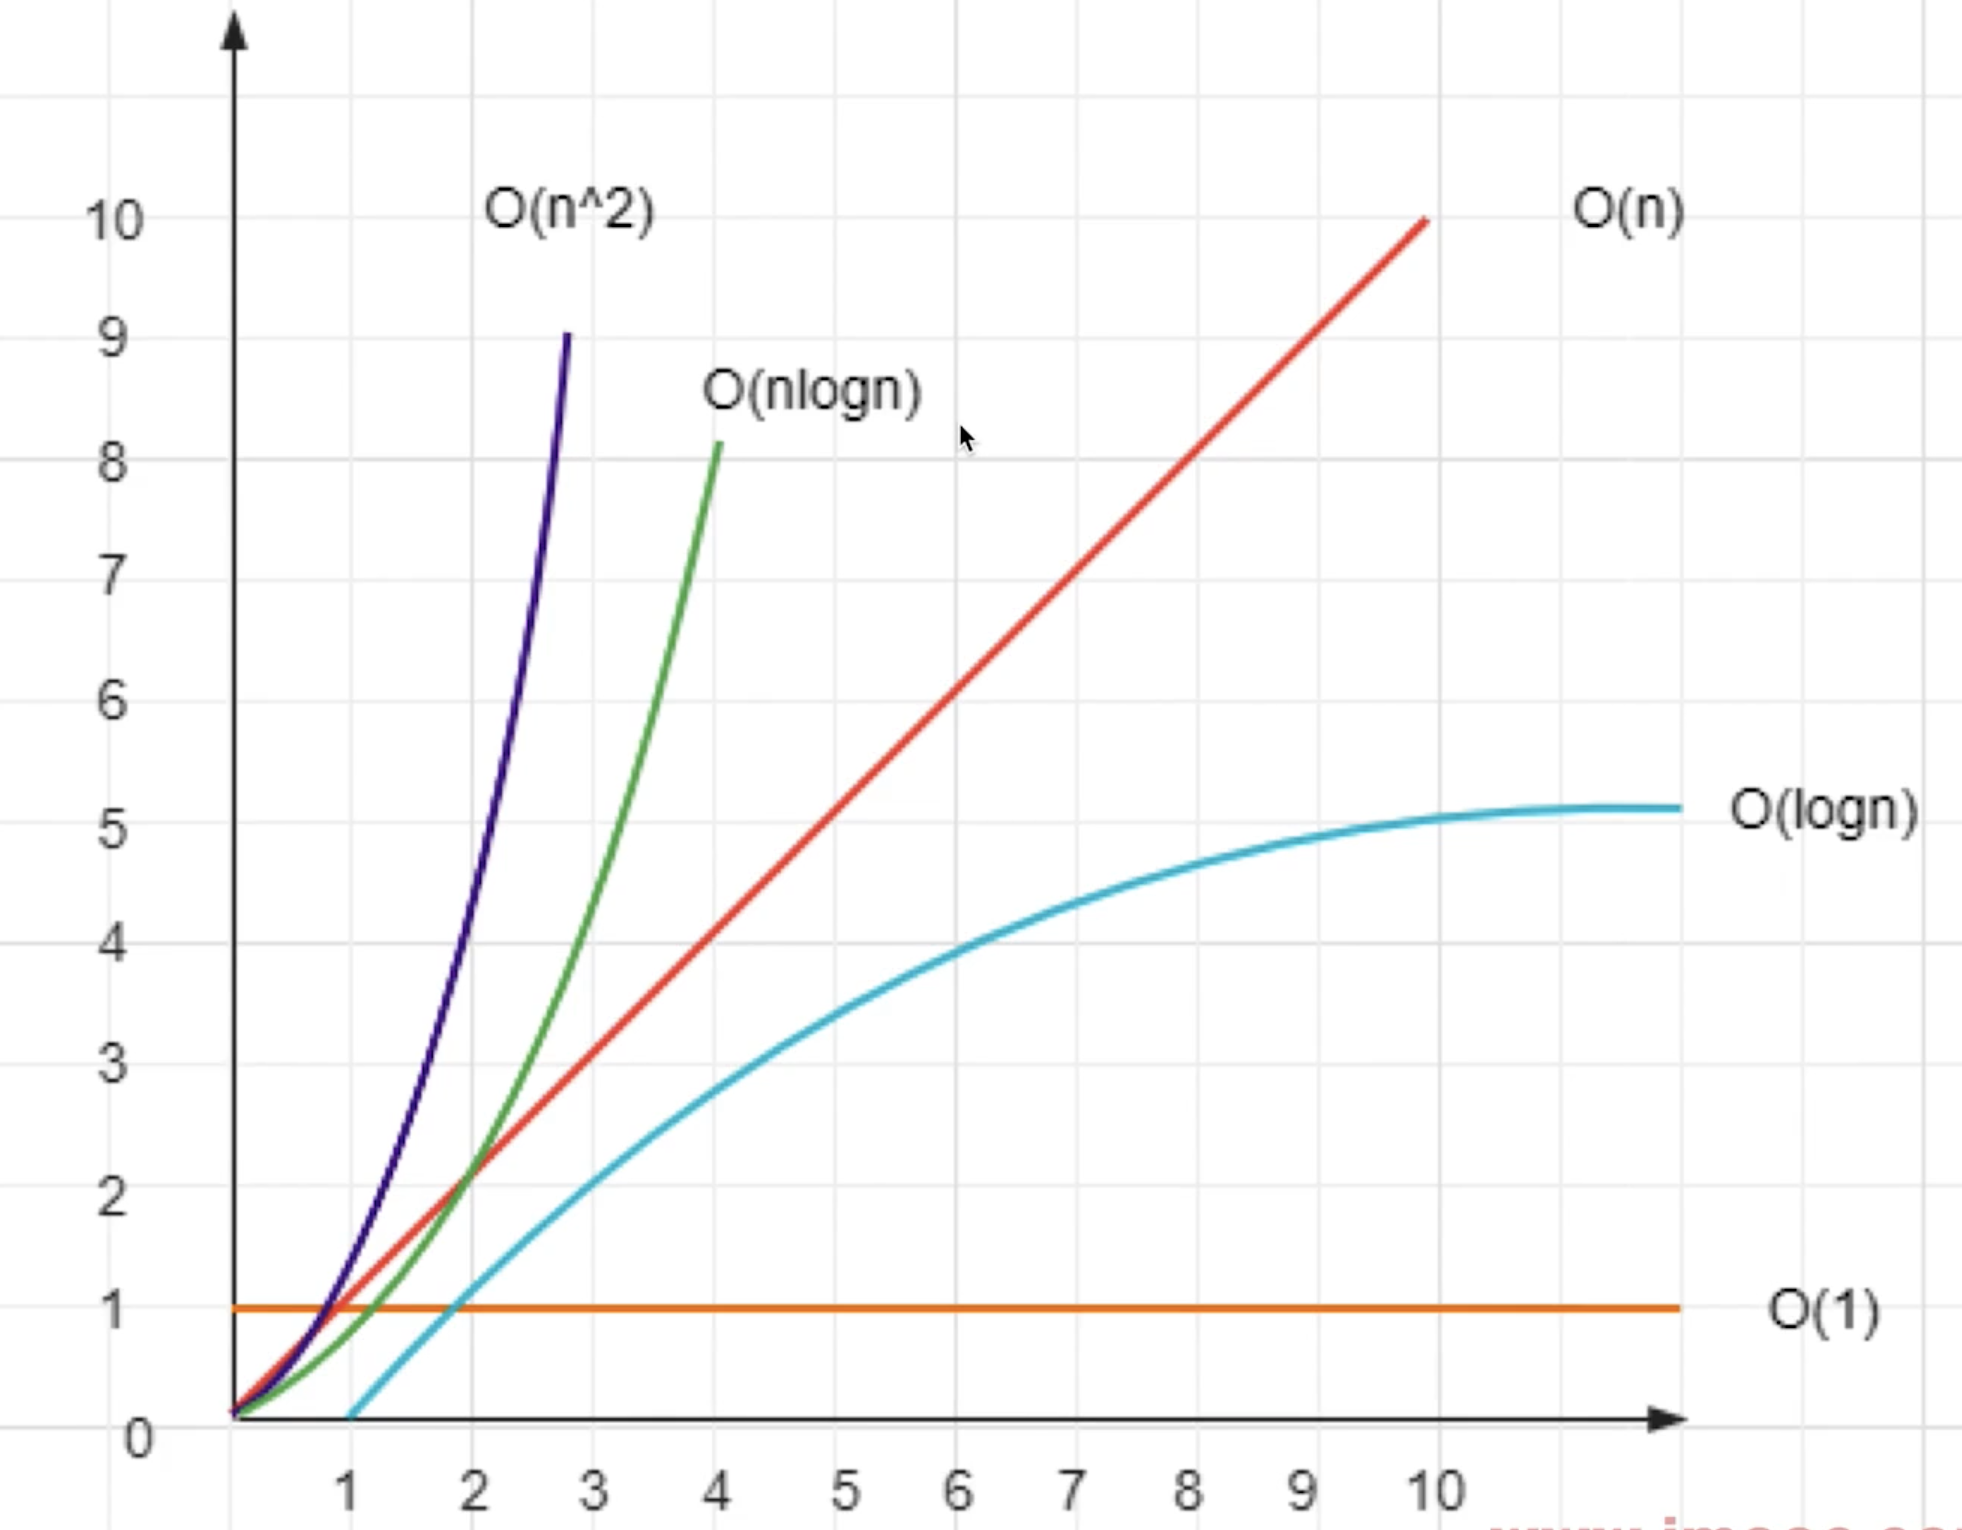
快速排序(使用 splice)
/**
 * 快速排序(使用 splice)
 * @param arr:number[] number arr
 */
function quickSort1(arr) {
  const length = arr.length
  if (length === 0) return arr

  // 获取中间的数
  const midIndex = Math.floor(length / 2)
  const midValue = arr.splice(midIndex, 1)[0] // splice会修改原数组,传入开始位置和长度是1

  const left = []
  const right = []

  // 注意:这里不用直接用 length ,而是用 arr.length 。因为 arr 已经被 splice 给修改了
  for (let i = 0; i < arr.length; i++) {
    const n = arr[i]
    if (n < midValue) {
      // 小于 midValue ,则放在 left
      left.push(n)
    } else {
      // 大于 midValue ,则放在 right
      right.push(n)
    }
  }

  return quickSort1(left).concat([midValue], quickSort1(right))
}
快速排序(使用 slice)
/**
* 快速排序(使用 slice)
* @param arr number arr
*/
function quickSort2(arr) {
const length = arr.length
if (length === 0) return arr
// 获取中间的数
const midIndex = Math.floor(length / 2)
const midValue = arr.slice(midIndex, midIndex + 1)[0] // 使用slice不会修改原数组,传入开始位置和结束位置
const left = []
const right = []
for (let i = 0; i < length; i++) {
if (i !== midIndex) { // 这里要忽略掉midValue
const n = arr[i]
if (n < midValue) {
// 小于 midValue ,则放在 left
left.push(n)
} else {
// 大于 midValue ,则放在 right
right.push(n)
}
}
}
return quickSort2(left).concat([midValue], quickSort2(right))
}
// 功能测试
const arr1 = [1, 6, 2, 7, 3, 8, 4, 9, 5]
console.info(quickSort2(arr1))
// 性能测试
// 快速排序(使用 splice)
const arr1 = []
for (let i = 0; i < 10 * 10000; i++) {
arr1.push(Math.floor(Math.random() * 1000))
}
console.time('quickSort1')
quickSort1(arr1)
console.timeEnd('quickSort1') // 74ms
// 快速排序(使用 slice)
const arr2 = []
for (let i = 0; i < 10 * 10000; i++) {
arr2.push(Math.floor(Math.random() * 1000))
}
console.time('quickSort2')
quickSort2(arr2)
console.timeEnd('quickSort2') // 82ms
// 单独比较 splice 和 slice
const arr1 = []
for (let i = 0; i < 10 * 10000; i++) {
arr1.push(Math.floor(Math.random() * 1000))
}
console.time('splice')
arr1.splice(5 * 10000, 1)
console.timeEnd('splice') // 0.08ms
const arr2 = []
for (let i = 0; i < 10 * 10000; i++) {
arr2.push(Math.floor(Math.random() * 1000))
}
console.time('slice')
arr2.slice(5 * 10000, 5 * 10000 + 1)
console.timeEnd('slice') // 0.008ms
💬 面试官追问
排行榜有十万条相同分数,使用
quickSort2后递归深度异常增长;你能从分区代码解释原因吗?代码把所有不小于
midValue的元素都放入right,相同值会集中到单侧,分区从近似二分退化为每次只移除一个基准。此时运行时间和递归深度都可能退化到O(n²)与O(n);可增加等值分区,但会占用额外数组空间。数据看板同时保留原始数组和排序结果,团队在
quickSort1与quickSort2之间争论,你会依据哪项可观察行为选型?quickSort1通过splice删除基准,会修改传入数组;quickSort2使用slice读取基准,不会直接删改原数组。需要保留输入时应选无修改版本或显式复制,但两者的递归分区都会创建left、right和拼接结果,不能仅凭一次耗时决定整体成本。接口返回近乎有序的百万条数据,中间位置取基准是否就能保证这段实现始终是
O(nlogn)?不能,基准取中间索引只固定了位置,并不保证其数值能把数据均匀分开,特殊分布和大量重复值仍会造成偏斜。平均情况下可接近
O(nlogn),最坏情况仍是O(n²);生产方案还要限制递归深度或采用更稳健的基准与分区策略。线上偶发
Maximum call stack size exceeded,输入没有环且元素都是数字,你会收集什么数据来确认是不是快速排序退化?应记录每层分区的输入长度、
left与right大小及最大递归深度,若长期呈现0对n-1,即可确认分区严重失衡。再检查重复值占比和基准分布,并用最小样本复现;只扩大调用栈会延后崩溃,不能修复二次复杂度。性能评审中有人拿示例里的
74ms和82ms断言splice版本更快,你会接受这个结论吗?不能据此形成通用结论,这只是特定随机数据与运行环境下的一次示例结果,而且两个版本接收的随机数组并不相同。应使用同源数据、多轮预热和重复测量,同时检查输入是否被修改及内存分配;即使局部更快,也不能覆盖语义差异和最坏情况风险。
# 3 选择排序
⚡ 30 秒速记
- 选择排序会从未排序区间中找到最小元素,再把它交换到当前区间的起点。
- 外层循环用
i划分已排序和未排序部分,内层循环通过minIndex记录最小值的索引,遍历结束后再决定是否交换。 - 这里保存索引而不是元素,是因为交换时需要准确定位数组位置。
- 若
minIndex就是i,说明当前位置已经正确,可以跳过交换。
选择排序会从未排序区间中找到最小元素,再把它交换到当前区间的起点。 外层循环用 i 划分已排序和未排序部分,内层循环通过 minIndex 记录最小值的索引,遍历结束后再决定是否交换。这里保存索引而不是元素,是因为交换时需要准确定位数组位置。若 minIndex 就是 i,说明当前位置已经正确,可以跳过交换。
function selectSort(arr) {
// 缓存数组长度
const len = arr.length;
// 定义 minIndex,缓存当前区间最小值的索引,注意是索引
let minIndex;
// i 是当前排序区间的起点
for (let i = 0; i < len - 1; i++) {
// 初始化 minIndex 为当前区间第一个元素
minIndex = i;
// i、j分别定义当前区间的上下界,i是左边界,j是右边界
for (let j = i; j < len; j++) {
// 若 j 处的数据项比当前最小值还要小,则更新最小值索引为 j
if (arr[j] < arr[minIndex]) {
minIndex = j;
}
}
// 如果 minIndex 对应元素不是目前的头部元素,则交换两者
if (minIndex !== i) {
[arr[i], arr[minIndex]] = [arr[minIndex], arr[i]];
}
}
return arr;
}
// console.log(selectSort([3, 6, 2, 4, 1]));
💬 面试官追问
用户列表按积分排序后,同积分用户的注册先后顺序被打乱;结合这段
selectSort,你会怎样解释这个反例?选择排序会把后方找到的最小元素与区间头部直接交换,跨越中间元素时可能改变相等项的相对顺序。代码虽只在严格更小时更新
minIndex,仍不能保证整体稳定;若业务依赖次级顺序,应增加明确比较键或选择稳定排序方案。低内存设备要对几千个数字原地排序,团队在选择排序和创建多个辅助数组的方案间取舍,你会看重什么?
这段选择排序直接交换原数组元素,除少量索引变量外不需要随输入增长的辅助空间,适合空间约束明确且规模有限的场景。它的比较次数仍是
O(n²),数据增长后耗时会迅速放大;原地修改也必须得到调用方契约允许。产品把数据量从一千条提高到十万条,但认为选择排序每轮最多交换一次,所以仍然够快,你会怎样回应?
交换次数少不代表比较次数少,每个位置仍要扫描后续区间寻找最小值,总比较量按平方级增长。十万级数据不应仅凭交换成本判断,应改用复杂度更合适的排序或缩小数据集;若写入成本极高,少交换才可能成为单独的取舍依据。
线上结果只在包含字符串数字时看起来错误,例如
"10"排在"2"前面,你会先查数据还是循环边界?循环边界能覆盖待排序区间,更应先确认元素类型,因为
<对两个字符串执行的是按字符顺序比较。入口应统一为数值,或注入符合业务含义的比较器,并为混合类型直接报错;隐式转换规则复杂,静默兼容容易制造新的排序歧义。代码评审时有人把内层循环起点从
j = i改为j = i + 1,你会批准吗?可以批准,因为
minIndex已初始化为i,再拿arr[i]与自身比较不会更新结果,属于一次冗余比较。修改后排序语义不变,但仍要覆盖空数组、单元素、逆序和重复值测试;这只是常数级优化,不会改变O(n²)的复杂度。
# 4 插入排序
⚡ 30 秒速记
- 插入排序会把当前元素插入前面已经排好序的区间,最终让整个数组有序。
- 代码从索引
1开始,用target暂存待插入元素,再把所有比它大的前置元素依次向后移动。 - 找到合适位置后,将
target写入arr[j],这样不会在移动过程中丢失原值。 - 边界由
j > 0控制,避免继续访问数组左侧之外的位置。
插入排序会把当前元素插入前面已经排好序的区间,最终让整个数组有序。 代码从索引 1 开始,用 target 暂存待插入元素,再把所有比它大的前置元素依次向后移动。找到合适位置后,将 target 写入 arr[j],这样不会在移动过程中丢失原值。边界由 j > 0 控制,避免继续访问数组左侧之外的位置。
function insertSort(arr) {
for (let i = 1; i < arr.length; i++) {
let j = i;
let target = arr[j];
while (j > 0 && arr[j - 1] > target) {
arr[j] = arr[j - 1];
j--;
}
arr[j] = target;
}
return arr;
}
// console.log(insertSort([3, 6, 2, 4, 1]));
💬 面试官追问
日志列表原本几乎有序,每次只追加少量新记录;为什么这段
insertSort可能比固定执行完整双重扫描更合适?插入排序只会把当前元素向左移动到正确位置,近乎有序时每个新增元素通常只需少量比较和搬移。其最好情况接近线性,且实现可原地工作;若输入变成大规模逆序数组,移动次数会退化为平方级,优势就不再成立。
表格按价格排序后,相同价格商品必须保持接口返回顺序,这段实现能满足吗?
能满足当前数值比较场景,因为循环条件是
arr[j - 1] > target,相等时不会移动前面的元素,因而保留相同键的相对顺序。若后来把条件改成>=或引入行为不同的比较器,稳定性会被破坏;应使用带原始序号的测试锁定约束。浏览器需要处理五十万条逆序记录,负责人坚持沿用插入排序并放进
Worker,你会指出什么边界?逆序输入会让每个元素几乎移动到数组开头,比较和赋值次数都达到
O(n²)级别,Worker只隔离主线程阻塞。应更换适合大规模数据的排序或把工作下沉到服务端;跨线程传输和复制本身也有成本,不能当作算法优化。线上排序后偶尔出现对象记录完全没动,调用方传入的是
{ score: 10 }这类元素,你会怎样排查?现有条件直接执行
arr[j - 1] > target,没有读取score,对象之间的默认关系比较并不代表业务分数大小。应要求显式比较器或先提取排序键,并验证键是否为有限数值;键缺失时继续排序会产生静默错误,宜尽早拒绝异常数据。同事提出把向右逐个赋值改成每次交换相邻元素,认为代码更直观;在大型对象数组评审中你会如何取舍?
逐个右移只保存一次
target,而相邻交换通常对同一段路径执行更多读写,未必适合移动成本敏感的场景。两种写法的最坏复杂度都为O(n²),应以可读性、写入成本和基准结果共同判断;若数据规模已很大,纠结局部写法不如先更换算法。
# 5 二分查找
⚡ 30 秒速记
- 二分查找通过不断比较中间元素来缩小范围,但前提是传入的数组已经有序。
- 每次用
start和end计算mid,命中就返回索引;目标更大时查右半区,否则查左半区。 - 递归调用会把边界更新为
mid + 1或mid - 1,因此不会重复检查中间位置。 - 当
start >= end且仍未命中时返回-1,表示数组中不存在目标元素。
二分查找通过不断比较中间元素来缩小范围,但前提是传入的数组已经有序。 每次用 start 和 end 计算 mid,命中就返回索引;目标更大时查右半区,否则查左半区。递归调用会把边界更新为 mid + 1 或 mid - 1,因此不会重复检查中间位置。当 start >= end 且仍未命中时返回 -1,表示数组中不存在目标元素。
function search(arr, target, start, end) {
let targetIndex = -1;
let mid = Math.floor((start + end) / 2);
if (arr[mid] === target) {
targetIndex = mid;
return targetIndex;
}
if (start >= end) {
return targetIndex;
}
if (arr[mid] < target) {
return search(arr, target, mid + 1, end);
} else {
return search(arr, target, start, mid - 1);
}
}
// const dataArr = [1, 2, 3, 4, 5, 6, 7, 8, 9];
// const position = search(dataArr, 6, 0, dataArr.length - 1);
// if (position !== -1) {
// console.log(`目标元素在数组中的位置:${position}`);
// } else {
// console.log("目标元素不在数组中");
// }
💬 面试官追问
商品列表明明按价格升序排列,
search查找存在的价格却偶尔返回-1;同事把start、end都按数组切片的右开区间传入,你怎么判断问题?当前实现把
end当作可访问的闭区间上界,首次调用应传0和arr.length - 1。若传入arr.length,mid可能落到无效位置,递归边界也与右开区间约定冲突;应统一接口语义并补充空数组、单元素和末元素用例。订单页需要在百万条已排序订单号中定位目标,前端同事担心递归版会像线性扫描一样卡住,你会如何评估并改造?
二分查找每轮排除一半区间,时间复杂度是
O(log n),百万级数据本身不会带来百万层递归。工程上仍可改成while (start <= end)的迭代写法,减少函数调用和参数误传;前提是数据已按同一比较规则排序,否则结果不可信。库存数组包含多个相同批次号,产品要求返回第一个匹配位置,但当前
arr[mid] === target就立即返回,你会怎样修改?命中后不能立刻结束,应先记录
mid,再把右边界收缩到mid - 1,继续寻找更靠左的相同值。这样仍保持O(log n);若要求最后一个位置则反向收缩左边界,若数组未排序则不能沿用该策略。搜索页偶发死循环,监控显示请求前数组长度正常,但有人把递归分支改成了
search(arr, target, mid, end),你会先检查什么?应先检查区间是否在每次递归后严格缩小;保留
mid会在相邻双元素区间反复计算出同一位置。右半区必须从mid + 1开始,左半区必须到mid - 1,并用不存在目标、两元素数组和边界目标复现;仅调整终止条件可能掩盖错误。接口返回的是按字符串排序的商品编码,例如
"10"排在"2"前面,前端却按数值大小执行二分;评审时你会如何处理这个选型冲突?查找使用的比较规则必须与生成有序数组时完全一致,否则“有序性”对算法并不成立。应把比较器显式传入搜索函数,或在数据进入页面时统一编码类型并重新排序;重新排序有
O(n log n)成本,也可能破坏后端约定的展示顺序。
# 35 算法数据结构
这一组收录 120 道高频核心题,不是按题号背答案,而是按「数据结构 → 解题套路 → 边界」复习。题目从链表、栈队列、哈希、树、二分、回溯、动态规划和双指针等主题中筛选后重新组织;外部仓库只用于核对选题覆盖范围,题面、讲解、实现与演示均由本站独立重写。示例实现以面试现场可讲清、可运行、可验证为目标,代码的每一行都附有说明。
# 1 实现一个单向链表
⚡ 30 秒速记
- 单向链表用节点保存
value和next,链表本身维护head、tail与size - 头部增删和尾部追加可以做到
O(1),按索引访问仍是O(n) - 插入允许索引等于
size,查询和删除只允许到size - 1
单向链表的重点不是把数组换成对象,而是维护好头指针、尾指针和长度三个不变量。 我会把节点查找收进私有辅助方法,插入和删除只负责重新连接指针;空链表、删除尾节点和越界是最容易漏掉的边界。
# 题目与解题思路
实现支持追加、按索引插入、按索引删除、按索引读取和转数组的单向链表。关键是先找到目标位置的前驱节点,再一次性改好连接关系;任何修改完成后,head、tail、size 必须仍然互相一致。
class ListNode { // 定义单向链表节点
constructor(value, next = null) { // 接收节点值和后继节点
this.value = value // 保存当前节点的数据
this.next = next // 保存指向下一个节点的引用
} // 结束节点构造函数
} // 结束节点类
class SinglyLinkedList { // 定义单向链表
constructor() { // 初始化空链表
this.head = null // 头指针暂时没有节点
this.tail = null // 尾指针暂时没有节点
this.size = 0 // 空链表长度为零
} // 结束链表构造函数
getNode(index) { // 根据索引返回节点
if (index < 0 || index >= this.size) throw new RangeError('索引越界') // 拒绝非法查询位置
let current = this.head // 从头节点开始移动
for (let i = 0; i < index; i += 1) current = current.next // 前进到目标索引
return current // 返回找到的节点
} // 结束节点查询
append(value) { // 在链表尾部追加值
const node = new ListNode(value) // 创建新的尾节点
if (this.size === 0) this.head = node // 空链表时新节点也是头节点
else this.tail.next = node // 非空时让旧尾节点连接新节点
this.tail = node // 更新尾指针
this.size += 1 // 更新链表长度
return this // 返回链表以支持链式调用
} // 结束尾部追加
insert(index, value) { // 在指定索引前插入值
if (index < 0 || index > this.size) throw new RangeError('索引越界') // 插入位置可等于当前长度
if (index === this.size) return this.append(value) // 尾部插入复用追加逻辑
const node = new ListNode(value) // 创建待插入节点
if (index === 0) { // 单独处理头部插入
node.next = this.head // 新节点先连接旧头节点
this.head = node // 再把头指针切到新节点
this.size += 1 // 更新链表长度
return this // 返回修改后的链表
} // 结束头部插入分支
const previous = this.getNode(index - 1) // 找到插入位置的前驱节点
node.next = previous.next // 新节点连接原来的后继节点
previous.next = node // 前驱节点连接新节点
this.size += 1 // 更新链表长度
return this // 返回修改后的链表
} // 结束指定位置插入
remove(index) { // 删除并返回指定索引的值
if (index < 0 || index >= this.size) throw new RangeError('索引越界') // 删除位置不能等于长度
let removed = null // 保存即将移除的节点
if (index === 0) { // 单独处理头节点
removed = this.head // 记录旧头节点
this.head = this.head.next // 头指针移动到下一个节点
} else { // 处理中间或尾部节点
const previous = this.getNode(index - 1) // 找到目标节点的前驱
removed = previous.next // 记录目标节点
previous.next = removed.next // 前驱跨过目标节点连接其后继
if (index === this.size - 1) this.tail = previous // 删除尾节点时更新尾指针
} // 结束删除位置分支
this.size -= 1 // 更新链表长度
if (this.size === 0) this.tail = null // 链表清空时同步清空尾指针
removed.next = null // 断开被删节点与链表的连接
return removed.value // 返回被删除的数据
} // 结束删除方法
toArray() { // 把链表转换成数组便于验证
const result = [] // 创建结果数组
let current = this.head // 从头节点开始遍历
while (current) { // 只要当前节点存在就继续
result.push(current.value) // 收集当前节点的数据
current = current.next // 移动到下一个节点
} // 结束链表遍历
return result // 返回所有节点值
} // 结束数组转换
} // 结束链表类
# 复杂度、示例与易错点
append为O(1);getNode、中间插入和中间删除为O(n);额外空间为O(1)。- 示例:依次执行
append(1)、append(3)、insert(1, 2),toArray()应得到[1, 2, 3];再删除索引2,应返回3,且tail.value为2。 - 易错点:空链表第一次追加时要同时设置
head和tail;删掉唯一节点后也要同时清空两者。
💬 面试官追问
消息流只在头部插入,为什么链表不一定比数组慢?
已拿到头指针时,链表头插只改两个引用,复杂度是
O(1);数组头插通常要移动后续元素。链表的代价是不能常数时间按索引读取,并且每个节点还要保存指针。压测发现尾部追加越来越慢,你会先检查什么?
先检查实现是否维护
tail。只有head的单链表每次追加都要从头遍历,单次会退化为O(n);维护尾指针后才能稳定为O(1)。删除最后一个节点后还能从
tail读到旧值,问题在哪里?删除逻辑只移动了
head,没有在size变成零时把tail设为null。这会留下悬空状态,后续追加也可能接到旧链上。链表已经很长,业务又频繁按索引读取,你会继续用它吗?
通常不会。按索引读取是
O(n),高频随机访问更适合数组;除非调用方能直接持有节点引用,或业务更看重常数时间的局部插入删除。
# 2 用链表实现一个队列
⚡ 30 秒速记
- 队列遵循先进先出,入队连接
tail,出队移动head - 同时维护头尾指针后,入队和出队都能做到
O(1) - 出队最后一个元素时必须把
tail一并清空
队列的接口只暴露先进先出语义,不让调用方按索引随意删除。 链表实现要直接维护队头和队尾,避免复用一个尾部追加仍需遍历的普通链表,否则看似用了链表,入队仍会退化。
# 题目与解题思路
实现 enqueue、dequeue、peek 和 isEmpty。入队时只操作尾部,出队时只操作头部;空队列读取统一返回 undefined,让调用方能显式判断。
class QueueNode { // 定义队列内部节点
constructor(value) { // 接收节点值
this.value = value // 保存当前值
this.next = null // 新节点默认没有后继
} // 结束节点构造函数
} // 结束节点类
class LinkedQueue { // 定义链式队列
constructor() { // 初始化空队列
this.head = null // 队头暂时为空
this.tail = null // 队尾暂时为空
this.size = 0 // 队列长度为零
} // 结束队列构造函数
enqueue(value) { // 把值加入队尾
const node = new QueueNode(value) // 创建新的队尾节点
if (this.tail) this.tail.next = node // 非空队列让旧尾连接新尾
else this.head = node // 空队列时新节点也是队头
this.tail = node // 更新队尾指针
this.size += 1 // 增加队列长度
return this.size // 返回入队后的长度
} // 结束入队方法
dequeue() { // 取出并删除队头
if (!this.head) return undefined // 空队列没有可取元素
const value = this.head.value // 先保存队头的值
this.head = this.head.next // 再把队头移到下一个节点
this.size -= 1 // 减少队列长度
if (this.size === 0) this.tail = null // 队列清空时同步清空队尾
return value // 返回最早入队的值
} // 结束出队方法
peek() { // 查看但不删除队头
return this.head ? this.head.value : undefined // 根据队头是否存在返回值
} // 结束查看队头
isEmpty() { // 判断队列是否为空
return this.size === 0 // 长度为零就表示空队列
} // 结束空队列判断
} // 结束队列类
# 复杂度、示例与易错点
- 入队、出队、查看队头均为
O(1),队列保存n个节点需要O(n)空间。 - 示例:依次入队
A、B,两次出队应依次得到A、B,第三次得到undefined。 - 易错点:不要用数组的
shift()模拟超长队列;不要把peek()与dequeue()分成跨异步流程的非原子消费。
💬 面试官追问
任务队列每秒持续入队,为什么只维护
head会越来越慢?因为每次入队都要遍历到链尾,单次复杂度是
O(n)。维护tail后可以直接连接新节点,把入队降为O(1)。两个异步消费者都先
peek()再dequeue(),为什么可能重复处理?两步之间存在竞争窗口,两个消费者可能看到同一个队头。单进程内应把“读取并删除”合成一次同步调用,跨进程则需要真正支持原子消费的消息队列。
空队列时应该抛错还是返回
undefined?两种契约都可以,但必须统一。通用容器通常返回
undefined便于轮询;如果空队列代表程序错误,抛异常会更早暴露问题。浏览器里要缓存百万条事件,这个队列可以直接用吗?
结构操作虽是常数时间,但节点对象仍占大量内存。还需要容量上限、丢弃策略和持久化方案,不能只看单次操作复杂度。
# 3 反转单向链表
⚡ 30 秒速记
- 迭代版维护
previous、current、next三个指针 - 每轮先保存后继,再反转当前指针,最后整体向前移动
- 时间是
O(n),迭代额外空间是O(1),比递归版更不怕深链表爆栈
反转链表最容易错在先改 current.next,却忘了保存原来的后继。 我会先用 next 暂存未处理部分,再让当前节点指向前驱,最后移动两个工作指针;循环结束时 previous 就是新头节点。
# 题目与解题思路
给定单向链表头节点,原地反转链表并返回新的头节点。循环不变量是:previous 指向已经反转好的部分,current 指向尚未处理部分的第一个节点。
function reverseList(head) { // 接收原链表头节点
let previous = null // 已反转部分最初为空
let current = head // 未处理部分最初从原头开始
while (current) { // 当前节点存在时继续反转
const next = current.next // 先保存原来的后继节点
current.next = previous // 让当前节点改为指向前驱
previous = current // 扩大已经反转好的部分
current = next // 移动到尚未处理的下一个节点
} // 结束全部节点的处理
return previous // 原尾节点现在成为新头节点
} // 结束链表反转函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(1)。 - 示例:
1 → 2 → 3 → null反转为3 → 2 → 1 → null;空链表仍返回null。 - 易错点:必须先保存
current.next;否则第一次改指针后就丢失剩余链表。
💬 面试官追问
为什么递归版也是
O(n),你却更推荐迭代版?两者访问节点次数相同,但递归版还占用
O(n)调用栈,长链表可能触发栈溢出。迭代版只保留三个指针,额外空间是O(1)。反转后遍历一直不结束,你先检查哪一行?
先检查原头节点最终是否指向
null。迭代版会在第一轮自然完成这件事;递归版如果漏掉断链,最容易形成环。要求只反转索引
left到right的区间,核心思路会变吗?局部反转仍使用三指针,但要额外保存区间前驱和区间原头,完成后把两端重新接回原链表。难点从“反转”变成“边界重连”。
链表节点被冻结,不能修改
next,怎么处理?只能创建新节点并按逆序连接,额外空间变成
O(n)。是否允许原地修改是题目契约的一部分,不能默认忽略。
# 4 找到环形链表的入环节点
⚡ 30 秒速记
- 快慢指针第一次相遇只能证明有环,不能直接当作环入口
- 相遇后让一个指针回到头节点,两者同速前进,再次相遇的位置就是入口
- 整体时间
O(n)、额外空间O(1),空链表和无环链表返回null
这题用的是 Floyd 快慢指针。 快指针每次走两步、慢指针走一步;若能相遇说明存在环。相遇后把其中一个指针放回头部,再同速走,它们下一次相遇的位置就是入环节点。
# 题目与解题思路
先用速度差制造环内相遇,再利用距离关系定位入口。设头到入口距离为 a,入口到首次相遇点距离为 b,环长为 c,相遇时快指针比慢指针多走若干整环,因此可以推出从头与从相遇点同速前进会在入口相遇。
function detectCycleEntry(head) { // 接收链表头节点
let slow = head // 慢指针每轮走一步
let fast = head // 快指针每轮走两步
while (fast && fast.next) { // 快指针还能前进两步时继续
slow = slow.next // 慢指针前进一步
fast = fast.next.next // 快指针前进两步
if (slow !== fast) continue // 尚未相遇就进入下一轮
let finder = head // 新指针从链表头开始
while (finder !== slow) { // 两个指针未在入口相遇时继续
finder = finder.next // 头部指针前进一步
slow = slow.next // 相遇点指针也前进一步
} // 结束入口定位
return finder // 返回入环节点
} // 结束快慢指针扫描
return null // 快指针到达末尾说明没有环
} // 结束环入口检测函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(1)。 - 示例:
1 → 2 → 3 → 4且4.next = 2时返回值为2的节点;普通链表返回null。 - 易错点:首次相遇点通常不是入口;循环条件必须同时检查
fast和fast.next。
💬 面试官追问
只要求判断有没有环,还需要第二阶段吗?
不需要。快慢指针一旦相遇即可返回
true,快指针走到末尾则返回false;第二阶段只为定位入口。用
Set记录节点是不是更容易?是,第一次遇到重复引用就是入口,代码也更直观;代价是额外
O(n)空间。题目若要求常量空间,就要用快慢指针。链表只有一个节点,并且自己指向自己,代码能处理吗?
能。第一次循环后快慢指针仍指向该节点,第二阶段无需移动,直接返回头节点。
线上遍历卡死,但数据不是严格链表而是共享节点图,你还能套这个结论吗?
不能直接套。
Floyd依赖每个节点只有唯一后继;如果存在多分支,就应按图遍历并维护访问集合。
# 5 合并两个有序链表
⚡ 30 秒速记
- 用哑节点统一处理新链表头部,
tail始终指向已合并部分的尾节点 - 每轮比较两个当前节点,把较小者接到结果后面并移动对应指针
- 一条链表耗尽后,剩余部分已经有序,可以整体接上
合并时不用创建新节点,只要重连现有节点。 哑节点解决“第一次接谁”的分支,循环里维持结果链表始终有序;最后直接挂上未耗尽的那条链表即可。
# 题目与解题思路
给定两个按升序排列的单向链表,合并为一个升序链表。循环不变量是:dummy.next 到 tail 已经有序,且其中每个节点都不大于两条剩余链表的当前节点。
function mergeSortedLists(first, second) { // 接收两个升序链表的头节点
const dummy = { value: 0, next: null } // 创建不参与结果的哑节点
let tail = dummy // 结果尾指针最初指向哑节点
let left = first // 左侧工作指针从第一条链表开始
let right = second // 右侧工作指针从第二条链表开始
while (left && right) { // 两条链表都有剩余节点时比较
if (left.value <= right.value) { // 左侧值更小或相等时优先取左侧
tail.next = left // 把左侧节点接到结果尾部
left = left.next // 左侧指针向后移动
} else { // 右侧值更小时处理右侧
tail.next = right // 把右侧节点接到结果尾部
right = right.next // 右侧指针向后移动
} // 结束本轮大小判断
tail = tail.next // 结果尾指针移动到刚接入的节点
} // 结束双链表比较
tail.next = left || right // 直接接上尚未耗尽的有序部分
return dummy.next // 跳过哑节点返回真正头节点
} // 结束有序链表合并函数
# 复杂度、示例与易错点
- 时间复杂度
O(m + n),额外空间复杂度O(1)。 - 示例:
1 → 3 → 5与1 → 2 → 4合并后得到1 → 1 → 2 → 3 → 4 → 5。 - 易错点:这版会复用并改写原链表连接;如果调用方还要保留输入,必须复制节点。
💬 面试官追问
为什么用哑节点比单独判断新头更稳?
它让第一次连接和后续连接走同一套逻辑,避免结果头为空时增加分支。最终返回
dummy.next即可。相等元素先取哪一边有区别吗?
若节点还携带业务信息,先取左边能保持两条来源内部的相对顺序,体现稳定性。只比较数字结果时数值序列相同,但引用顺序仍可能不同。
要合并一百条有序链表,逐条合并好吗?
逐条合并会反复扫描越来越长的结果。更合适的是最小堆维护每条链表当前节点,或用分治两两合并,把复杂度控制在
O(N log k)。输入链表意外共享了后半段节点,会发生什么?
直接重连可能重复接入同一节点甚至形成环。工程代码应明确输入必须互不相交,或先做引用检测,但后者会增加空间与时间。
# 6 实现有效括号校验
⚡ 30 秒速记
- 左括号入栈,右括号必须与栈顶左括号匹配
- 遇到右括号时栈为空,或扫描结束后栈非空,都表示无效
- 哈希映射把三种括号统一为一套逻辑,时间
O(n)、空间O(n)
括号匹配看的是最近一个尚未闭合的左括号,所以天然适合栈。 右括号只能消掉栈顶对应项,不能跨过内层括号;扫描完成后栈必须恰好为空。
# 题目与解题思路
判断只包含圆括号、方括号和花括号的字符串是否有效。用映射记录“右括号 → 左括号”,这样扫描到右括号时只需比较一次栈顶。
function isValidBrackets(text) { // 接收待校验字符串
const pairs = { ')': '(', ']': '[', '}': '{' } // 建立右括号到左括号的映射
const stack = [] // 创建保存未闭合左括号的栈
for (const char of text) { // 从左到右扫描每个字符
if (!pairs[char]) { // 当前字符不是右括号时按左括号处理
stack.push(char) // 把左括号压入栈顶
continue // 继续扫描下一个字符
} // 结束左括号分支
if (stack.pop() !== pairs[char]) return false // 栈顶不匹配时立即判定无效
} // 结束字符串扫描
return stack.length === 0 // 没有剩余左括号才算完全匹配
} // 结束括号校验函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),最坏额外空间复杂度O(n)。 - 示例:
"([]{})"返回true,"([)]"和"(("返回false。 - 易错点:如果输入可能包含普通字符,不能把所有非右括号都当成左括号,应先限定字符集或显式跳过普通字符。
💬 面试官追问
为什么不能只统计三种括号数量是否相等?
数量相等不能保证嵌套顺序正确,例如
([)]数量完全对应但交叉闭合。栈能验证最近未闭合项。输入长度是奇数时能提前返回吗?
如果题目保证只有括号字符,可以直接返回
false;若允许普通字符,就不能只看原字符串长度。模板解析器还要支持引号内的括号,当前实现够吗?
不够。需要增加词法状态,进入字符串或注释后暂时忽略括号,并正确处理转义字符;这已经从简单栈题升级为扫描器问题。
频繁调用时要不要把
pairs放到函数外?可以减少重复对象创建,但收益通常很小。更重要的是先明确输入契约并用异常字符、空串和深层嵌套做测试。
# 7 二叉树前序、中序和后序遍历
⚡ 30 秒速记
- 三种深度优先遍历的差别只是“访问根节点”的时机
- 前序是根左右,中序是左根右,后序是左右根
- 二叉搜索树的中序结果有序,后序适合先处理子节点再释放父节点
我会用一次递归同时展示三种顺序:进入节点时收集前序,左子树返回后收集中序,右子树返回后收集后序。 这样能直观看出遍历顺序不是三套完全不同的算法,而是访问时机不同。
# 题目与解题思路
给定二叉树根节点,返回三种深度优先遍历结果。递归出口是空节点;每个非空节点只访问一次,收集位置决定遍历顺序。
function traverseBinaryTree(root) { // 接收二叉树根节点
const preorder = [] // 保存前序遍历结果
const inorder = [] // 保存中序遍历结果
const postorder = [] // 保存后序遍历结果
function visit(node) { // 定义递归访问函数
if (!node) return // 空节点直接结束当前分支
preorder.push(node.value) // 进入节点时收集得到前序
visit(node.left) // 递归处理左子树
inorder.push(node.value) // 左子树完成后收集得到中序
visit(node.right) // 递归处理右子树
postorder.push(node.value) // 两棵子树完成后收集得到后序
} // 结束递归访问函数
visit(root) // 从根节点开始遍历
return { preorder, inorder, postorder } // 返回三种遍历结果
} // 结束二叉树遍历函数
# 复杂度、示例与易错点
- 三种结果在一次遍历中生成,时间复杂度
O(n);递归栈为O(h),结果数组为O(n)。 - 示例:根为
1、左子为2、右子为3时,前序[1,2,3],中序[2,1,3],后序[2,3,1]。 - 易错点:极深单支树可能栈溢出,工程上可改用显式栈的迭代遍历。
💬 面试官追问
二叉搜索树为什么中序遍历能得到升序?
因为每个节点左子树都小于节点、右子树都大于节点,按左根右访问自然从小到大;前提是树确实满足同一个比较器定义。
文件删除为什么更适合后序?
后序先处理所有子节点,最后处理父节点,符合“先删目录内容,再删目录本身”的依赖顺序。
十万层单支树递归爆栈,你怎么改?
使用显式数组模拟栈。前序可直接压右再压左;中序和后序需要额外记录访问状态或用双栈方案。
遍历过程中修改左右指针安全吗?
通常不安全,可能导致漏节点、重复访问或环。应先保存下一步引用,或把结构修改与只读遍历拆成两个阶段。
# 8 二叉树层序遍历
⚡ 30 秒速记
- 层序遍历使用队列,按先进先出顺序逐层访问
- 每轮先记录当前队列长度,这个长度就是当前层的节点数
- 子节点只在存在时入队,最终得到二维数组形式的分层结果
层序遍历就是广度优先搜索。 队列里保存下一批待访问节点,每层开始时冻结当前队列长度,只处理这一批;处理期间加入的子节点自然留给下一层。
# 题目与解题思路
给定二叉树根节点,返回按层分组的节点值。为了避免数组 shift() 的移动成本,使用索引模拟队头。
function levelOrder(root) { // 接收二叉树根节点
if (!root) return [] // 空树直接返回空结果
const queue = [root] // 把根节点加入待访问队列
let front = 0 // 用索引表示当前队头位置
const result = [] // 保存所有层的结果
while (front < queue.length) { // 队列仍有未处理节点时继续
const levelSize = queue.length - front // 冻结当前层的节点数量
const level = [] // 创建当前层结果数组
for (let i = 0; i < levelSize; i += 1) { // 只处理当前层已有节点
const node = queue[front] // 读取当前队头节点
front += 1 // 队头索引向后移动
level.push(node.value) // 收集当前节点值
if (node.left) queue.push(node.left) // 左子节点存在时加入下一层
if (node.right) queue.push(node.right) // 右子节点存在时加入下一层
} // 结束当前层处理
result.push(level) // 保存完整的一层
} // 结束全部层遍历
return result // 返回二维层序结果
} // 结束层序遍历函数
# 复杂度、示例与易错点
- 时间复杂度
O(n);队列和结果需要O(n)空间。 - 示例:
1的左右子节点为2、3,且2有左子4,结果是[[1], [2, 3], [4]]。 - 易错点:必须在进入内层循环前固定
levelSize,不能边入队边把下一层也算进当前层。
💬 面试官追问
为什么不直接循环到
queue.length?因为处理当前层时还会追加下一层节点,动态长度会把多层混在一起。冻结层大小才能得到正确分组。
数组
shift()为什么在大树上可能慢?shift()通常需要调整后续元素位置。用递增索引模拟队头可避免反复移动,但遍历结束后整个数组仍会保留到函数返回。要返回每层最大值,需要另做一次遍历吗?
不需要,在当前层循环里维护最大值即可。层序框架不变,只替换每层的聚合逻辑。
树节点意外互相引用形成环会怎样?
队列会不断重复入队。若输入不可信,应使用
Set记录已访问节点;严格二叉树题通常把无环作为前提。
# 9 两数之和
⚡ 30 秒速记
- 暴力枚举是
O(n²),哈希表能把“找另一个数”降为均摊O(1) - 扫描当前值时先查
target - value,再把当前值写入表,避免同一元素使用两次 - 哈希表保存“数值 → 索引”,重复值也能正确找到不同位置
两数之和的关键是把“过去见过哪些数”缓存下来。 扫描到当前值时,只需要查询它的补数是否出现过;先查后存可以保证不会把当前元素和自己配对。
# 题目与解题思路
给定整数数组和目标值,返回和为目标值的两个不同元素索引。用 Map 保存已扫描数值及其索引,每个元素最多处理一次。
function twoSum(numbers, target) { // 接收整数数组和目标和
const seen = new Map() // 保存已经扫描过的数值及索引
for (let index = 0; index < numbers.length; index += 1) { // 从左到右扫描数组
const value = numbers[index] // 读取当前数值
const complement = target - value // 计算当前值需要的补数
if (seen.has(complement)) return [seen.get(complement), index] // 补数出现过就返回两个索引
seen.set(value, index) // 当前值未配对成功时再写入哈希表
} // 结束数组扫描
return [] // 不存在答案时返回空数组
} // 结束两数之和函数
# 复杂度、示例与易错点
- 时间复杂度均摊为
O(n),额外空间复杂度为O(n)。 - 示例:
[2, 7, 11, 15]、目标9返回[0, 1];[3, 3]、目标6也能返回两个不同索引。 - 易错点:不要先写入再查询,否则目标是当前值两倍时可能错误地重复使用同一索引。
💬 面试官追问
数组已经升序,还需要哈希表吗?
不需要,可以用首尾双指针在
O(n)时间和O(1)额外空间内完成。是否有序会直接改变最合适的解法。需要返回所有不重复数值组合怎么办?
单个索引映射不够,需要排序后用双指针并跳过重复值,或用集合对结果标准化去重;还要先明确重复索引组合是否算不同答案。
数值很大时
target - value会有精度问题吗?超出
Number.MAX_SAFE_INTEGER后整数运算可能失真。需要改用BigInt,并保证输入、目标和哈希键都使用同一种数值类型。为什么不能直接用普通对象代替
Map?数字键会被转成字符串,还要处理原型属性等边界。
Map的键语义和存在性判断更直接,也不会把索引0误判为不存在。
# 10 三数之和
⚡ 30 秒速记
- 先排序,把无序的三重枚举转成“固定一个数 + 双指针找两数”
- 当前和偏小就移动左指针,偏大就移动右指针
- 固定值和双指针命中后都要跳过重复值,才能得到不重复三元组
三数之和的核心是排序后利用单调性。 固定第一个数,剩余区间用左右指针逼近目标;排序还让去重变得可控,不需要把每个答案再序列化进集合。
# 题目与解题思路
返回数组中所有和为零且不重复的三元组。先复制并排序,避免修改调用方数组;当固定值已经大于零时可以提前结束。
function threeSum(numbers) { // 接收待查找的整数数组
const sorted = [...numbers].sort((a, b) => a - b) // 复制并按数值升序排列
const result = [] // 保存不重复三元组
for (let i = 0; i < sorted.length - 2; i += 1) { // 固定三元组中的第一个数
if (sorted[i] > 0) break // 最小固定值已大于零时不可能再得到零
if (i > 0 && sorted[i] === sorted[i - 1]) continue // 跳过重复固定值
let left = i + 1 // 左指针从固定值右侧开始
let right = sorted.length - 1 // 右指针从数组末尾开始
while (left < right) { // 两个指针未相遇时继续搜索
const sum = sorted[i] + sorted[left] + sorted[right] // 计算当前三数之和
if (sum < 0) { // 当前和偏小时需要增大
left += 1 // 左指针右移取得更大值
continue // 进入下一轮比较
} // 结束偏小分支
if (sum > 0) { // 当前和偏大时需要减小
right -= 1 // 右指针左移取得更小值
continue // 进入下一轮比较
} // 结束偏大分支
result.push([sorted[i], sorted[left], sorted[right]]) // 收集一个合法三元组
left += 1 // 左指针越过当前命中位置
right -= 1 // 右指针越过当前命中位置
while (left < right && sorted[left] === sorted[left - 1]) left += 1 // 跳过重复左值
while (left < right && sorted[right] === sorted[right + 1]) right -= 1 // 跳过重复右值
} // 结束当前固定值的双指针搜索
} // 结束所有固定值扫描
return result // 返回全部不重复三元组
} // 结束三数之和函数
# 复杂度、示例与易错点
- 排序后双指针的时间复杂度为
O(n²),排序和结果之外的额外空间取决于排序实现。 - 示例:
[-1, 0, 1, 2, -1, -4]返回[[-1, -1, 2], [-1, 0, 1]]。 - 易错点:只给结果套
Set治标不治本;固定值、左值、右值三个层级都要按位置正确去重。
💬 面试官追问
为什么固定值大于零就能结束?
数组已升序,固定值之后的两个数只会更大,三数之和不可能回到零。这个剪枝依赖升序和目标为零。
目标不是零时怎么改?
把比较对象改成给定
target,并删除“固定值大于零就结束”的专用剪枝,或换成基于最小和、最大和的通用边界判断。为什么不能用三重循环?
三重循环是
O(n³),数据稍大就明显变慢,去重也更麻烦。排序加双指针把核心搜索降到O(n²)。业务不能修改原数组,你怎么保证?
排序前用展开运算符复制。直接调用
numbers.sort()会改变调用方持有的数组,是常见的隐藏副作用。
# 11 无重复字符的最长子串
⚡ 30 秒速记
- 用滑动窗口维护当前没有重复字符的区间
Map记录字符最近索引,重复时左边界跳到旧位置后一位- 左边界只能向右移动,必须用
Math.max防止被窗口外的旧记录拉回
这题不是遇到重复就把窗口清空,而是把左边界直接跳到冲突字符上次出现位置的后一位。 每个字符进入窗口一次,左边界也只向右移动,所以整体是线性时间。
# 题目与解题思路
返回字符串中不含重复字符的最长连续子串长度。窗口为 [left, right],lastSeen 保存每个字符最近一次出现的位置。
function lengthOfLongestSubstring(text) { // 接收待分析字符串
const lastSeen = new Map() // 保存每个字符最近出现的索引
let left = 0 // 初始化滑动窗口左边界
let best = 0 // 保存目前发现的最大长度
for (let right = 0; right < text.length; right += 1) { // 让右边界逐字符扩张
const char = text[right] // 读取新进入窗口的字符
if (lastSeen.has(char)) left = Math.max(left, lastSeen.get(char) + 1) // 重复时右移但绝不回退左边界
lastSeen.set(char, right) // 更新当前字符的最新位置
best = Math.max(best, right - left + 1) // 用当前窗口长度更新答案
} // 结束右边界扫描
return best // 返回最长无重复子串长度
} // 结束最长子串函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(k),k为窗口中不同字符数。 - 示例:
"abcabcbb"返回3,"bbbbb"返回1,空串返回0。 - 易错点:字符串索引按
UTF-16代码单元工作;若要把部分表情符号视为一个字符,应先用Array.from(text)转成码点序列。
💬 面试官追问
abba为什么容易算错成3?第二个
a的旧位置已经在当前窗口外,如果直接把left设为旧位置加一,就会让左边界回退。必须使用Math.max。要求返回子串本身而不是长度怎么改?
在更新最大长度时同时记录最佳窗口的起点和终点,最后切片返回。核心滑动窗口逻辑不变。
只包含小写英文字母,还需要
Map吗?可以用长度为
26的数组保存索引,常数更小;Map更通用,能直接支持更大的字符集。用户输入包含组合字符,肉眼一个字却被算成两个怎么办?
码点仍不等于用户感知字符,需要使用
Intl.Segmenter按字素簇切分。题目必须先明确“字符”的定义。
# 12 全排列
⚡ 30 秒速记
- 回溯维护“当前路径”和“哪些位置已经使用”
- 选择一个数后递归,返回时撤销选择,恢复给兄弟分支
- 路径长度等于数组长度时复制结果,不能直接保存同一个可变数组引用
全排列就是一棵选择树。 每层从尚未使用的元素中选一个放进路径,递归探索后再撤销;“做选择、递归、撤销选择”三个动作必须成对出现。
# 题目与解题思路
给定不含重复元素的数组,返回所有排列。used[i] 表示某个位置是否已进入当前路径,而不是该数值是否在所有分支中永久使用。
function permute(numbers) { // 接收不含重复值的数组
const result = [] // 保存所有完整排列
const path = [] // 保存当前递归路径
const used = Array(numbers.length).fill(false) // 标记当前路径已经使用的位置
function backtrack() { // 定义回溯搜索函数
if (path.length === numbers.length) { // 路径包含全部元素时得到一个答案
result.push([...path]) // 复制路径避免后续撤销修改已保存结果
return // 当前排列完成后返回上一层
} // 结束递归出口
for (let index = 0; index < numbers.length; index += 1) { // 尝试每个候选位置
if (used[index]) continue // 当前路径已使用的位置不能重复选择
used[index] = true // 标记当前位置已进入路径
path.push(numbers[index]) // 把当前数值加入路径
backtrack() // 递归填写下一个位置
path.pop() // 撤销刚才加入的数值
used[index] = false // 恢复位置供其他分支使用
} // 结束本层候选枚举
} // 结束回溯函数
backtrack() // 从空路径开始搜索
return result // 返回全部排列
} // 结束全排列函数
# 复杂度、示例与易错点
- 共有
n!个结果,生成和复制它们需要O(n × n!)时间与结果空间;递归辅助空间为O(n)。 - 示例:
[1, 2, 3]产生6个排列;空数组按组合数学约定产生一个空排列[[]]。 - 易错点:
result.push(path)会保存同一个数组引用,回溯结束后所有结果都可能变成空数组。
💬 面试官追问
输入包含重复值,怎么避免重复排列?
先排序,同一层枚举时若当前值等于前一个值且前一个位置尚未在路径中使用,就跳过当前值。去重判断针对同一树层,不是整条路径。
为什么撤销时既要
pop又要重置used?两者维护不同状态:
path决定已选顺序,used决定可选位置。只恢复一个会让搜索树状态不一致。只需要第
k个排列,还要生成全部吗?不需要,可以利用阶乘分组直接定位每一位,把复杂度降到大约
O(n²);这需要明确排列的字典序定义。数组长度为
12时能直接展示全部结果吗?不能,
12!已接近五亿,输出规模本身不可接受。应限制输入、按需生成或提供迭代器流式消费。
# 13 岛屿数量
⚡ 30 秒速记
- 遇到陆地就把答案加一,并用深度优先搜索淹没整座岛
- 每个网格只会从陆地改成水一次,因此总时间是
O(mn) - 原地标记节省访问集合,但会修改输入;不能修改时改用
visited
岛屿数量考的是网格上的连通分量。 每遇到一块尚未访问的陆地,就说明发现了新岛屿;随后沿四个方向把与它相连的陆地全部标记,避免重复计数。
# 题目与解题思路
二维网格中,"1" 表示陆地、"0" 表示水,只按上下左右连接。外层扫描负责发现新连通块,递归负责标记整块区域。
function countIslands(grid) { // 接收二维字符网格
if (grid.length === 0) return 0 // 空网格没有岛屿
const rows = grid.length // 记录网格行数
const columns = grid[0].length // 记录网格列数
let count = 0 // 保存已经发现的岛屿数量
function flood(row, column) { // 定义淹没一块连通陆地的函数
if (row < 0 || row >= rows || column < 0 || column >= columns) return // 越界时结束当前方向
if (grid[row][column] !== '1') return // 水域或已访问位置无需处理
grid[row][column] = '0' // 把当前陆地标记为已访问
flood(row - 1, column) // 继续搜索上方相邻位置
flood(row + 1, column) // 继续搜索下方相邻位置
flood(row, column - 1) // 继续搜索左侧相邻位置
flood(row, column + 1) // 继续搜索右侧相邻位置
} // 结束淹没函数
for (let row = 0; row < rows; row += 1) { // 逐行扫描网格
for (let column = 0; column < columns; column += 1) { // 逐列扫描当前行
if (grid[row][column] !== '1') continue // 非陆地位置直接跳过
count += 1 // 未访问陆地代表发现一座新岛
flood(row, column) // 标记这座岛的全部相连陆地
} // 结束当前行扫描
} // 结束整个网格扫描
return count // 返回连通分量数量
} // 结束岛屿计数函数
# 复杂度、示例与易错点
- 时间复杂度
O(mn);最坏递归栈为O(mn),原地标记不再额外创建访问矩阵。 - 示例:两块只在对角线接触的陆地按四方向规则应算两座岛。
- 易错点:这版会修改输入网格;超大连通区域还可能让递归爆栈,应改为显式栈或队列。
💬 面试官追问
如果对角线也算相连,怎么改?
在四个方向之外再搜索四个对角方向。连通规则改变后,同一份网格的答案也会改变,必须写进题目契约。
业务还要保留原网格,怎么办?
可以复制网格后再原地标记,或使用同尺寸的
visited数组。两种方式都会增加O(mn)空间。一百万格全是陆地,递归版有什么风险?
递归深度可能超过运行时调用栈限制。改用显式栈的深度优先,或队列实现广度优先,会更稳妥。
这题为什么不是动态规划?
每块陆地的归属依赖连通遍历,不存在由固定方向子问题推导当前最优值的状态转移。它本质上是图的连通分量计数。
# 14 爬楼梯
⚡ 30 秒速记
- 到第
n阶的最后一步只能来自第n - 1阶或第n - 2阶 - 状态转移是
dp[n] = dp[n - 1] + dp[n - 2] - 只依赖前两个状态,所以可以把数组压缩为两个变量
动态规划先找最后一步。 到当前台阶的方案按最后走一阶或两阶分成互斥两类,因此数量相加;状态只依赖前两项,没必要保存完整数组。
# 题目与解题思路
每次可以爬一阶或两阶,求到第 n 阶的不同方案数。把“到第几阶”作为状态,先明确 n = 1 和 n = 2 的初始值,再从小到大递推。
function climbStairs(stepCount) { // 接收目标台阶数
if (!Number.isInteger(stepCount) || stepCount < 0) throw new TypeError('台阶数必须是非负整数') // 校验输入契约
if (stepCount <= 1) return 1 // 零阶有一种不移动方案,一阶也只有一种方案
let previousTwo = 1 // 保存到第零阶的方案数
let previousOne = 1 // 保存到第一阶的方案数
for (let step = 2; step <= stepCount; step += 1) { // 从第二阶开始递推
const current = previousOne + previousTwo // 合并最后走一阶和两阶的方案
previousTwo = previousOne // 较旧状态向前滚动
previousOne = current // 保存当前阶方案供下一轮使用
} // 结束状态递推
return previousOne // 返回到目标台阶的方案数
} // 结束爬楼梯函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),额外空间复杂度O(1)。 - 示例:
n = 3时有1+1+1、1+2、2+1三种方案;本实现把n = 0定义为一种空方案。 - 易错点:题目对
n = 0的定义可能不同,面试前要先和面试官确认边界契约。
💬 面试官追问
为什么不是直接算
2^n?每一步并不能独立选择一阶或两阶,因为总步数必须恰好等于
n。合法序列受总和约束,数量满足斐波那契式递推。允许一次走一、二或三阶怎么改?
状态转移变成前三项之和,即
dp[n] = dp[n-1] + dp[n-2] + dp[n-3],并重新定义前三个边界值。n很大导致结果不安全怎么办?超过安全整数范围后应使用
BigInt,或者按题目要求取模。类型变化后调用方也必须接受BigInt结果。能用矩阵快速幂优化吗?
可以把时间降为
O(log n),适合极大的n;普通面试输入下滚动动态规划更直观,常数也更小。
# 15 零钱兑换
⚡ 30 秒速记
dp[amount]表示凑出该金额所需的最少硬币数- 对每个金额尝试所有硬币,从可达的前置状态转移
- 初始用“不可能的大值”填充,最后仍不可达就返回
-1
零钱兑换是完全背包的最短路式动态规划。 每个金额都从 amount - coin 转移而来,硬币可以重复使用;只从已可达状态加一,才能避免把无解状态误当答案。
# 题目与解题思路
给定不同面额硬币和目标金额,返回凑出目标所需的最少硬币数。把 amount + 1 当作哨兵,因为任何合法答案都不会超过使用 amount 枚面值一的硬币。
function coinChange(coins, amount) { // 接收硬币面额和目标金额
if (!Number.isInteger(amount) || amount < 0) return -1 // 非法目标金额直接判定无解
const dp = Array(amount + 1).fill(amount + 1) // 用不可能的大值初始化全部状态
dp[0] = 0 // 凑出零元不需要硬币
for (let current = 1; current <= amount; current += 1) { // 从小金额递推到目标金额
for (const coin of coins) { // 尝试把每种硬币作为最后一枚
if (coin <= 0 || coin > current) continue // 跳过非法面额和放不下的硬币
dp[current] = Math.min(dp[current], dp[current - coin] + 1) // 从前置金额转移最优解
} // 结束当前金额的硬币枚举
} // 结束所有金额状态递推
return dp[amount] > amount ? -1 : dp[amount] // 哨兵未被更新时返回无解
} // 结束零钱兑换函数
# 复杂度、示例与易错点
- 设硬币种数为
k,时间复杂度O(amount × k),空间复杂度O(amount)。 - 示例:硬币
[1, 2, 5]、金额11返回3,对应5 + 5 + 1;硬币[2]、金额3返回-1。 - 易错点:面额必须是正整数;零或负面额会破坏状态转移含义。
💬 面试官追问
为什么贪心每次选最大硬币不总是对?
面额
[1, 3, 4]、金额6时贪心得到4+1+1三枚,但最优是3+3两枚。只有特定规范币制才保证贪心正确。如果问的是组合数量而不是最少枚数呢?
状态含义要改为方案数,并把硬币放外层、金额正序遍历以避免把不同顺序重复计数。不能只改最终返回值。
目标金额特别大时这版有什么瓶颈?
数组长度和运行时间都随金额线性增长。可以先用所有面额的最大公约数判断必然无解,但一般没有通用办法绕过伪多项式复杂度。
为什么
dp[0]必须是零?它是所有恰好等于某枚硬币面额状态的转移起点。若不初始化,任何金额都无法从“已可达”状态产生。
# 16 最长递增子序列
⚡ 30 秒速记
tails[i]保存长度为i + 1的递增子序列可取得的最小结尾- 当前值大于所有结尾就扩展长度,否则二分替换第一个大于等于它的位置
tails不是最终子序列本身,但它的长度就是答案
最长递增子序列的优化关键是“同样长度时,结尾越小越有潜力”。 用 tails 维护各长度的最小结尾,再用二分查找替换位置,就能把朴素 O(n²) 动态规划降为 O(n log n)。
# 题目与解题思路
给定整数数组,返回严格递增子序列的最大长度。对每个值在 tails 中查找第一个大于等于它的位置并替换;相等时替换而不扩展,保证“严格递增”。
function lengthOfLIS(numbers) { // 接收整数数组
const tails = [] // 保存各长度递增子序列的最小结尾
for (const value of numbers) { // 依次处理每个数值
let left = 0 // 二分区间左边界从零开始
let right = tails.length // 二分区间右边界使用右开形式
while (left < right) { // 区间仍有候选位置时继续
const middle = left + Math.floor((right - left) / 2) // 计算中间索引并避免边界相加
if (tails[middle] < value) left = middle + 1 // 中间结尾偏小时去右半区
else right = middle // 中间结尾可被替换时保留当前位置
} // 结束替换位置查找
tails[left] = value // 更新该长度下能取得的最小结尾
} // 结束所有数值处理
return tails.length // 最小结尾数组长度就是最长递增长度
} // 结束最长递增子序列函数
# 复杂度、示例与易错点
- 时间复杂度
O(n log n),额外空间复杂度O(n)。 - 示例:
[10, 9, 2, 5, 3, 7, 101, 18]返回4,一种答案是[2, 3, 7, 18]。 - 易错点:
tails的内容不保证是原数组中的那条最终子序列;若要还原路径,需要额外保存前驱与位置。
💬 面试官追问
为什么替换较小结尾不会让答案变差?
对相同长度而言,更小的结尾只会给后续元素留下更多扩展机会,不会减少可选范围。我们保留的是潜力最好的代表状态。
要求非递减子序列怎么改?
二分目标从第一个“大于等于当前值”改成第一个“严格大于当前值”的位置,让相等值也能扩展长度。
tails为什么看起来有序?更长递增子序列的最小结尾必然大于更短序列的最小结尾,因此可以对它二分查找。这是优化成立的基础。
面试官只要求基础动态规划,你会直接写二分版吗?
我会先讲清
dp[i]表示以位置i结尾的最长长度及其O(n²)转移,再给出tails优化。这样推导完整,也避免只背模板。
# 17 二分查找
⚡ 30 秒速记
- 只适用于具有单调性的搜索空间
- 使用左闭右闭区间时,循环条件写成
left <= right - 比较后必须排除
middle,否则边界可能无法收缩
二分查找的重点是统一区间语义。 下面始终维护 [left, right],命中直接返回;目标较大就令 left = middle + 1,目标较小就令 right = middle - 1。
# 题目与解题思路
在升序数组中查找目标值并返回下标,不存在则返回 -1。每轮排除一半不可能的区间,空数组会自然跳过循环。
function binarySearch(numbers, target) { // 接收升序数组和目标值
let left = 0 // 初始化左闭边界
let right = numbers.length - 1 // 初始化右闭边界
while (left <= right) { // 闭区间非空时继续查找
const middle = left + Math.floor((right - left) / 2) // 计算中点并避免直接相加
if (numbers[middle] === target) return middle // 命中目标后立即返回下标
if (numbers[middle] < target) left = middle + 1 // 目标只可能位于右半区
else right = middle - 1 // 目标只可能位于左半区
} // 结束二分循环
return -1 // 搜索区间耗尽时返回未找到
} // 结束二分查找函数
# 复杂度、示例与易错点
- 时间复杂度
O(log n),空间复杂度O(1)。 - 示例:
binarySearch([1, 3, 5, 8], 5)返回2。 - 易错点:数组必须按比较规则有序;闭区间和左闭右开模板不能混写。
💬 面试官追问
- 存在重复值时怎样找第一个位置? 命中后先记录答案,再令
right = middle - 1继续向左收缩。 - 为什么不直接写
(left + right) / 2? 需要取整,而且在定长整数语言里直接相加可能溢出;差值写法更通用。 - 链表能否用二分查找? 缺少
O(1)随机访问,中点定位本身昂贵,通常不能获得数组上的收益。 - 何时对答案范围二分? 当不能直接枚举答案,但“某个答案是否可行”具有单调性时使用。
# 18 搜索旋转排序数组
⚡ 30 秒速记
- 每一轮至少有一半区间仍然有序
- 先判断哪半边有序,再判断目标是否落在该范围
- 无重复元素时可稳定排除另一半
旋转数组不是失去有序性,而是被分成两段有序区间。 比较 left、middle、right,找出有序的一半,再按目标范围决定保留哪边。
# 题目与解题思路
给定由严格升序数组旋转得到的无重复数组,返回目标下标。若左端不大于中点,左半段有序;否则右半段有序。
function searchRotated(numbers, target) { // 接收旋转数组和目标值
let left = 0 // 初始化搜索左边界
let right = numbers.length - 1 // 初始化搜索右边界
while (left <= right) { // 搜索区间仍存在时继续
const middle = left + Math.floor((right - left) / 2) // 取得当前中点
if (numbers[middle] === target) return middle // 中点命中时返回
if (numbers[left] <= numbers[middle]) { // 判断左半段是否有序
if (numbers[left] <= target && target < numbers[middle]) right = middle - 1 // 目标位于左侧有序范围
else left = middle + 1 // 否则排除左半段
} else if (numbers[middle] < target && target <= numbers[right]) left = middle + 1 // 目标位于右侧有序范围
else right = middle - 1 // 否则排除右半段
} // 结束二分搜索
return -1 // 没有找到目标
} // 结束旋转数组搜索函数
# 复杂度、示例与易错点
- 时间复杂度
O(log n),空间复杂度O(1)。 - 示例:
searchRotated([4,5,6,7,0,1,2], 0)返回4。 - 易错点:范围判断一端包含等号、另一端不包含,避免重复保留中点。
💬 面试官追问
- 数组存在大量重复值怎么办? 三个边界值相等时无法判断有序侧,只能同时缩边,最坏退化到
O(n)。 - 怎样找旋转数组最小值? 比较中点与右端;中点较大说明最小值在右侧,否则保留中点及其左侧。
- 为什么每轮一定有一侧有序? 旋转点最多落在当前区间的一侧,另一侧仍保持原升序关系。
- 空数组返回什么? 循环不会进入,按契约返回
-1。
# 19 实现一个最小栈
⚡ 30 秒速记
- 普通栈保存数据,辅助栈同步保存当前位置的最小值
- 压栈时把当前值与旧最小值比较后一起压入
- 弹栈时两个栈同步弹出,所有操作都是
O(1)
最小栈用空间换查询时间。 辅助栈的栈顶始终对应数据栈当前状态的最小值,重复最小值也要重复记录,弹出时才不会丢失状态。
# 题目与解题思路
实现 push、pop、top 和 getMin。空栈读取统一返回 undefined,避免接口行为不一致。
class MinStack { // 定义支持最小值查询的栈
constructor() { // 初始化两个内部栈
this.values = [] // 保存真实入栈数据
this.minimums = [] // 保存每一层对应的最小值
} // 结束构造函数
push(value) { // 压入一个新值
const previous = this.getMin() // 读取压栈前的最小值
this.values.push(value) // 把数据压入普通栈
this.minimums.push(previous === undefined ? value : Math.min(previous, value)) // 保存新状态最小值
} // 结束压栈方法
pop() { // 弹出栈顶元素
if (!this.values.length) return undefined // 空栈不执行弹出
this.minimums.pop() // 同步移除最小值状态
return this.values.pop() // 返回真实栈顶值
} // 结束弹栈方法
top() { return this.values.at(-1) } // 返回栈顶但不修改栈
getMin() { return this.minimums.at(-1) } // 常数时间返回当前最小值
} // 结束最小栈类
# 复杂度、示例与易错点
- 四个操作时间复杂度均为
O(1),总体空间复杂度O(n)。 - 示例:依次压入
-2、0、-3,getMin()返回-3;弹出后返回-2。 - 易错点:新值等于当前最小值时也必须记录,否则弹出一个重复最小值后状态会出错。
💬 面试官追问
- 能只记录更小的值吗? 可以,但相等时也要压入,且弹栈要比较同步;当前逐层记录更不易错。
- 如何同时支持最大值? 再维护一个逐层最大值栈,更新规则完全对称。
- 为什么不用每次遍历求最小值? 那会把
getMin变成O(n),不满足题目常数时间要求。 - 生产代码要不要抛空栈异常? 取决于接口契约;关键是四个方法的空值语义统一且有测试。
# 20 用两个栈实现队列
⚡ 30 秒速记
- 输入栈负责接收新元素,输出栈负责从队头弹出
- 输出栈为空时,才把输入栈全部倒过去
- 每个元素最多进入、移出两个栈各一次,均摊复杂度为
O(1)
两个栈通过一次反转恢复先进先出顺序。 延迟到真正出队时再搬运,并且只有输出栈空才搬,避免每次操作都来回倒数据。
# 题目与解题思路
实现队列的 enqueue、dequeue、peek 和 isEmpty。抽出私有搬运方法,保证读取与删除共用同一套逻辑。
class QueueByStacks { // 定义由两个栈组成的队列
constructor() { // 初始化输入栈和输出栈
this.input = [] // 保存新加入的元素
this.output = [] // 保存已经反转顺序的元素
} // 结束构造函数
enqueue(value) { this.input.push(value) } // 把新元素压入输入栈
moveIfNeeded() { // 在需要时搬运元素
if (this.output.length) return // 输出栈非空时保留现有顺序
while (this.input.length) this.output.push(this.input.pop()) // 把输入栈全部反转到输出栈
} // 结束搬运方法
dequeue() { // 删除并返回队头
this.moveIfNeeded() // 确保输出栈准备好队头
return this.output.pop() // 输出栈顶就是最早入队元素
} // 结束出队方法
peek() { // 读取但不删除队头
this.moveIfNeeded() // 确保队头可读
return this.output.at(-1) // 返回输出栈顶
} // 结束读取方法
isEmpty() { return this.input.length + this.output.length === 0 } // 判断两个栈是否都为空
} // 结束队列类
# 复杂度、示例与易错点
- 入队
O(1),出队和读取队头均摊O(1),空间复杂度O(n)。 - 示例:依次入队
1、2,两次出队依次得到1、2。 - 易错点:输出栈不为空时不能继续搬运,否则新元素会跑到旧元素前面。
💬 面试官追问
- 单次出队最坏复杂度是多少? 触发搬运时是
O(n),但一串操作的均摊成本是O(1)。 - 为什么不每次入队都倒栈? 会产生大量重复搬运,使连续入队代价达到平方级。
- 如何实现固定容量? 入队前检查两个栈元素总数,达到容量则拒绝或覆盖,需先定义契约。
- 两个队列能实现栈吗? 可以,每次压栈后轮转旧元素,或在弹栈时搬运到只剩最后一个。
# 21 每日温度
⚡ 30 秒速记
- 栈中保存还没找到更高温度的下标
- 当前温度更高时,连续弹出较低温度并计算下标差
- 栈内对应温度保持单调不增,因此每个下标只进出一次
这是一道典型单调栈题。 当新值能回答栈顶旧位置的问题时就弹栈;没有更高温度的位置最终保留默认答案 0。
# 题目与解题思路
对每天温度返回还需等待多少天才会遇到更高温度。答案依赖位置距离,所以栈中存下标而不是温度值。
function dailyTemperatures(temperatures) { // 接收每日温度数组
const answer = Array(temperatures.length).fill(0) // 默认后续没有更高温度
const stack = [] // 保存尚未得到答案的下标
for (let index = 0; index < temperatures.length; index += 1) { // 从左到右扫描温度
while (stack.length && temperatures[index] > temperatures[stack.at(-1)]) { // 当前值能解决栈顶问题
const previous = stack.pop() // 取出等待更高温度的位置
answer[previous] = index - previous // 用下标差记录等待天数
} // 继续解决所有更低的栈顶温度
stack.push(index) // 当前下标等待未来更高温度
} // 结束温度扫描
return answer // 返回每一天的等待天数
} // 结束每日温度函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(n)。 - 示例:
[73,74,75,71,69,72,76,73]返回[1,1,4,2,1,1,0,0]。 - 易错点:题目要求“严格更高”,相等温度不能弹栈。
💬 面试官追问
- 为什么不是
O(n²)? 虽然有嵌套循环,但每个下标最多压栈和弹栈各一次。 - 求下一个更大元素能复用吗? 可以,把答案从距离改为对应的值或下标即可。
- 求前一个更高温度怎么做? 从左向右时先读取满足条件的栈顶,再维护相反方向的单调性。
- 流式输入能否处理? 可以逐个接收并输出刚被解决的位置,但未解决项必须保留到流结束。
# 22 前 K 个高频元素
⚡ 30 秒速记
- 先用
Map统计频次 - 用桶下标表示出现次数,同一频次的元素放在同一个桶
- 从最高频桶向下收集,拿满
k个立即结束
桶排序利用了频次不会超过数组长度这一上界。 它避免对所有不同元素完整排序,在整数频次场景中可以做到线性时间。
# 题目与解题思路
返回数组中出现频率最高的 k 个元素。若 k 超过不同元素数,返回全部不同元素;同频元素的顺序不作保证。
function topKFrequent(numbers, k) { // 接收数字数组和目标数量
if (k <= 0) return [] // 非正数量没有结果
const counts = new Map() // 建立元素到频次的映射
for (const value of numbers) counts.set(value, (counts.get(value) || 0) + 1) // 一次遍历完成计数
const buckets = Array.from({ length: numbers.length + 1 }, () => []) // 以频次作为桶下标
for (const [value, count] of counts) buckets[count].push(value) // 把元素放进对应频次桶
const result = [] // 保存高频结果
for (let count = buckets.length - 1; count > 0; count -= 1) { // 从最高频率向下扫描
for (const value of buckets[count]) { // 读取当前频次的所有元素
result.push(value) // 把高频元素加入结果
if (result.length === Math.min(k, counts.size)) return result // 数量足够时立即返回
} // 结束当前频次桶处理
} // 结束全部桶扫描
return result // 空输入时返回空结果
} // 结束高频元素函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(n)。 - 示例:
topKFrequent([1,1,1,2,2,3], 2)返回包含1、2的数组。 - 易错点:同频时题目若要求稳定顺序,需要额外定义并实现排序规则。
💬 面试官追问
- 数据种类很多但
k很小怎么办? 可维护大小为k的最小堆,把空间压到O(m + k),其中m是不同元素数。 - 为何桶数组长度是
n + 1? 单个元素最高可能出现n次,需要能访问下标n。 - 字符串也能用吗? 可以,
Map的键换成字符串,频次和桶逻辑不变。 - 持续到来的数据流怎么处理? 维护频次表并配合可更新堆;每次重新建桶不适合高频实时查询。
# 23 实现 LRU 缓存
⚡ 30 秒速记
Map保存键到值,并利用其迭代顺序表示新旧- 读取命中后删除再插入,把键移动到最新位置
- 超容量时删除
Map.keys().next().value指向的最旧键
JavaScript 的 Map 已维护插入顺序,可用于简洁实现 LRU。 get 和 put 都要刷新最近使用顺序,容量超限时淘汰最早的键。
# 题目与解题思路
实现固定容量的最近最少使用缓存。这里使用 Map 的有序特性;若面试要求不依赖语言容器内部顺序,应改为哈希表加双向链表。
class LRUCache { // 定义最近最少使用缓存
constructor(capacity) { // 接收最大容量
if (!Number.isInteger(capacity) || capacity <= 0) throw new TypeError('容量必须是正整数') // 校验容量
this.capacity = capacity // 保存容量上限
this.cache = new Map() // 用插入顺序记录使用新旧
} // 结束构造函数
get(key) { // 读取指定键
if (!this.cache.has(key)) return -1 // 未命中时返回约定值
const value = this.cache.get(key) // 保存命中的值
this.cache.delete(key) // 删除旧位置
this.cache.set(key, value) // 重新插入到最新位置
return value // 返回缓存值
} // 结束读取方法
put(key, value) { // 写入或更新键值
if (this.cache.has(key)) this.cache.delete(key) // 更新前移除旧位置
this.cache.set(key, value) // 把键写到最新位置
if (this.cache.size <= this.capacity) return // 未超容量时结束
const oldestKey = this.cache.keys().next().value // 取得最早插入的键
this.cache.delete(oldestKey) // 淘汰最久未使用项
} // 结束写入方法
} // 结束缓存类
# 复杂度、示例与易错点
- 平均
get、put都是O(1),空间复杂度O(capacity)。 - 示例:容量
2,写入1、2,读取1后再写入3,应淘汰键2。 - 易错点:更新已有键同样算最近使用,必须刷新顺序。
💬 面试官追问
- 标准答案为什么常用双向链表? 它不依赖
Map的顺序语义,并能用节点O(1)移动与删除。 - 为何链表必须双向? 淘汰或刷新任意节点时需要同时连接它的前驱和后继。
- LRU 与 LFU 有何不同? LRU 看最近使用时间,LFU 优先淘汰访问次数最低项,还要处理同频次的新旧顺序。
- 缓存值可以是
undefined吗? 可以,因此判断命中必须用has,不能只检查get的返回值。
# 24 实现 Trie 前缀树
⚡ 30 秒速记
- 每个节点保存“字符到子节点”的映射
- 单词结尾要单独标记,不能只看节点是否存在
- 插入、完整查询和前缀查询都沿字符逐层移动
Trie 把公共前缀共享成树路径。 search 要求最后节点带结束标记,startsWith 只要求整段前缀路径存在。
# 题目与解题思路
实现单词插入、完整单词查询和前缀查询。节点使用 Map,因此不局限于 26 个小写英文字母。
class TrieNode { // 定义前缀树节点
constructor() { // 初始化节点状态
this.children = new Map() // 保存字符到子节点的映射
this.isWord = false // 标记是否在此结束一个完整单词
} // 结束节点构造函数
} // 结束节点类
class Trie { // 定义前缀树
constructor() { this.root = new TrieNode() } // 创建不存字符的根节点
insert(word) { // 插入一个单词
let node = this.root // 从根节点开始
for (const character of word) { // 逐字符扩展路径
if (!node.children.has(character)) node.children.set(character, new TrieNode()) // 缺少分支时创建节点
node = node.children.get(character) // 移动到当前字符节点
} // 结束字符遍历
node.isWord = true // 标记完整单词终点
} // 结束插入方法
findNode(text) { // 查找一段文本对应的末端节点
let node = this.root // 从根节点开始查找
for (const character of text) { // 逐字符验证路径
if (!node.children.has(character)) return null // 任一字符缺失就判定不存在
node = node.children.get(character) // 移动到下一层节点
} // 结束路径查找
return node // 返回文本末端节点
} // 结束节点查找方法
search(word) { return this.findNode(word)?.isWord === true } // 判断完整单词是否存在
startsWith(prefix) { return this.findNode(prefix) !== null } // 判断前缀路径是否存在
} // 结束前缀树类
# 复杂度、示例与易错点
- 每次操作时间复杂度
O(L),L为字符串长度;空间取决于所有不同前缀节点数。 - 示例:插入
apple后,查询app为假,但前缀查询app为真。 - 易错点:空字符串是否算单词取决于是否允许插入它,本实现允许并在根节点标记。
💬 面试官追问
- 如何删除单词? 先取消终点标记,再从尾部清理没有子节点且不是其他单词终点的节点。
- 固定小写字母为何可用数组? 长度 26 的数组索引更快,但空间更固定且不支持更广字符集。
- 如何做自动补全? 找到前缀节点后 DFS 收集所有带
isWord标记的后代路径。 - Unicode 有什么注意点?
for...of按码点迭代,但用户感知字符可能是字素簇,产品需先定义单位。
# 25 找到链表的中间节点
⚡ 30 秒速记
- 快指针每次走两步,慢指针每次走一步
- 快指针到尾部时,慢指针正好位于中间
- 偶数长度按题意返回第二个中间节点
快慢指针用速度差代替长度统计。 当快指针走完 n 个节点时,慢指针约走 n / 2,无需预先遍历求长度。
# 题目与解题思路
返回单向链表中间节点;有两个中间节点时返回第二个。循环条件要同时保证快指针和它的后继存在。
function middleNode(head) { // 接收链表头节点
let slow = head // 慢指针从头节点出发
let fast = head // 快指针从头节点出发
while (fast && fast.next) { // 快指针还能安全走两步时继续
slow = slow.next // 慢指针前进一步
fast = fast.next.next // 快指针前进两步
} // 结束快慢指针移动
return slow // 返回中间节点或空值
} // 结束中间节点函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
1→2→3→4→5→6返回值为4的节点。 - 易错点:循环写成只判断
fast会在访问fast.next.next时出错。
💬 面试官追问
- 如何返回第一个中间节点? 调整快指针初始位置或循环条件,使偶数长度时慢指针少走一步。
- 这套思路还能做什么? 可用于判断环、找入环点和寻找倒数第
k个节点。 - 链表有环时会怎样? 循环不会正常结束,应先确认无环或先做环检测。
- 为什么不先求长度? 两次遍历也能做,但快慢指针一次遍历且不依赖额外计数。
# 26 删除链表倒数第 N 个节点
⚡ 30 秒速记
- 使用哑节点统一删除头节点与普通节点
- 快指针先走
n + 1步,保持与慢指针固定间隔 - 快指针到尾部时,慢指针正好停在待删节点的前驱
双指针把倒数位置转换成固定距离。 哑节点让所有删除操作都变成修改前驱的 next,无需为头节点单独分支。
# 题目与解题思路
删除单向链表倒数第 n 个节点并返回新头节点。这里对非法 n 抛出异常,避免静默修改错误节点。
function removeNthFromEnd(head, n) { // 接收链表头和倒数位置
if (!Number.isInteger(n) || n <= 0) throw new RangeError('n 必须是正整数') // 校验位置参数
const dummy = { next: head } // 创建指向原头节点的哑节点
let fast = dummy // 快指针从哑节点出发
let slow = dummy // 慢指针从哑节点出发
for (let step = 0; step <= n; step += 1) { // 建立 n 加一的节点间隔
if (!fast) throw new RangeError('n 超出链表长度') // 长度不足时拒绝操作
fast = fast.next // 快指针前进一步
} // 结束间隔建立
while (fast) { // 快指针未到空节点时同步移动
fast = fast.next // 快指针继续前进
slow = slow.next // 慢指针保持固定间隔
} // 结束同步移动
slow.next = slow.next.next // 跳过待删除节点
return dummy.next // 返回可能变化的新头节点
} // 结束删除函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
1→2→3→4→5删除倒数第2个后得到1→2→3→5。 - 易错点:间隔是
n + 1个节点位置,因为慢指针必须停在待删节点前驱。
💬 面试官追问
- 删除头节点为什么无需特判? 慢指针可以停在哑节点,再统一执行
slow.next = slow.next.next。 - 只先走
n步可以吗? 可以,但同步循环和慢指针落点要相应调整,模板不能混用。 - 若
n超出长度怎么办? 工程代码应按契约抛错或原样返回,不能访问空指针。 - 能否保留被删除节点? 在改指针前保存
slow.next,必要时再断开它的next。
# 27 判断对称二叉树
⚡ 30 秒速记
- 对称比较的是左子树的左侧与右子树的右侧
- 两个空节点对称,只有一个为空则不对称
- 节点值相等后继续交叉比较两对子树
镜像判断必须成对递归。 单独遍历左右子树不够,比较方向应当是外侧对外侧、内侧对内侧。
# 题目与解题思路
判断一棵二叉树是否关于根节点轴对称。空树按通常定义视为对称。
function isSymmetric(root) { // 接收二叉树根节点
function mirror(left, right) { // 成对判断两个节点是否镜像
if (!left && !right) return true // 两侧同时为空时对称
if (!left || !right) return false // 只有一侧为空时不对称
if (left.value !== right.value) return false // 节点值不同直接失败
return mirror(left.left, right.right) && mirror(left.right, right.left) // 交叉比较外侧和内侧子树
} // 结束镜像判断函数
return !root || mirror(root.left, root.right) // 空树对称,否则比较根的两棵子树
} // 结束对称树函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间最坏O(n)。 - 示例:根为
1,左右子树分别为2,3,4与2,4,3时返回真。 - 易错点:不能比较
left.left与right.left,那检查的是同向结构而不是镜像。
💬 面试官追问
- 如何用迭代实现? 队列中每次成对放入需要镜像比较的节点,按同样规则验证并继续入队。
- 空树为什么返回真? 它不存在破坏对称性的节点,符合递归基线和常见数学定义。
- 如何判断两棵树完全相同? 比较方向改成左对左、右对右,其余空值和值判断相同。
- 递归有什么风险? 极深偏斜树可能超过调用栈,工程上可换显式队列。
# 28 二叉树最大深度
⚡ 30 秒速记
- 空节点深度为
0 - 非空节点深度等于左右子树较大深度加一
- 后序递归先得到孩子答案,再合成父节点答案
树深度是最直接的后序动态规划。 每个节点只依赖两个子问题,基线和转移式写清楚后代码很短。
# 题目与解题思路
返回从根节点到最远叶子节点所经过的节点数。递归分别计算左右深度,取较大值再加当前节点。
function maxDepth(root) { // 接收二叉树根节点
if (!root) return 0 // 空树没有节点所以深度为零
const leftDepth = maxDepth(root.left) // 递归计算左子树深度
const rightDepth = maxDepth(root.right) // 递归计算右子树深度
return Math.max(leftDepth, rightDepth) + 1 // 取较深子树并计入当前节点
} // 结束最大深度函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间为O(h)。 - 示例:只有根节点时返回
1,空树返回0。 - 易错点:题目若把深度定义为边数,单节点答案会变成
0,需要先确认口径。
💬 面试官追问
- 如何用 BFS 求深度? 逐层处理队列,每完成一层把深度加一。
- 最大深度和高度有区别吗? 术语可能以根或节点为参照,面试时应明确这里按节点数计算。
- 何时迭代更安全? 树可能极深且运行环境调用栈有限时,显式栈或队列更稳妥。
- 如何求最小深度? 必须找到最近叶子;只有一侧子树时不能简单取左右最小值。
# 29 验证二叉搜索树
⚡ 30 秒速记
- 不能只比较父节点与直接孩子,约束来自整条祖先路径
- 递归时把合法下界和上界一起向下传递
- 搜索树要求严格递增,因此等于边界也不合法
验证 BST 的本质是维护每个节点的取值区间。 进入左子树时收紧上界,进入右子树时收紧下界,任一节点越界就返回假。
# 题目与解题思路
判断二叉树是否满足左子树所有值小于根、右子树所有值大于根,且每棵子树也满足同样规则。
function isValidBST(root) { // 接收二叉树根节点
function validate(node, lower, upper) { // 校验节点是否落在祖先限定区间
if (!node) return true // 空子树天然满足约束
if (node.value <= lower || node.value >= upper) return false // 等于或越过边界均不合法
return validate(node.left, lower, node.value) && validate(node.right, node.value, upper) // 分别收紧左右子树边界
} // 结束递归校验函数
return validate(root, -Infinity, Infinity) // 根节点从无限区间开始校验
} // 结束搜索树验证函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间O(h)。 - 示例:
[5,1,4,null,null,3,6]不是 BST,因为值3落在根5的右子树。 - 易错点:只检查
node.left.value < node.value会漏掉跨层越界。
💬 面试官追问
- 允许重复值怎么办? 必须先约定重复值统一放左侧还是右侧,再调整一边的等号规则。
- 中序遍历为何也能判断? 合法 BST 的中序序列严格递增,可与前一个访问值比较。
- 值可能是
Infinity怎么办? 用是否存在边界的标记或null,不要把数值哨兵与真实输入混淆。 - 如何定位第一个非法节点? 返回包含布尔值、节点和边界的结果对象,而不是只返回真假。
# 30 计算二叉树直径
⚡ 30 秒速记
- 直径可能经过根,也可能完全位于某棵子树
- 后序递归返回当前节点向下的最大深度
- 每个节点用左右深度之和更新全局最大边数
直径题要区分“递归返回值”和“全局答案”。 父节点只需要一条向下路径,但当前节点可以把左右两条路径拼成候选直径。
# 题目与解题思路
返回二叉树任意两节点之间最长路径的边数。深度函数以节点数返回,左右深度相加恰好是经过当前节点的边数。
function diameterOfBinaryTree(root) { // 接收二叉树根节点
let diameter = 0 // 保存目前发现的最大直径
function depth(node) { // 计算节点向下的最大深度
if (!node) return 0 // 空节点向下深度为零
const left = depth(node.left) // 获取左子树深度
const right = depth(node.right) // 获取右子树深度
diameter = Math.max(diameter, left + right) // 用左右路径拼接候选直径
return Math.max(left, right) + 1 // 向父节点只返回较长的单侧路径
} // 结束深度函数
depth(root) // 遍历整棵树并更新答案
return diameter // 返回最大边数
} // 结束直径计算函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),递归栈空间O(h)。 - 示例:
1的左右为2、3,2的左右为4、5,直径为3条边。 - 易错点:直径不一定经过整棵树的根节点,不能只计算根的左右深度。
💬 面试官追问
- 若答案要求节点数怎么改? 非空树的节点数等于边数加一,空树边界需单独定义。
- 为什么返回值不是左右深度之和? 父节点只能选择一条向下路径,不能把分叉结构继续向上传递。
- 如何返回具体路径? 需保存每个节点的最佳向下路径或前驱,并在更新直径时记录两端。
- 能一次遍历完成吗? 当前后序递归就是一次遍历,每个节点只处理一次。
# 31 求数组的所有子集
⚡ 30 秒速记
- 每个元素只有“选”与“不选”两种决策
- 回溯函数用
start保证只向后选择,避免排列式重复 - 每到一个状态都要把当前路径复制进答案
子集题的每个搜索节点本身都是答案。 先记录路径,再从 start 开始尝试加入后续元素,回退时撤销最后一次选择。
# 题目与解题思路
给定互不相同的数组,返回所有子集。空集也必须包含在结果里,因此进入回溯函数时先记录路径。
function subsets(numbers) { // 接收不含重复值的数组
const result = [] // 保存全部子集
const path = [] // 保存当前选择路径
function backtrack(start) { // 从指定位置继续选择
result.push([...path]) // 复制当前路径作为一个子集
for (let index = start; index < numbers.length; index += 1) { // 枚举下一项
path.push(numbers[index]) // 做出选择
backtrack(index + 1) // 只从后续位置继续搜索
path.pop() // 撤销选择恢复现场
} // 结束候选枚举
} // 结束回溯函数
backtrack(0) // 从空路径开始搜索
return result // 返回所有子集
} // 结束子集函数
# 复杂度、示例与易错点
- 有
2^n个结果,时间和结果空间复杂度均至少为O(n × 2^n)。 - 示例:
[1,2]得到[]、[1]、[1,2]、[2]。 - 易错点:必须复制
path,直接保存同一数组引用会让最终结果全部相同。
💬 面试官追问
- 输入有重复值怎么办? 先排序,同一层遇到与前一项相同的值时跳过。
- 为什么不是到叶子才收集? 子集长度可以是任意值,每个中间状态都代表一个合法子集。
- 能用位掩码吗? 可以用
0到2^n - 1的每一位表示是否选择对应元素。 - 如何只求长度为
k的组合? 仅在路径长度为k时收集,并按剩余数量剪枝。
# 32 生成有效括号
⚡ 30 秒速记
- 左括号使用数不能超过
n - 任意前缀中右括号数不能超过左括号数
- 长度达到
2n时得到一个完整答案
括号生成不是生成后校验,而是在构造过程中剪掉非法前缀。 只要右括号数量不超过已使用左括号数量,当前前缀就仍可能完成。
# 题目与解题思路
给定括号对数 n,返回所有合法组合。搜索状态只需记录当前字符串和左右括号已使用数量。
function generateParenthesis(n) { // 接收括号对数
if (!Number.isInteger(n) || n < 0) return [] // 非法数量返回空结果
const result = [] // 保存所有合法组合
function backtrack(path, leftUsed, rightUsed) { // 构造一个合法前缀
if (path.length === n * 2) { // 长度满足时得到完整组合
result.push(path) // 保存不可变字符串结果
return // 结束当前分支
} // 结束完整结果判断
if (leftUsed < n) backtrack(`${path}(`, leftUsed + 1, rightUsed) // 左括号仍有余额时可以加入
if (rightUsed < leftUsed) backtrack(`${path})`, leftUsed, rightUsed + 1) // 有未闭合左括号时才能加入右括号
} // 结束回溯函数
backtrack('', 0, 0) // 从空字符串开始构造
return result // 返回全部合法括号
} // 结束括号生成函数
# 复杂度、示例与易错点
- 结果数量为卡特兰数,时间复杂度与输出规模成正比,递归深度
O(n)。 - 示例:
n = 2返回['(())', '()()']。 - 易错点:右括号条件是
rightUsed < leftUsed,而不是只检查rightUsed < n。
💬 面试官追问
n = 0返回什么? 本实现返回包含空字符串的数组,表示唯一的空组合。- 为何不先排列
n个左右括号? 会产生大量非法和重复候选,再校验浪费搜索空间。 - 怎样只计算数量? 使用卡特兰数公式或二维动态规划,无需生成全部字符串。
- 如何改成三种括号? 状态需额外保存未闭合括号栈,闭合时必须匹配栈顶类型。
# 33 组合总和
⚡ 30 秒速记
- 候选数可重复使用,所以递归仍从当前下标开始
- 先排序后,当候选值大于剩余目标即可停止本层枚举
- 路径和恰好等于目标时复制结果
组合总和用 start 去重、用 remaining 控制终点。 同一数字可以重复选择,但不同顺序不应被当作不同组合。
# 题目与解题思路
给定互不相同的正整数候选数组和目标值,返回所有和为目标的组合。排序用于剪枝,不改变组合语义。
function combinationSum(candidates, target) { // 接收候选数和目标和
const numbers = [...candidates].sort((a, b) => a - b) // 复制并升序排列便于剪枝
const result = [] // 保存合法组合
const path = [] // 保存当前组合
function backtrack(start, remaining) { // 从指定位置凑剩余目标
if (remaining === 0) { // 恰好凑满目标
result.push([...path]) // 复制当前组合
return // 结束成功分支
} // 结束命中判断
for (let index = start; index < numbers.length; index += 1) { // 枚举不早于 start 的候选数
const value = numbers[index] // 读取当前候选值
if (value <= 0) throw new TypeError('候选数必须为正整数') // 防止无限重复选择零或负数
if (value > remaining) break // 后续值更大时停止本层搜索
path.push(value) // 选择当前候选数
backtrack(index, remaining - value) // 允许继续使用同一候选数
path.pop() // 撤销当前选择
} // 结束候选枚举
} // 结束回溯函数
backtrack(0, target) // 从全部候选数开始搜索
return result // 返回所有合法组合
} // 结束组合总和函数
# 复杂度、示例与易错点
- 复杂度与候选分支和目标值有关,最坏为指数级;递归深度最多约
target / min。 - 示例:候选
[2,3,6,7]、目标7得到[2,2,3]和[7]。 - 易错点:候选数必须为正数,否则“剩余目标递减”这一终止条件不成立。
💬 面试官追问
- 每个数字只能用一次怎么改? 递归传
index + 1,若输入有重复值还要做同层去重。 - 为什么组合不会出现不同顺序重复?
start保证后续只能选择当前或更右边的元素。 - 如何只求组合数量? 可用完全背包动态规划,避免保存每条路径。
- 排序会修改调用方数组吗? 当前先复制再排序,不会产生外部副作用。
# 34 单词搜索
⚡ 30 秒速记
- 从每个网格位置尝试作为单词起点
- 当前字符匹配后向四个方向 DFS
- 访问过的位置临时标记,回溯时恢复
单词搜索是带现场恢复的网格回溯。 一条路径不能重复使用同一格,但失败分支退出后该格仍可供其他路径使用。
# 题目与解题思路
判断字符网格中是否存在一条上下左右相邻、且不重复使用格子的路径组成目标单词。空单词按本实现返回真。
function exist(board, word) { // 接收字符网格和目标单词
if (word.length === 0) return true // 空单词不需要占用格子
const rows = board.length // 保存网格行数
const columns = board[0]?.length || 0 // 安全读取列数
function search(row, column, index) { // 从指定格匹配单词当前位置
if (index === word.length) return true // 所有字符都已匹配
if (row < 0 || row >= rows || column < 0 || column >= columns) return false // 越界分支失败
if (board[row][column] !== word[index]) return false // 当前字符不匹配时失败
const original = board[row][column] // 保存当前字符以便恢复
board[row][column] = null // 临时标记当前路径已经使用此格
const found = search(row + 1, column, index + 1) || search(row - 1, column, index + 1) || search(row, column + 1, index + 1) || search(row, column - 1, index + 1) // 搜索四个相邻方向
board[row][column] = original // 回溯时恢复网格内容
return found // 返回当前起点能否完成匹配
} // 结束路径搜索函数
for (let row = 0; row < rows; row += 1) { // 枚举每一行
for (let column = 0; column < columns; column += 1) { // 枚举每一列
if (search(row, column, 0)) return true // 任一起点成功即可结束
} // 结束列枚举
} // 结束行枚举
return false // 所有起点都失败时返回假
} // 结束单词搜索函数
# 复杂度、示例与易错点
- 最坏时间复杂度约
O(rows × columns × 3^L),递归空间O(L)。 - 示例:网格
[['A','B'],['C','D']]中存在单词ABD。 - 易错点:成功或失败返回前都必须恢复现场,否则会污染后续起点。
💬 面试官追问
- 为什么后续分支近似三个方向? 除第一步外,刚走过的格子已被标记,通常不能立刻原路返回。
- 能用额外 visited 数组吗? 可以,更清晰但额外占用
O(rows × columns)空间。 - 怎样先做快速剪枝? 比较网格与单词字符频次,缺少任何字符就直接返回假。
- 多个单词同时搜索怎么办? 把单词建成 Trie,在一次 DFS 中共享前缀搜索。
# 35 最大子数组和
⚡ 30 秒速记
current表示必须以当前位置结尾的最大连续和- 若之前的和小于零,就从当前元素重新开始
- 全局答案在遍历过程中持续更新
Kadane 算法只保留对未来有贡献的前缀。 负的累计和只会拖累后续子数组,因此可直接舍弃。
# 题目与解题思路
返回非空整数数组中连续子数组的最大和。初始化为第一个元素,才能正确处理全负数组。
function maxSubArray(numbers) { // 接收非空整数数组
if (!numbers.length) throw new RangeError('数组不能为空') // 明确拒绝无答案输入
let current = numbers[0] // 保存必须以当前位置结尾的最大和
let best = numbers[0] // 保存遍历至今的全局最大和
for (let index = 1; index < numbers.length; index += 1) { // 从第二个元素开始递推
current = Math.max(numbers[index], current + numbers[index]) // 选择重新开始或接在旧区间后
best = Math.max(best, current) // 更新全局答案
} // 结束数组扫描
return best // 返回最大连续子数组和
} // 结束最大子数组函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[-2,1,-3,4,-1,2,1,-5,4]返回6,区间为[4,-1,2,1]。 - 易错点:不能把初始最大值设为
0,否则全负数组会得到不存在的空子数组。
💬 面试官追问
- 如何返回区间下标? 重新开始时记录候选左端,更新全局答案时保存左右端。
- 与前缀和有什么关系? 最大子数组也可看成当前前缀减去此前最小前缀。
- 允许空子数组时怎么变? 可把答案下限设为
0,但必须明确这是另一种题目契约。 - 数据流能实时计算吗? 可以,只需保留
current和best两个状态。
# 36 打家劫舍
⚡ 30 秒速记
- 当前房屋只有“偷”和“不偷”两种选择
- 偷当前房屋就只能接
i - 2的最优值 - 不偷当前房屋就继承
i - 1的最优值
相邻互斥问题用两状态滚动动态规划。 每一步比较“跳过当前”与“选择当前加上隔一间的答案”,只保留前两项即可。
# 题目与解题思路
给定每间房的非负金额,不能偷相邻房屋,求最大金额。空数组返回 0。
function rob(houses) { // 接收每间房屋的金额
let previousTwo = 0 // 保存处理到前两间房时的最优值
let previousOne = 0 // 保存处理到前一间房时的最优值
for (const money of houses) { // 依次考虑每间房屋
const current = Math.max(previousOne, previousTwo + money) // 比较跳过与选择当前房屋
previousTwo = previousOne // 向前滚动较旧状态
previousOne = current // 保存处理到当前房屋的最优值
} // 结束房屋扫描
return previousOne // 返回最终最大金额
} // 结束打家劫舍函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[2,7,9,3,1]返回12,选择2、9、1。 - 易错点:状态滚动顺序不能颠倒,否则
previousTwo会提前被当前结果覆盖。
💬 面试官追问
- 房屋首尾相邻怎么办? 分别计算“不选首间”和“不选末间”两条线性结果,再取较大值。
- 金额允许负数呢? 当前初始化会自然选择全部跳过并返回
0,需确认是否允许不偷任何房屋。 - 如何还原选择了哪些房屋? 保存完整 DP 和决策,再从末尾反向追踪。
- 树形房屋怎么做? 每个节点返回“选当前”和“不选当前”两个状态,后序合并孩子结果。
# 37 买卖股票的最佳时机
⚡ 30 秒速记
- 只能完成一次买入和一次卖出,且买入必须在前
- 扫描时维护此前最低价格
- 当前价格减最低价格就是今天卖出的最大利润
一次交易只需同时维护历史最小值和最佳利润。 每到一天先评估卖出收益,再把当天价格纳入后续最低买价。
# 题目与解题思路
给定每日价格,求一次交易可得最大利润;无法盈利时返回 0。
function maxProfit(prices) { // 接收每日股票价格
let minimumPrice = Infinity // 保存当前日期之前的最低买入价
let bestProfit = 0 // 保存目前可得的最大非负利润
for (const price of prices) { // 按时间顺序扫描价格
bestProfit = Math.max(bestProfit, price - minimumPrice) // 假设今天卖出并更新利润
minimumPrice = Math.min(minimumPrice, price) // 把今天纳入未来买入候选
} // 结束价格扫描
return bestProfit // 返回最大利润
} // 结束股票利润函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[7,1,5,3,6,4]返回5,在1买入、6卖出。 - 易错点:不能用全局最大价减全局最小价,因为最大价可能出现在最小价之前。
💬 面试官追问
- 可交易多次怎么做? 累加每段相邻上涨差值,等价于持有/空仓的动态规划。
- 有手续费怎么办? 状态转移中在买入或卖出的一侧统一扣除手续费。
- 要求冷冻期怎么改? 增加冷冻状态,卖出后的下一天不能立刻买入。
- 如何返回买卖日期? 更新最低价时记下日期,更新最佳利润时同步保存买入和卖出下标。
# 38 盛最多水的容器
⚡ 30 秒速记
- 面积由较短边乘以两指针距离决定
- 每轮移动较短的一边,才可能找到更高的有效边
- 移动较长边只会缩短宽度,短板不变时面积不可能增大
双指针的正确性来自排除法。 当前短板与任何更近的另一条边组合都不会更优,因此可以安全舍弃短板位置。
# 题目与解题思路
给定每个位置的高度,选择两条线与横轴组成容器,返回最大容量。
function maxArea(heights) { // 接收所有竖线高度
let left = 0 // 左指针从首条线开始
let right = heights.length - 1 // 右指针从末条线开始
let best = 0 // 保存目前最大面积
while (left < right) { // 至少还有两条不同竖线时继续
const height = Math.min(heights[left], heights[right]) // 容器高度由短板决定
best = Math.max(best, height * (right - left)) // 用当前高度和宽度更新面积
if (heights[left] <= heights[right]) left += 1 // 左边较短时舍弃左边
else right -= 1 // 右边较短时舍弃右边
} // 结束双指针收缩
return best // 返回最大容器面积
} // 结束最大面积函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[1,8,6,2,5,4,8,3,7]返回49。 - 易错点:移动的是较短边,不是随意移动,也不能把较高边当作容器高度。
💬 面试官追问
- 两边高度相等时移动哪边? 任意一边都可;当前实现移动左边,正确性不受影响。
- 为什么不能排序? 面积依赖原始位置间距,排序会破坏宽度信息。
- 高度有负数怎么办? 物理语义不成立,应在入口校验非负输入。
- 怎样返回两条线的位置? 更新最大面积时同步保存左右下标。
# 39 接雨水
⚡ 30 秒速记
- 每个位置水量由左右最高挡板的较小值决定
- 双指针维护两侧已见最高值
- 较低一侧的水量已能确定,计算后向内移动
接雨水的双指针版本把前后缀最大值压缩成四个变量。 当左侧最高不大于右侧最高时,左位置的结果不再依赖更远的右侧细节。
# 题目与解题思路
给定非负柱高,计算下雨后能接住的总水量。每轮先更新两侧最高值,再结算较低一侧。
function trap(heights) { // 接收柱子高度数组
let left = 0 // 初始化左指针
let right = heights.length - 1 // 初始化右指针
let leftMax = 0 // 保存左侧扫描到的最高柱
let rightMax = 0 // 保存右侧扫描到的最高柱
let water = 0 // 累计雨水总量
while (left <= right) { // 两侧扫描区间未交错时继续
leftMax = Math.max(leftMax, heights[left]) // 更新左侧最高值
rightMax = Math.max(rightMax, heights[right]) // 更新右侧最高值
if (leftMax <= rightMax) { // 左侧短板已决定左位置水量
water += leftMax - heights[left] // 累加左位置可存水量
left += 1 // 左指针向内移动
} else { // 右侧短板已决定右位置水量
water += rightMax - heights[right] // 累加右位置可存水量
right -= 1 // 右指针向内移动
} // 结束短板分支
} // 结束双指针扫描
return water // 返回总雨水量
} // 结束接雨水函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[0,1,0,2,1,0,1,3,2,1,2,1]返回6。 - 易错点:要先更新最大值再计算差值,才能保证单个位置水量非负。
💬 面试官追问
- 与盛水容器题有何不同? 容器只选两条边求单个面积,接雨水要累计每个位置上方水量。
- 能用单调栈吗? 可以按凹槽分层结算,时间
O(n)、空间O(n)。 - 前后缀数组怎么做? 分别预计算每个位置左右最高值,再逐项累加较小值减当前高度。
- 高度数组很长时为何双指针更好? 它保持线性时间,同时把额外空间降为常数。
# 40 移动零
⚡ 30 秒速记
- 慢指针指向下一个非零元素应写入的位置
- 快指针扫描所有元素,遇到非零值就写到慢指针
- 扫描结束后把剩余位置统一补零
移动零可以看成稳定过滤后再补齐。 第一阶段保持所有非零元素的相对顺序,第二阶段覆盖尾部旧数据。
# 题目与解题思路
原地把数组中的零移动到末尾,同时保持非零元素相对顺序。函数返回原数组,便于演示,但核心要求是原地修改。
function moveZeroes(numbers) { // 接收需要原地修改的数组
let write = 0 // 指向下一个非零元素写入位置
for (let read = 0; read < numbers.length; read += 1) { // 用读指针扫描整个数组
if (numbers[read] === 0) continue // 零元素留到第二阶段统一处理
numbers[write] = numbers[read] // 把非零元素稳定写到前部
write += 1 // 推进下一个写入位置
} // 结束非零元素收集
while (write < numbers.length) { // 覆盖剩余尾部位置
numbers[write] = 0 // 在尾部写入零
write += 1 // 推进尾部写指针
} // 结束尾部补零
return numbers // 返回同一个数组引用
} // 结束移动零函数
# 复杂度、示例与易错点
- 时间复杂度
O(n),空间复杂度O(1)。 - 示例:
[0,1,0,3,12]原地变为[1,3,12,0,0]。 - 易错点:判断必须使用严格数值比较,不能把
false、空字符串等其他假值当作零。
💬 面试官追问
- 为什么非零顺序不会改变? 快指针从左到右读取,慢指针按相同顺序连续写入。
- 能通过交换完成吗? 可以在遇到非零值时与慢指针位置交换,写入次数特征不同。
- 为何不能用
filter? 它会创建新数组,不满足原地修改的空间约束。 - 如何把指定值都移到末尾? 把零判断抽成目标值或谓词,其余稳定压缩逻辑不变。
# 41 相交链表
⚡ 30 秒速记
- 核心套路:让两个指针分别走完 A+B 与 B+A,用交换路径抵消两条链表的长度差。
- 复杂度:时间 O(m+n),空间 O(1)。
- 易错边界:比较的是节点引用而不是节点值;无交点时两个指针最终会同时到达 null。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「相交链表」。让两个指针分别走完 A+B 与 B+A,用交换路径抵消两条链表的长度差。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function getIntersectionNode(headA, headB) { // 定义本题的核心实现
let pointerA = headA // 初始化当前步骤需要的状态
let pointerB = headB // 初始化当前步骤需要的状态
while (pointerA !== pointerB) { // 遍历仍需处理的候选状态
pointerA = pointerA ? pointerA.next : headB // 执行当前语句
pointerB = pointerB ? pointerB.next : headA // 执行当前语句
} // 结束当前代码块
return pointerA // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(m+n),空间 O(1)。
- 示例:A=4→1→8→4→5、B=5→6→1→8→4→5,返回值为 8 的同一个节点。
- 易错点:比较的是节点引用而不是节点值;无交点时两个指针最终会同时到达 null。
💬 面试官追问
- 为什么选择这个解法? 让两个指针分别走完 A+B 与 B+A,用交换路径抵消两条链表的长度差。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:比较的是节点引用而不是节点值;无交点时两个指针最终会同时到达 null。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 42 回文链表
⚡ 30 秒速记
- 核心套路:快慢指针找到中点,反转后半段,再从两端逐节点比较。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:奇数长度要跳过中间节点;若业务要求保持原链表,应在比较后把后半段复原。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「回文链表」。快慢指针找到中点,反转后半段,再从两端逐节点比较。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isPalindromeList(head) { // 定义本题的核心实现
let slow = head // 初始化当前步骤需要的状态
let fast = head // 初始化当前步骤需要的状态
while (fast && fast.next) { // 遍历仍需处理的候选状态
slow = slow.next // 执行当前语句
fast = fast.next.next // 执行当前语句
} // 结束当前代码块
let previous = null // 初始化当前步骤需要的状态
while (slow) { // 遍历仍需处理的候选状态
const next = slow.next // 初始化当前步骤需要的状态
slow.next = previous // 执行当前语句
previous = slow // 执行当前语句
slow = next // 执行当前语句
} // 结束当前代码块
for (let left = head, right = previous; right; left = left.next, right = right.next) { // 遍历仍需处理的候选状态
if (left.value !== right.value) return false // 检查当前分支条件
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:1→2→2→1 返回 true,1→2 返回 false。
- 易错点:奇数长度要跳过中间节点;若业务要求保持原链表,应在比较后把后半段复原。
💬 面试官追问
- 为什么选择这个解法? 快慢指针找到中点,反转后半段,再从两端逐节点比较。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:奇数长度要跳过中间节点;若业务要求保持原链表,应在比较后把后半段复原。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 43 移除链表中的指定元素
⚡ 30 秒速记
- 核心套路:增加哑节点统一处理删除头节点和删除中间节点,current 始终检查自己的后继。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:删除后不能立刻推进 current,否则连续目标值会被漏掉。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「移除链表中的指定元素」。增加哑节点统一处理删除头节点和删除中间节点,current 始终检查自己的后继。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeElements(head, target) { // 定义本题的核心实现
const dummy = { next: head } // 初始化当前步骤需要的状态
let current = dummy // 初始化当前步骤需要的状态
while (current.next) { // 遍历仍需处理的候选状态
if (current.next.value === target) current.next = current.next.next // 检查当前分支条件
else current = current.next // 处理另一种分支
} // 结束当前代码块
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:1→2→6→3→6 删除 6 后得到 1→2→3。
- 易错点:删除后不能立刻推进 current,否则连续目标值会被漏掉。
💬 面试官追问
- 为什么选择这个解法? 增加哑节点统一处理删除头节点和删除中间节点,current 始终检查自己的后继。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:删除后不能立刻推进 current,否则连续目标值会被漏掉。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 44 反转链表指定区间
⚡ 30 秒速记
- 核心套路:用哑节点找到区间前驱,连续把区间内后继节点摘下并插到区间头部。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:left 和 right 通常按 1 开始计数;头插时必须保留区间尾节点 current。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「反转链表指定区间」。用哑节点找到区间前驱,连续把区间内后继节点摘下并插到区间头部。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function reverseBetween(head, left, right) { // 定义本题的核心实现
const dummy = { next: head } // 初始化当前步骤需要的状态
let before = dummy // 初始化当前步骤需要的状态
for (let index = 1; index < left; index += 1) before = before.next // 遍历仍需处理的候选状态
const current = before.next // 初始化当前步骤需要的状态
for (let index = left; index < right; index += 1) { // 遍历仍需处理的候选状态
const moved = current.next // 初始化当前步骤需要的状态
current.next = moved.next // 执行当前语句
moved.next = before.next // 执行当前语句
before.next = moved // 执行当前语句
} // 结束当前代码块
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:1→2→3→4→5,反转 [2,4] 得到 1→4→3→2→5。
- 易错点:left 和 right 通常按 1 开始计数;头插时必须保留区间尾节点 current。
💬 面试官追问
- 为什么选择这个解法? 用哑节点找到区间前驱,连续把区间内后继节点摘下并插到区间头部。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:left 和 right 通常按 1 开始计数;头插时必须保留区间尾节点 current。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 45 排序链表
⚡ 30 秒速记
- 核心套路:用快慢指针二分链表,递归排序左右两半,再线性合并两个有序链表。
- 复杂度:时间 O(n log n),递归栈 O(log n)。
- 易错边界:切分时必须把 slow.next 置空,否则左右链表仍相连并导致无限递归。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「排序链表」。用快慢指针二分链表,递归排序左右两半,再线性合并两个有序链表。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function mergeForList(left, right) { // 定义本题的核心实现
const dummy = { next: null } // 初始化当前步骤需要的状态
let tail = dummy // 初始化当前步骤需要的状态
while (left && right) { // 遍历仍需处理的候选状态
if (left.value <= right.value) { // 检查当前分支条件
tail.next = left // 执行当前语句
left = left.next // 执行当前语句
} else { // 进入当前逻辑分支
tail.next = right // 执行当前语句
right = right.next // 执行当前语句
} // 结束当前代码块
tail = tail.next // 执行当前语句
} // 结束当前代码块
tail.next = left ?? right // 执行当前语句
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
function sortList(head) { // 定义本题的核心实现
if (!head || !head.next) return head // 检查当前分支条件
let slow = head // 初始化当前步骤需要的状态
let fast = head.next // 初始化当前步骤需要的状态
while (fast && fast.next) { // 遍历仍需处理的候选状态
slow = slow.next // 执行当前语句
fast = fast.next.next // 执行当前语句
} // 结束当前代码块
const rightHead = slow.next // 初始化当前步骤需要的状态
slow.next = null // 执行当前语句
return mergeForList(sortList(head), sortList(rightHead)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n),递归栈 O(log n)。
- 示例:4→2→1→3 排序后得到 1→2→3→4。
- 易错点:切分时必须把 slow.next 置空,否则左右链表仍相连并导致无限递归。
💬 面试官追问
- 为什么选择这个解法? 用快慢指针二分链表,递归排序左右两半,再线性合并两个有序链表。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:切分时必须把 slow.next 置空,否则左右链表仍相连并导致无限递归。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 46 链表表示的两数相加
⚡ 30 秒速记
- 核心套路:从低位到高位同步遍历两条链表,把当前和的个位写入新节点并保存进位。
- 复杂度:时间 O(max(m,n)),结果链表 O(max(m,n))。
- 易错边界:循环条件必须包含 carry,才能处理最后仍有进位的情况。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「链表表示的两数相加」。从低位到高位同步遍历两条链表,把当前和的个位写入新节点并保存进位。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function addTwoNumbers(left, right) { // 定义本题的核心实现
const dummy = { next: null } // 初始化当前步骤需要的状态
let tail = dummy // 初始化当前步骤需要的状态
let carry = 0 // 初始化当前步骤需要的状态
while (left || right || carry) { // 遍历仍需处理的候选状态
const sum = (left?.value ?? 0) + (right?.value ?? 0) + carry // 初始化当前步骤需要的状态
carry = Math.floor(sum / 10) // 执行当前语句
tail.next = { value: sum % 10, next: null } // 执行当前语句
tail = tail.next // 执行当前语句
left = left?.next ?? null // 执行当前语句
right = right?.next ?? null // 执行当前语句
} // 结束当前代码块
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(max(m,n)),结果链表 O(max(m,n))。
- 示例:2→4→3 与 5→6→4 相加得到 7→0→8。
- 易错点:循环条件必须包含 carry,才能处理最后仍有进位的情况。
💬 面试官追问
- 为什么选择这个解法? 从低位到高位同步遍历两条链表,把当前和的个位写入新节点并保存进位。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:循环条件必须包含 carry,才能处理最后仍有进位的情况。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 47 合并 K 个升序链表
⚡ 30 秒速记
- 核心套路:把链表两两分组合并,像归并排序一样逐轮把链表数量减半。
- 复杂度:时间 O(N log k),递归/临时数组 O(log k)。
- 易错边界:N 是全部节点数而不是单条链表长度;空列表和奇数条列表要单独覆盖。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「合并 K 个升序链表」。把链表两两分组合并,像归并排序一样逐轮把链表数量减半。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function mergePair(left, right) { // 定义本题的核心实现
const dummy = { next: null } // 初始化当前步骤需要的状态
let tail = dummy // 初始化当前步骤需要的状态
while (left && right) { // 遍历仍需处理的候选状态
if (left.value <= right.value) { // 检查当前分支条件
tail.next = left // 执行当前语句
left = left.next // 执行当前语句
} else { // 进入当前逻辑分支
tail.next = right // 执行当前语句
right = right.next // 执行当前语句
} // 结束当前代码块
tail = tail.next // 执行当前语句
} // 结束当前代码块
tail.next = left ?? right // 执行当前语句
return dummy.next // 返回本题要求的结果
} // 结束当前代码块
function mergeKLists(lists) { // 定义本题的核心实现
if (!lists.length) return null // 检查当前分支条件
let current = lists // 初始化当前步骤需要的状态
while (current.length > 1) { // 遍历仍需处理的候选状态
const next = [] // 初始化当前步骤需要的状态
for (let index = 0; index < current.length; index += 2) { // 遍历仍需处理的候选状态
next.push(mergePair(current[index], current[index + 1] ?? null)) // 执行当前语句
} // 结束当前代码块
current = next // 执行当前语句
} // 结束当前代码块
return current[0] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(N log k),递归/临时数组 O(log k)。
- 示例:[1→4→5,1→3→4,2→6] 合并为 1→1→2→3→4→4→5→6。
- 易错点:N 是全部节点数而不是单条链表长度;空列表和奇数条列表要单独覆盖。
💬 面试官追问
- 为什么选择这个解法? 把链表两两分组合并,像归并排序一样逐轮把链表数量减半。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:N 是全部节点数而不是单条链表长度;空列表和奇数条列表要单独覆盖。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 48 验证回文字符串
⚡ 30 秒速记
- 核心套路:左右指针跳过非字母数字字符,再按统一小写形式比较有效字符。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:不能先用正则生成完整新字符串后仍声称空间 O(1);Unicode 范围需另行定义。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「验证回文字符串」。左右指针跳过非字母数字字符,再按统一小写形式比较有效字符。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isPalindromeText(text) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = text.length - 1 // 初始化当前步骤需要的状态
const valid = character => /[a-z0-9]/i.test(character) // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
while (left < right && !valid(text[left])) left += 1 // 遍历仍需处理的候选状态
while (left < right && !valid(text[right])) right -= 1 // 遍历仍需处理的候选状态
if (text[left].toLowerCase() !== text[right].toLowerCase()) return false // 检查当前分支条件
left += 1 // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:A man, a plan, a canal: Panama 返回 true。
- 易错点:不能先用正则生成完整新字符串后仍声称空间 O(1);Unicode 范围需另行定义。
💬 面试官追问
- 为什么选择这个解法? 左右指针跳过非字母数字字符,再按统一小写形式比较有效字符。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:不能先用正则生成完整新字符串后仍声称空间 O(1);Unicode 范围需另行定义。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 49 有序数组的平方
⚡ 30 秒速记
- 核心套路:平方后的最大值一定来自绝对值最大的两端,从结果数组末尾向前写。
- 复杂度:时间 O(n),结果空间 O(n)。
- 易错边界:比较的是绝对值;从头写会难以保持升序。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「有序数组的平方」。平方后的最大值一定来自绝对值最大的两端,从结果数组末尾向前写。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function sortedSquares(numbers) { // 定义本题的核心实现
const result = new Array(numbers.length) // 初始化当前步骤需要的状态
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
for (let write = right; write >= 0; write -= 1) { // 遍历仍需处理的候选状态
const leftSquare = numbers[left] ** 2 // 初始化当前步骤需要的状态
const rightSquare = numbers[right] ** 2 // 初始化当前步骤需要的状态
if (leftSquare > rightSquare) { // 检查当前分支条件
result[write] = leftSquare // 执行当前语句
left += 1 // 执行当前语句
} else { // 进入当前逻辑分支
result[write] = rightSquare // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),结果空间 O(n)。
- 示例:[-4,-1,0,3,10] 得到 [0,1,9,16,100]。
- 易错点:比较的是绝对值;从头写会难以保持升序。
💬 面试官追问
- 为什么选择这个解法? 平方后的最大值一定来自绝对值最大的两端,从结果数组末尾向前写。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:比较的是绝对值;从头写会难以保持升序。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 50 有序数组的两数之和
⚡ 30 秒速记
- 核心套路:利用升序性质从两端夹逼:和太小移动左指针,和太大移动右指针。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:题目若要求 1-based 下标,返回时需要加一;无序数组不能直接使用。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「有序数组的两数之和」。利用升序性质从两端夹逼:和太小移动左指针,和太大移动右指针。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function twoSumSorted(numbers, target) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const sum = numbers[left] + numbers[right] // 初始化当前步骤需要的状态
if (sum === target) return [left + 1, right + 1] // 检查当前分支条件
if (sum < target) left += 1 // 检查当前分支条件
else right -= 1 // 处理另一种分支
} // 结束当前代码块
return [] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,7,11,15]、target=9 返回 [1,2]。
- 易错点:题目若要求 1-based 下标,返回时需要加一;无序数组不能直接使用。
💬 面试官追问
- 为什么选择这个解法? 利用升序性质从两端夹逼:和太小移动左指针,和太大移动右指针。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:题目若要求 1-based 下标,返回时需要加一;无序数组不能直接使用。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 51 长度最小的连续子数组
⚡ 30 秒速记
- 核心套路:右指针扩张窗口直到和达标,再持续移动左指针压缩出当前最短长度。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:该滑动窗口依赖元素均为正数;包含负数时窗口和不再单调。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「长度最小的连续子数组」。右指针扩张窗口直到和达标,再持续移动左指针压缩出当前最短长度。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minSubArrayLen(target, numbers) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let sum = 0 // 初始化当前步骤需要的状态
let best = Infinity // 初始化当前步骤需要的状态
for (let right = 0; right < numbers.length; right += 1) { // 遍历仍需处理的候选状态
sum += numbers[right] // 执行当前语句
while (sum >= target) { // 遍历仍需处理的候选状态
best = Math.min(best, right - left + 1) // 执行当前语句
sum -= numbers[left] // 执行当前语句
left += 1 // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return best === Infinity ? 0 : best // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:target=7、[2,3,1,2,4,3] 返回 2。
- 易错点:该滑动窗口依赖元素均为正数;包含负数时窗口和不再单调。
💬 面试官追问
- 为什么选择这个解法? 右指针扩张窗口直到和达标,再持续移动左指针压缩出当前最短长度。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:该滑动窗口依赖元素均为正数;包含负数时窗口和不再单调。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 52 删除有序数组中的重复项
⚡ 30 秒速记
- 核心套路:读指针扫描数组,遇到与已写末尾不同的值就写入慢指针位置。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:函数返回的是新长度,长度之后的旧值不属于有效结果。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「删除有序数组中的重复项」。读指针扫描数组,遇到与已写末尾不同的值就写入慢指针位置。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeDuplicates(numbers) { // 定义本题的核心实现
if (!numbers.length) return 0 // 检查当前分支条件
let write = 1 // 初始化当前步骤需要的状态
for (let read = 1; read < numbers.length; read += 1) { // 遍历仍需处理的候选状态
if (numbers[read] === numbers[write - 1]) continue // 检查当前分支条件
numbers[write] = numbers[read] // 执行当前语句
write += 1 // 执行当前语句
} // 结束当前代码块
return write // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[0,0,1,1,2] 返回 3,前 3 项为 [0,1,2]。
- 易错点:函数返回的是新长度,长度之后的旧值不属于有效结果。
💬 面试官追问
- 为什么选择这个解法? 读指针扫描数组,遇到与已写末尾不同的值就写入慢指针位置。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:函数返回的是新长度,长度之后的旧值不属于有效结果。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 53 原地移除数组指定元素
⚡ 30 秒速记
- 核心套路:读指针扫描,只有非目标值才写入慢指针所指位置。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:不要求保持尾部内容;若允许打乱顺序,也可用末尾元素覆盖以减少写入。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「原地移除数组指定元素」。读指针扫描,只有非目标值才写入慢指针所指位置。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeElement(numbers, target) { // 定义本题的核心实现
let write = 0 // 初始化当前步骤需要的状态
for (const value of numbers) { // 遍历仍需处理的候选状态
if (value === target) continue // 检查当前分支条件
numbers[write] = value // 执行当前语句
write += 1 // 执行当前语句
} // 结束当前代码块
return write // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[3,2,2,3] 移除 3 后返回长度 2,前缀为 [2,2]。
- 易错点:不要求保持尾部内容;若允许打乱顺序,也可用末尾元素覆盖以减少写入。
💬 面试官追问
- 为什么选择这个解法? 读指针扫描,只有非目标值才写入慢指针所指位置。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:不要求保持尾部内容;若允许打乱顺序,也可用末尾元素覆盖以减少写入。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 54 原地反转字符串数组
⚡ 30 秒速记
- 核心套路:左右指针交换字符并同时向中间移动。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:题目输入通常是字符数组而不是不可变字符串;循环条件是 left < right。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「原地反转字符串数组」。左右指针交换字符并同时向中间移动。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function reverseCharacters(characters) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = characters.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
;[characters[left], characters[right]] = [characters[right], characters[left]] // 执行当前语句
left += 1 // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
return characters // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[h,e,l,l,o] 原地变为 [o,l,l,e,h]。
- 易错点:题目输入通常是字符数组而不是不可变字符串;循环条件是 left < right。
💬 面试官追问
- 为什么选择这个解法? 左右指针交换字符并同时向中间移动。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:题目输入通常是字符数组而不是不可变字符串;循环条件是 left < right。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 55 两个数组的交集
⚡ 30 秒速记
- 核心套路:把第一个数组放进 Set,再扫描第二个数组并把命中值写入结果 Set。
- 复杂度:平均时间 O(m+n),空间 O(m+n)。
- 易错边界:交集结果要求去重;若要求保留出现次数,应改用频次 Map。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「两个数组的交集」。把第一个数组放进 Set,再扫描第二个数组并把命中值写入结果 Set。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function intersection(left, right) { // 定义本题的核心实现
const candidates = new Set(left) // 初始化当前步骤需要的状态
const result = new Set() // 初始化当前步骤需要的状态
for (const value of right) { // 遍历仍需处理的候选状态
if (candidates.has(value)) result.add(value) // 检查当前分支条件
} // 结束当前代码块
return [...result] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 平均时间 O(m+n),空间 O(m+n)。
- 示例:[1,2,2,1] 与 [2,2] 的交集为 [2]。
- 易错点:交集结果要求去重;若要求保留出现次数,应改用频次 Map。
💬 面试官追问
- 为什么选择这个解法? 把第一个数组放进 Set,再扫描第二个数组并把命中值写入结果 Set。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:交集结果要求去重;若要求保留出现次数,应改用频次 Map。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 56 搜索插入位置
⚡ 30 秒速记
- 核心套路:在左闭右开区间中寻找第一个大于等于 target 的位置,也就是 lower_bound。
- 复杂度:时间 O(log n),空间 O(1)。
- 易错边界:返回范围允许等于数组长度;区间语义必须从初始化到循环条件保持一致。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「搜索插入位置」。在左闭右开区间中寻找第一个大于等于 target 的位置,也就是 lower_bound。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function searchInsert(numbers, target) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
if (numbers[middle] < target) left = middle + 1 // 检查当前分支条件
else right = middle // 处理另一种分支
} // 结束当前代码块
return left // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log n),空间 O(1)。
- 示例:[1,3,5,6] 中查找 2 返回 1,查找 7 返回 4。
- 易错点:返回范围允许等于数组长度;区间语义必须从初始化到循环条件保持一致。
💬 面试官追问
- 为什么选择这个解法? 在左闭右开区间中寻找第一个大于等于 target 的位置,也就是 lower_bound。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:返回范围允许等于数组长度;区间语义必须从初始化到循环条件保持一致。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 57 整数平方根
⚡ 30 秒速记
- 核心套路:二分寻找最大的 x,使 x² 不超过给定非负整数。
- 复杂度:时间 O(log n),空间 O(1)。
- 易错边界:其他语言要防止 middle*middle 溢出,可比较 middle <= n/middle。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「整数平方根」。二分寻找最大的 x,使 x² 不超过给定非负整数。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function integerSqrt(value) { // 定义本题的核心实现
if (value < 2) return value // 检查当前分支条件
let left = 1 // 初始化当前步骤需要的状态
let right = Math.floor(value / 2) // 初始化当前步骤需要的状态
let answer = 1 // 初始化当前步骤需要的状态
while (left <= right) { // 遍历仍需处理的候选状态
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
if (middle <= value / middle) { // 检查当前分支条件
answer = middle // 执行当前语句
left = middle + 1 // 执行当前语句
} else right = middle - 1 // 执行当前语句
} // 结束当前代码块
return answer // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log n),空间 O(1)。
- 示例:sqrt(8) 向下取整返回 2,sqrt(9) 返回 3。
- 易错点:其他语言要防止 middle*middle 溢出,可比较 middle <= n/middle。
💬 面试官追问
- 为什么选择这个解法? 二分寻找最大的 x,使 x² 不超过给定非负整数。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:其他语言要防止 middle*middle 溢出,可比较 middle <= n/middle。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 58 寻找旋转排序数组中的最小值
⚡ 30 秒速记
- 核心套路:比较中点与右端值,判断最小值落在包含中点的右半区还是左半区。
- 复杂度:时间 O(log n),空间 O(1)。
- 易错边界:该版本假设元素互不相同;允许重复时 middle 与 right 相等只能缩小 right。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「寻找旋转排序数组中的最小值」。比较中点与右端值,判断最小值落在包含中点的右半区还是左半区。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findRotatedMinimum(numbers) { // 定义本题的核心实现
let left = 0 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
if (numbers[middle] > numbers[right]) left = middle + 1 // 检查当前分支条件
else right = middle // 处理另一种分支
} // 结束当前代码块
return numbers[left] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log n),空间 O(1)。
- 示例:[4,5,6,7,0,1,2] 返回 0。
- 易错点:该版本假设元素互不相同;允许重复时 middle 与 right 相等只能缩小 right。
💬 面试官追问
- 为什么选择这个解法? 比较中点与右端值,判断最小值落在包含中点的右半区还是左半区。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:该版本假设元素互不相同;允许重复时 middle 与 right 相等只能缩小 right。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 59 跳跃游戏
⚡ 30 秒速记
- 核心套路:从左到右维护当前能到达的最远位置,若索引超过最远位置就说明断裂。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:不要真的枚举所有跳法;一旦 farthest 覆盖末尾即可提前成功。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「跳跃游戏」。从左到右维护当前能到达的最远位置,若索引超过最远位置就说明断裂。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function canJump(numbers) { // 定义本题的核心实现
let farthest = 0 // 初始化当前步骤需要的状态
for (let index = 0; index < numbers.length; index += 1) { // 遍历仍需处理的候选状态
if (index > farthest) return false // 检查当前分支条件
farthest = Math.max(farthest, index + numbers[index]) // 执行当前语句
if (farthest >= numbers.length - 1) return true // 检查当前分支条件
} // 结束当前代码块
return numbers.length <= 1 // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,3,1,1,4] 返回 true,[3,2,1,0,4] 返回 false。
- 易错点:不要真的枚举所有跳法;一旦 farthest 覆盖末尾即可提前成功。
💬 面试官追问
- 为什么选择这个解法? 从左到右维护当前能到达的最远位置,若索引超过最远位置就说明断裂。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:不要真的枚举所有跳法;一旦 farthest 覆盖末尾即可提前成功。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 60 跳跃游戏 II
⚡ 30 秒速记
- 核心套路:按层扫描当前一步能覆盖的区间,到达区间末尾时增加跳数并扩展下一层边界。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:循环只到倒数第二项;题目若不保证可达,需要检测边界无法继续扩张。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「跳跃游戏 II」。按层扫描当前一步能覆盖的区间,到达区间末尾时增加跳数并扩展下一层边界。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minimumJumps(numbers) { // 定义本题的核心实现
let steps = 0 // 初始化当前步骤需要的状态
let boundary = 0 // 初始化当前步骤需要的状态
let farthest = 0 // 初始化当前步骤需要的状态
for (let index = 0; index < numbers.length - 1; index += 1) { // 遍历仍需处理的候选状态
farthest = Math.max(farthest, index + numbers[index]) // 执行当前语句
if (index !== boundary) continue // 检查当前分支条件
steps += 1 // 执行当前语句
boundary = farthest // 执行当前语句
} // 结束当前代码块
return steps // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,3,1,1,4] 最少跳 2 次。
- 易错点:循环只到倒数第二项;题目若不保证可达,需要检测边界无法继续扩张。
💬 面试官追问
- 为什么选择这个解法? 按层扫描当前一步能覆盖的区间,到达区间末尾时增加跳数并扩展下一层边界。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:循环只到倒数第二项;题目若不保证可达,需要检测边界无法继续扩张。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 61 无重叠区间
⚡ 30 秒速记
- 核心套路:按结束位置升序排列,尽量保留结束最早的区间,其余重叠区间删除。
- 复杂度:时间 O(n log n),排序外空间视实现而定。
- 易错边界:判断重叠时相邻端点通常允许相等;空数组要返回 0。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「无重叠区间」。按结束位置升序排列,尽量保留结束最早的区间,其余重叠区间删除。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function eraseOverlapIntervals(intervals) { // 定义本题的核心实现
intervals.sort((left, right) => left[1] - right[1]) // 执行当前语句
let kept = 0 // 初始化当前步骤需要的状态
let end = -Infinity // 初始化当前步骤需要的状态
for (const interval of intervals) { // 遍历仍需处理的候选状态
if (interval[0] < end) continue // 检查当前分支条件
kept += 1 // 执行当前语句
end = interval[1] // 执行当前语句
} // 结束当前代码块
return intervals.length - kept // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n),排序外空间视实现而定。
- 示例:[[1,2],[2,3],[3,4],[1,3]] 最少删除 1 个。
- 易错点:判断重叠时相邻端点通常允许相等;空数组要返回 0。
💬 面试官追问
- 为什么选择这个解法? 按结束位置升序排列,尽量保留结束最早的区间,其余重叠区间删除。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:判断重叠时相邻端点通常允许相等;空数组要返回 0。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 62 用最少箭引爆气球
⚡ 30 秒速记
- 核心套路:按右端点排序,在当前箭覆盖不到新区间时,于新区间右端点再射一箭。
- 复杂度:时间 O(n log n),空间 O(1)(忽略排序)。
- 易错边界:边界相等仍可由同一支箭命中,所以新箭条件是 start > end。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「用最少箭引爆气球」。按右端点排序,在当前箭覆盖不到新区间时,于新区间右端点再射一箭。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findMinArrowShots(points) { // 定义本题的核心实现
if (!points.length) return 0 // 检查当前分支条件
points.sort((left, right) => left[1] - right[1]) // 执行当前语句
let arrows = 1 // 初始化当前步骤需要的状态
let end = points[0][1] // 初始化当前步骤需要的状态
for (let index = 1; index < points.length; index += 1) { // 遍历仍需处理的候选状态
if (points[index][0] <= end) continue // 检查当前分支条件
arrows += 1 // 执行当前语句
end = points[index][1] // 执行当前语句
} // 结束当前代码块
return arrows // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n),空间 O(1)(忽略排序)。
- 示例:[[10,16],[2,8],[1,6],[7,12]] 返回 2。
- 易错点:边界相等仍可由同一支箭命中,所以新箭条件是 start > end。
💬 面试官追问
- 为什么选择这个解法? 按右端点排序,在当前箭覆盖不到新区间时,于新区间右端点再射一箭。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:边界相等仍可由同一支箭命中,所以新箭条件是 start > end。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 63 分发饼干
⚡ 30 秒速记
- 核心套路:把孩子胃口和饼干尺寸都排序,用当前最小可满足饼干匹配当前孩子。
- 复杂度:时间 O(n log n + m log m),空间取决于排序。
- 易错边界:不要拿大饼干先满足小胃口,否则可能浪费唯一能满足大胃口的资源。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「分发饼干」。把孩子胃口和饼干尺寸都排序,用当前最小可满足饼干匹配当前孩子。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findContentChildren(greed, cookies) { // 定义本题的核心实现
greed.sort((left, right) => left - right) // 执行当前语句
cookies.sort((left, right) => left - right) // 执行当前语句
let child = 0 // 初始化当前步骤需要的状态
for (const cookie of cookies) { // 遍历仍需处理的候选状态
if (cookie < greed[child]) continue // 检查当前分支条件
child += 1 // 执行当前语句
if (child === greed.length) break // 检查当前分支条件
} // 结束当前代码块
return child // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log n + m log m),空间取决于排序。
- 示例:胃口 [1,2,3]、饼干 [1,1] 最多满足 1 个孩子。
- 易错点:不要拿大饼干先满足小胃口,否则可能浪费唯一能满足大胃口的资源。
💬 面试官追问
- 为什么选择这个解法? 把孩子胃口和饼干尺寸都排序,用当前最小可满足饼干匹配当前孩子。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:不要拿大饼干先满足小胃口,否则可能浪费唯一能满足大胃口的资源。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 64 任务调度器
⚡ 30 秒速记
- 核心套路:用最高频任务构造间隔框架,再与任务总数比较取较大值。
- 复杂度:时间 O(n),空间 O(1)(字符种类固定)。
- 易错边界:多个任务并列最高频时都要计入最后一列;任务足够多时答案就是总任务数。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「任务调度器」。用最高频任务构造间隔框架,再与任务总数比较取较大值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function leastInterval(tasks, cooldown) { // 定义本题的核心实现
const counts = new Map() // 初始化当前步骤需要的状态
for (const task of tasks) counts.set(task, (counts.get(task) ?? 0) + 1) // 遍历仍需处理的候选状态
const maximum = Math.max(0, ...counts.values()) // 初始化当前步骤需要的状态
let maximumKinds = 0 // 初始化当前步骤需要的状态
for (const count of counts.values()) { // 遍历仍需处理的候选状态
if (count === maximum) maximumKinds += 1 // 检查当前分支条件
} // 结束当前代码块
const frame = (maximum - 1) * (cooldown + 1) + maximumKinds // 初始化当前步骤需要的状态
return Math.max(tasks.length, frame) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)(字符种类固定)。
- 示例:AAABBB、冷却时间 2,最短执行长度为 8。
- 易错点:多个任务并列最高频时都要计入最后一列;任务足够多时答案就是总任务数。
💬 面试官追问
- 为什么选择这个解法? 用最高频任务构造间隔框架,再与任务总数比较取较大值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:多个任务并列最高频时都要计入最后一列;任务足够多时答案就是总任务数。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 65 逆波兰表达式求值
⚡ 30 秒速记
- 核心套路:遇到数字压栈,遇到运算符弹出右操作数和左操作数,计算后把结果压回。
- 复杂度:时间 O(n),空间 O(n)。
- 易错边界:减法和除法必须保持弹栈顺序;整数除法要向零截断。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「逆波兰表达式求值」。遇到数字压栈,遇到运算符弹出右操作数和左操作数,计算后把结果压回。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function evaluateRpn(tokens) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
const operators = new Set(['+', '-', '*', '/']) // 初始化当前步骤需要的状态
for (const token of tokens) { // 遍历仍需处理的候选状态
if (!operators.has(token)) { // 检查当前分支条件
stack.push(Number(token)) // 执行当前语句
continue // 结束或跳过当前循环步骤
} // 结束当前代码块
const right = stack.pop() // 初始化当前步骤需要的状态
const left = stack.pop() // 初始化当前步骤需要的状态
if (token === '+') stack.push(left + right) // 检查当前分支条件
if (token === '-') stack.push(left - right) // 检查当前分支条件
if (token === '*') stack.push(left * right) // 检查当前分支条件
if (token === '/') stack.push(Math.trunc(left / right)) // 检查当前分支条件
} // 结束当前代码块
return stack.pop() // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:[2,1,+,3,*] 返回 9。
- 易错点:减法和除法必须保持弹栈顺序;整数除法要向零截断。
💬 面试官追问
- 为什么选择这个解法? 遇到数字压栈,遇到运算符弹出右操作数和左操作数,计算后把结果压回。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:减法和除法必须保持弹栈顺序;整数除法要向零截断。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 66 删除字符串中的相邻重复项
⚡ 30 秒速记
- 核心套路:把结果数组当栈,当前字符与栈顶相同就弹出,否则压入。
- 复杂度:时间 O(n),空间 O(n)。
- 易错边界:删除后可能产生新的相邻重复,因此不能只做一次正则替换。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「删除字符串中的相邻重复项」。把结果数组当栈,当前字符与栈顶相同就弹出,否则压入。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function removeAdjacentDuplicates(text) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
for (const character of text) { // 遍历仍需处理的候选状态
if (stack.at(-1) === character) stack.pop() // 检查当前分支条件
else stack.push(character) // 处理另一种分支
} // 结束当前代码块
return stack.join('') // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:abbaca 最终得到 ca。
- 易错点:删除后可能产生新的相邻重复,因此不能只做一次正则替换。
💬 面试官追问
- 为什么选择这个解法? 把结果数组当栈,当前字符与栈顶相同就弹出,否则压入。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:删除后可能产生新的相邻重复,因此不能只做一次正则替换。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 67 用队列实现栈
⚡ 30 秒速记
- 核心套路:每次压入新元素后,把旧元素依次出队再入队,使新元素始终位于队头。
- 复杂度:push O(n),pop/top O(1),空间 O(n)。
- 易错边界:JavaScript 数组 shift 是 O(n),工程实现宜使用带头索引的真正队列。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「用队列实现栈」。每次压入新元素后,把旧元素依次出队再入队,使新元素始终位于队头。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class StackWithQueue { // 定义本题的核心实现
queue = [] // 执行当前语句
push(value) { // 进入当前逻辑分支
this.queue.push(value) // 执行当前语句
for (let count = this.queue.length - 1; count > 0; count -= 1) this.queue.push(this.queue.shift()) // 遍历仍需处理的候选状态
} // 结束当前代码块
pop() { // 进入当前逻辑分支
return this.queue.shift() // 返回本题要求的结果
} // 结束当前代码块
top() { // 进入当前逻辑分支
return this.queue[0] // 返回本题要求的结果
} // 结束当前代码块
empty() { // 进入当前逻辑分支
return this.queue.length === 0 // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- push O(n),pop/top O(1),空间 O(n)。
- 示例:push(1)、push(2) 后 top() 和 pop() 都得到 2。
- 易错点:JavaScript 数组 shift 是 O(n),工程实现宜使用带头索引的真正队列。
💬 面试官追问
- 为什么选择这个解法? 每次压入新元素后,把旧元素依次出队再入队,使新元素始终位于队头。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:JavaScript 数组 shift 是 O(n),工程实现宜使用带头索引的真正队列。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 68 简化 Unix 路径
⚡ 30 秒速记
- 核心套路:按斜杠切分路径,用栈保存有效目录;点号忽略,双点号弹出一层。
- 复杂度:时间 O(n),空间 O(n)。
- 易错边界:根目录以上的 .. 只能忽略;连续斜杠和尾斜杠不产生目录。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「简化 Unix 路径」。按斜杠切分路径,用栈保存有效目录;点号忽略,双点号弹出一层。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function simplifyPath(pathname) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
for (const segment of pathname.split('/')) { // 遍历仍需处理的候选状态
if (!segment || segment === '.') continue // 检查当前分支条件
if (segment === '..') stack.pop() // 检查当前分支条件
else stack.push(segment) // 处理另一种分支
} // 结束当前代码块
return '/' + stack.join('/') // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:/a/./b/../../c/ 简化为 /c。
- 易错点:根目录以上的 .. 只能忽略;连续斜杠和尾斜杠不产生目录。
💬 面试官追问
- 为什么选择这个解法? 按斜杠切分路径,用栈保存有效目录;点号忽略,双点号弹出一层。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:根目录以上的 .. 只能忽略;连续斜杠和尾斜杠不产生目录。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 69 颠倒字符串中的单词
⚡ 30 秒速记
- 核心套路:先按空白切出有效单词,再反转单词序列并用单个空格连接。
- 复杂度:时间 O(n),空间 O(n)。
- 易错边界:要压缩首尾及连续空格;不是反转每个单词内部字符。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「颠倒字符串中的单词」。先按空白切出有效单词,再反转单词序列并用单个空格连接。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function reverseWords(text) { // 定义本题的核心实现
const words = text.trim().split(/s+/) // 初始化当前步骤需要的状态
let left = 0 // 初始化当前步骤需要的状态
let right = words.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
;[words[left], words[right]] = [words[right], words[left]] // 执行当前语句
left += 1 // 执行当前语句
right -= 1 // 执行当前语句
} // 结束当前代码块
return words.join(' ') // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例: hello world 得到 world hello。
- 易错点:要压缩首尾及连续空格;不是反转每个单词内部字符。
💬 面试官追问
- 为什么选择这个解法? 先按空白切出有效单词,再反转单词序列并用单个空格连接。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:要压缩首尾及连续空格;不是反转每个单词内部字符。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 70 下一个更大元素 I
⚡ 30 秒速记
- 核心套路:逆序扫描基准数组,用单调递减栈找到每个值右侧第一个更大元素,再用 Map 查询。
- 复杂度:时间 O(m+n),空间 O(n)。
- 易错边界:该题版本假设元素唯一;有重复值时 Map 必须改为按下标记录。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「下一个更大元素 I」。逆序扫描基准数组,用单调递减栈找到每个值右侧第一个更大元素,再用 Map 查询。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function nextGreaterElement(query, base) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
const next = new Map() // 初始化当前步骤需要的状态
for (let index = base.length - 1; index >= 0; index -= 1) { // 遍历仍需处理的候选状态
while (stack.length && stack.at(-1) <= base[index]) stack.pop() // 遍历仍需处理的候选状态
next.set(base[index], stack.at(-1) ?? -1) // 执行当前语句
stack.push(base[index]) // 执行当前语句
} // 结束当前代码块
return query.map(value => next.get(value)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(m+n),空间 O(n)。
- 示例:nums1=[4,1,2]、nums2=[1,3,4,2] 得到 [-1,3,-1]。
- 易错点:该题版本假设元素唯一;有重复值时 Map 必须改为按下标记录。
💬 面试官追问
- 为什么选择这个解法? 逆序扫描基准数组,用单调递减栈找到每个值右侧第一个更大元素,再用 Map 查询。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:该题版本假设元素唯一;有重复值时 Map 必须改为按下标记录。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 71 下一个更大元素 II
⚡ 30 秒速记
- 核心套路:把循环数组视为长度 2n 的序列逆序扫描,只在前 n 个位置写答案。
- 复杂度:时间 O(n),空间 O(n)。
- 易错边界:栈保存候选值或下标都可以,但不能真的复制大数组造成不必要内存。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「下一个更大元素 II」。把循环数组视为长度 2n 的序列逆序扫描,只在前 n 个位置写答案。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function nextGreaterCircular(numbers) { // 定义本题的核心实现
const result = new Array(numbers.length).fill(-1) // 初始化当前步骤需要的状态
const stack = [] // 初始化当前步骤需要的状态
for (let cursor = numbers.length * 2 - 1; cursor >= 0; cursor -= 1) { // 遍历仍需处理的候选状态
const index = cursor % numbers.length // 初始化当前步骤需要的状态
while (stack.length && stack.at(-1) <= numbers[index]) stack.pop() // 遍历仍需处理的候选状态
if (cursor < numbers.length) result[index] = stack.at(-1) ?? -1 // 检查当前分支条件
stack.push(numbers[index]) // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(n)。
- 示例:[1,2,1] 得到 [2,-1,2]。
- 易错点:栈保存候选值或下标都可以,但不能真的复制大数组造成不必要内存。
💬 面试官追问
- 为什么选择这个解法? 把循环数组视为长度 2n 的序列逆序扫描,只在前 n 个位置写答案。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:栈保存候选值或下标都可以,但不能真的复制大数组造成不必要内存。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 72 四数之和
⚡ 30 秒速记
- 核心套路:排序后固定前两个数,剩余区间用左右指针寻找目标和,并在各层跳过重复值。
- 复杂度:时间 O(n³),排序外空间 O(1)。
- 易错边界:四个位置都必须不同;去重只在同一层跳过与前一个相同的选择。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「四数之和」。排序后固定前两个数,剩余区间用左右指针寻找目标和,并在各层跳过重复值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function fourSum(numbers, target) { // 定义本题的核心实现
numbers.sort((left, right) => left - right) // 执行当前语句
const result = [] // 初始化当前步骤需要的状态
for (let first = 0; first < numbers.length - 3; first += 1) { // 遍历仍需处理的候选状态
if (first && numbers[first] === numbers[first - 1]) continue // 检查当前分支条件
for (let second = first + 1; second < numbers.length - 2; second += 1) { // 遍历仍需处理的候选状态
if (second > first + 1 && numbers[second] === numbers[second - 1]) continue // 检查当前分支条件
let left = second + 1 // 初始化当前步骤需要的状态
let right = numbers.length - 1 // 初始化当前步骤需要的状态
while (left < right) { // 遍历仍需处理的候选状态
const sum = numbers[first] + numbers[second] + numbers[left] + numbers[right] // 初始化当前步骤需要的状态
if (sum === target) result.push([numbers[first], numbers[second], numbers[left], numbers[right]]) // 检查当前分支条件
if (sum <= target) left += 1 // 检查当前分支条件
if (sum >= target) right -= 1 // 检查当前分支条件
while (left < right && numbers[left] === numbers[left - 1]) left += 1 // 遍历仍需处理的候选状态
while (left < right && numbers[right] === numbers[right + 1]) right -= 1 // 遍历仍需处理的候选状态
} // 结束当前代码块
} // 结束当前代码块
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n³),排序外空间 O(1)。
- 示例:[1,0,-1,0,-2,2]、target=0 得到三组不重复四元组。
- 易错点:四个位置都必须不同;去重只在同一层跳过与前一个相同的选择。
💬 面试官追问
- 为什么选择这个解法? 排序后固定前两个数,剩余区间用左右指针寻找目标和,并在各层跳过重复值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:四个位置都必须不同;去重只在同一层跳过与前一个相同的选择。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 73 数组中的第 K 个最大元素
⚡ 30 秒速记
- 核心套路:维护容量为 k 的小顶堆,堆顶始终是当前前 k 大元素中最小的一个。
- 复杂度:时间 O(n log k),空间 O(k)。
- 易错边界:第 k 大不是排序后下标 k;k 必须位于 1 到数组长度之间。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「数组中的第 K 个最大元素」。维护容量为 k 的小顶堆,堆顶始终是当前前 k 大元素中最小的一个。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findKthLargest(numbers, k) { // 定义本题的核心实现
const heap = [] // 初始化当前步骤需要的状态
const siftUp = index => { // 初始化当前步骤需要的状态
while (index > 0) { // 遍历仍需处理的候选状态
const parent = Math.floor((index - 1) / 2) // 初始化当前步骤需要的状态
if (heap[parent] <= heap[index]) break // 检查当前分支条件
;[heap[parent], heap[index]] = [heap[index], heap[parent]] // 执行当前语句
index = parent // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
const siftDown = index => { // 初始化当前步骤需要的状态
while (index * 2 + 1 < heap.length) { // 遍历仍需处理的候选状态
let child = index * 2 + 1 // 初始化当前步骤需要的状态
if (child + 1 < heap.length && heap[child + 1] < heap[child]) child += 1 // 检查当前分支条件
if (heap[index] <= heap[child]) break // 检查当前分支条件
;[heap[index], heap[child]] = [heap[child], heap[index]] // 执行当前语句
index = child // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
for (const value of numbers) { // 遍历仍需处理的候选状态
if (heap.length < k) { // 检查当前分支条件
heap.push(value) // 执行当前语句
siftUp(heap.length - 1) // 执行当前语句
} else if (value > heap[0]) { // 进入当前逻辑分支
heap[0] = value // 执行当前语句
siftDown(0) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return heap[0] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n log k),空间 O(k)。
- 示例:[3,2,1,5,6,4]、k=2 返回 5。
- 易错点:第 k 大不是排序后下标 k;k 必须位于 1 到数组长度之间。
💬 面试官追问
- 为什么选择这个解法? 维护容量为 k 的小顶堆,堆顶始终是当前前 k 大元素中最小的一个。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:第 k 大不是排序后下标 k;k 必须位于 1 到数组长度之间。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 74 判断数组是否存在重复元素
⚡ 30 秒速记
- 核心套路:扫描时用 Set 记录已出现值,当前值已存在就立即返回 true。
- 复杂度:平均时间 O(n),空间 O(n)。
- 易错边界:Set 使用 SameValueZero,相同的 NaN 会被视为重复;对象按引用比较。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「判断数组是否存在重复元素」。扫描时用 Set 记录已出现值,当前值已存在就立即返回 true。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function containsDuplicate(numbers) { // 定义本题的核心实现
const seen = new Set() // 初始化当前步骤需要的状态
for (const value of numbers) { // 遍历仍需处理的候选状态
if (seen.has(value)) return true // 检查当前分支条件
seen.add(value) // 执行当前语句
} // 结束当前代码块
return false // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 平均时间 O(n),空间 O(n)。
- 示例:[1,2,3,1] 返回 true,[1,2,3,4] 返回 false。
- 易错点:Set 使用 SameValueZero,相同的 NaN 会被视为重复;对象按引用比较。
💬 面试官追问
- 为什么选择这个解法? 扫描时用 Set 记录已出现值,当前值已存在就立即返回 true。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:Set 使用 SameValueZero,相同的 NaN 会被视为重复;对象按引用比较。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 75 数据流中的中位数
⚡ 30 秒速记
- 核心套路:用大顶堆保存较小一半、小顶堆保存较大一半,并维持数量差不超过一。
- 复杂度:插入 O(log n),查询 O(1),空间 O(n)。
- 易错边界:偶数个元素要取两个堆顶平均值;每次插入后都要恢复两堆的大小与有序边界。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「数据流中的中位数」。用大顶堆保存较小一半、小顶堆保存较大一半,并维持数量差不超过一。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class MedianFinder { // 定义本题的核心实现
lower = [] // 执行当前语句
upper = [] // 执行当前语句
push(heap, value, compare) { // 进入当前逻辑分支
heap.push(value) // 执行当前语句
let index = heap.length - 1 // 初始化当前步骤需要的状态
while (index > 0) { // 遍历仍需处理的候选状态
const parent = Math.floor((index - 1) / 2) // 初始化当前步骤需要的状态
if (compare(heap[parent], heap[index])) break // 检查当前分支条件
;[heap[parent], heap[index]] = [heap[index], heap[parent]] // 执行当前语句
index = parent // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
pop(heap, compare) { // 进入当前逻辑分支
const root = heap[0] // 初始化当前步骤需要的状态
const tail = heap.pop() // 初始化当前步骤需要的状态
if (heap.length) { // 检查当前分支条件
heap[0] = tail // 执行当前语句
let index = 0 // 初始化当前步骤需要的状态
while (index * 2 + 1 < heap.length) { // 遍历仍需处理的候选状态
let child = index * 2 + 1 // 初始化当前步骤需要的状态
if (child + 1 < heap.length && !compare(heap[child], heap[child + 1])) child += 1 // 检查当前分支条件
if (compare(heap[index], heap[child])) break // 检查当前分支条件
;[heap[index], heap[child]] = [heap[child], heap[index]] // 执行当前语句
index = child // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return root // 返回本题要求的结果
} // 结束当前代码块
addNum(value) { // 进入当前逻辑分支
if (!this.lower.length || value <= this.lower[0]) this.push(this.lower, value, (left, right) => left >= right) // 检查当前分支条件
else this.push(this.upper, value, (left, right) => left <= right) // 处理另一种分支
if (this.lower.length > this.upper.length + 1) this.push(this.upper, this.pop(this.lower, (left, right) => left >= right), (left, right) => left <= right) // 检查当前分支条件
if (this.upper.length > this.lower.length) this.push(this.lower, this.pop(this.upper, (left, right) => left <= right), (left, right) => left >= right) // 检查当前分支条件
} // 结束当前代码块
findMedian() { // 进入当前逻辑分支
if (this.lower.length > this.upper.length) return this.lower[0] // 检查当前分支条件
return (this.lower[0] + this.upper[0]) / 2 // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 插入 O(log n),查询 O(1),空间 O(n)。
- 示例:依次加入 1、2 时中位数 1.5,再加入 3 后为 2。
- 易错点:偶数个元素要取两个堆顶平均值;每次插入后都要恢复两堆的大小与有序边界。
💬 面试官追问
- 为什么选择这个解法? 用大顶堆保存较小一半、小顶堆保存较大一半,并维持数量差不超过一。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:偶数个元素要取两个堆顶平均值;每次插入后都要恢复两堆的大小与有序边界。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 76 O(1) 插入、删除和随机访问集合
⚡ 30 秒速记
- 核心套路:数组负责随机访问,Map 保存值到数组下标;删除时用末元素覆盖待删位置。
- 复杂度:插入、删除、随机读取平均 O(1),空间 O(n)。
- 易错边界:覆盖后必须同步更新末元素的 Map 下标;空集合随机读取的契约要明确。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「O(1) 插入、删除和随机访问集合」。数组负责随机访问,Map 保存值到数组下标;删除时用末元素覆盖待删位置。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class RandomizedSet { // 定义本题的核心实现
values = [] // 执行当前语句
indexes = new Map() // 执行当前语句
insert(value) { // 进入当前逻辑分支
if (this.indexes.has(value)) return false // 检查当前分支条件
this.indexes.set(value, this.values.length) // 执行当前语句
this.values.push(value) // 执行当前语句
return true // 返回本题要求的结果
} // 结束当前代码块
remove(value) { // 进入当前逻辑分支
if (!this.indexes.has(value)) return false // 检查当前分支条件
const index = this.indexes.get(value) // 初始化当前步骤需要的状态
const last = this.values.at(-1) // 初始化当前步骤需要的状态
this.values[index] = last // 执行当前语句
this.indexes.set(last, index) // 执行当前语句
this.values.pop() // 执行当前语句
this.indexes.delete(value) // 执行当前语句
return true // 返回本题要求的结果
} // 结束当前代码块
getRandom() { // 进入当前逻辑分支
return this.values[Math.floor(Math.random() * this.values.length)] // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 插入、删除、随机读取平均 O(1),空间 O(n)。
- 示例:insert(1)、insert(2)、remove(1) 后随机结果只能是 2。
- 易错点:覆盖后必须同步更新末元素的 Map 下标;空集合随机读取的契约要明确。
💬 面试官追问
- 为什么选择这个解法? 数组负责随机访问,Map 保存值到数组下标;删除时用末元素覆盖待删位置。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:覆盖后必须同步更新末元素的 Map 下标;空集合随机读取的契约要明确。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 77 Fisher-Yates 等概率打乱数组
⚡ 30 秒速记
- 核心套路:从末尾向前,为每个位置在未确定区间内等概率选择一个元素交换。
- 复杂度:时间 O(n),原地版空间 O(1)。
- 易错边界:随机下标必须包含当前位置;用 sort(() => Math.random()-0.5) 不等概率。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「Fisher-Yates 等概率打乱数组」。从末尾向前,为每个位置在未确定区间内等概率选择一个元素交换。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function shuffle(values, random = Math.random) { // 定义本题的核心实现
const result = [...values] // 初始化当前步骤需要的状态
for (let index = result.length - 1; index > 0; index -= 1) { // 遍历仍需处理的候选状态
const selected = Math.floor(random() * (index + 1)) // 初始化当前步骤需要的状态
;[result[index], result[selected]] = [result[selected], result[index]] // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),原地版空间 O(1)。
- 示例:[1,2,3] 的六种排列应具有相同理论概率。
- 易错点:随机下标必须包含当前位置;用 sort(() => Math.random()-0.5) 不等概率。
💬 面试官追问
- 为什么选择这个解法? 从末尾向前,为每个位置在未确定区间内等概率选择一个元素交换。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:随机下标必须包含当前位置;用 sort(() => Math.random()-0.5) 不等概率。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 78 LFU 缓存
⚡ 30 秒速记
- 核心套路:Map 定位节点,频次桶维护同频次内的 LRU 顺序,同时记录当前最小频次。
- 复杂度:get/put 平均 O(1),空间 O(capacity)。
- 易错边界:容量为零直接忽略写入;同频次淘汰最久未使用者,提升频次后可能更新 minFreq。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「LFU 缓存」。Map 定位节点,频次桶维护同频次内的 LRU 顺序,同时记录当前最小频次。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
class LFUCache { // 定义本题的核心实现
constructor(capacity) { // 进入当前逻辑分支
this.capacity = capacity // 执行当前语句
this.minimumFrequency = 0 // 执行当前语句
this.items = new Map() // 执行当前语句
this.buckets = new Map() // 执行当前语句
} // 结束当前代码块
touch(key) { // 进入当前逻辑分支
const item = this.items.get(key) // 初始化当前步骤需要的状态
const bucket = this.buckets.get(item.frequency) // 初始化当前步骤需要的状态
bucket.delete(key) // 执行当前语句
if (!bucket.size) { // 检查当前分支条件
this.buckets.delete(item.frequency) // 执行当前语句
if (this.minimumFrequency === item.frequency) this.minimumFrequency += 1 // 检查当前分支条件
} // 结束当前代码块
item.frequency += 1 // 执行当前语句
if (!this.buckets.has(item.frequency)) this.buckets.set(item.frequency, new Map()) // 检查当前分支条件
this.buckets.get(item.frequency).set(key, true) // 执行当前语句
} // 结束当前代码块
get(key) { // 进入当前逻辑分支
const item = this.items.get(key) // 初始化当前步骤需要的状态
if (!item) return -1 // 检查当前分支条件
this.touch(key) // 执行当前语句
return item.value // 返回本题要求的结果
} // 结束当前代码块
put(key, value) { // 进入当前逻辑分支
if (!this.capacity) return // 检查当前分支条件
if (this.items.has(key)) { // 检查当前分支条件
this.items.get(key).value = value // 执行当前语句
this.touch(key) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
if (this.items.size === this.capacity) { // 检查当前分支条件
const bucket = this.buckets.get(this.minimumFrequency) // 初始化当前步骤需要的状态
const victim = bucket.keys().next().value // 初始化当前步骤需要的状态
bucket.delete(victim) // 执行当前语句
this.items.delete(victim) // 执行当前语句
} // 结束当前代码块
this.minimumFrequency = 1 // 执行当前语句
this.items.set(key, { value, frequency: 1 }) // 执行当前语句
if (!this.buckets.has(1)) this.buckets.set(1, new Map()) // 检查当前分支条件
this.buckets.get(1).set(key, true) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- get/put 平均 O(1),空间 O(capacity)。
- 示例:容量 2,put(1)、put(2)、get(1)、put(3) 应淘汰键 2。
- 易错点:容量为零直接忽略写入;同频次淘汰最久未使用者,提升频次后可能更新 minFreq。
💬 面试官追问
- 为什么选择这个解法? Map 定位节点,频次桶维护同频次内的 LRU 顺序,同时记录当前最小频次。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:容量为零直接忽略写入;同频次淘汰最久未使用者,提升频次后可能更新 minFreq。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 79 电话号码的字母组合
⚡ 30 秒速记
- 核心套路:按数字位置回溯,每层选择该数字映射的一个字母,路径长度等于数字长度时收集。
- 复杂度:时间 O(4^n·n),递归栈 O(n)。
- 易错边界:空输入应返回空数组;数字 0 和 1 没有常规字母映射。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「电话号码的字母组合」。按数字位置回溯,每层选择该数字映射的一个字母,路径长度等于数字长度时收集。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function letterCombinations(digits) { // 定义本题的核心实现
if (!digits) return [] // 检查当前分支条件
const map = { 2: 'abc', 3: 'def', 4: 'ghi', 5: 'jkl', 6: 'mno', 7: 'pqrs', 8: 'tuv', 9: 'wxyz' } // 初始化当前步骤需要的状态
const result = [] // 初始化当前步骤需要的状态
const search = (index, path) => { // 初始化当前步骤需要的状态
if (index === digits.length) { // 检查当前分支条件
result.push(path) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (const letter of map[digits[index]]) search(index + 1, path + letter) // 遍历仍需处理的候选状态
} // 结束当前代码块
search(0, '') // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(4^n·n),递归栈 O(n)。
- 示例:输入 23 得到 ad、ae、af、bd、be、bf、cd、ce、cf。
- 易错点:空输入应返回空数组;数字 0 和 1 没有常规字母映射。
💬 面试官追问
- 为什么选择这个解法? 按数字位置回溯,每层选择该数字映射的一个字母,路径长度等于数字长度时收集。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:空输入应返回空数组;数字 0 和 1 没有常规字母映射。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 80 组合
⚡ 30 秒速记
- 核心套路:回溯选择递增数字,下一层从当前数字加一开始,天然避免重复排列。
- 复杂度:时间 O(C(n,k)·k),递归栈 O(k)。
- 易错边界:循环上界可根据还需选择的数量剪枝,否则会进入不可能完成的分支。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「组合」。回溯选择递增数字,下一层从当前数字加一开始,天然避免重复排列。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function combine(n, k) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const search = start => { // 初始化当前步骤需要的状态
if (path.length === k) { // 检查当前分支条件
result.push([...path]) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
const remaining = k - path.length // 初始化当前步骤需要的状态
for (let value = start; value <= n - remaining + 1; value += 1) { // 遍历仍需处理的候选状态
path.push(value) // 执行当前语句
search(value + 1) // 执行当前语句
path.pop() // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(1) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(C(n,k)·k),递归栈 O(k)。
- 示例:n=4、k=2 得到 6 个组合。
- 易错点:循环上界可根据还需选择的数量剪枝,否则会进入不可能完成的分支。
💬 面试官追问
- 为什么选择这个解法? 回溯选择递增数字,下一层从当前数字加一开始,天然避免重复排列。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:循环上界可根据还需选择的数量剪枝,否则会进入不可能完成的分支。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 81 含重复元素的全排列
⚡ 30 秒速记
- 核心套路:先排序,回溯时用 used 标记下标,并跳过同层中前一个尚未使用的相同值。
- 复杂度:最坏时间 O(n!·n),空间 O(n)。
- 易错边界:去重条件是 !used[index-1],写反会错误剪掉跨层合法选择。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「含重复元素的全排列」。先排序,回溯时用 used 标记下标,并跳过同层中前一个尚未使用的相同值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function permuteUnique(numbers) { // 定义本题的核心实现
numbers.sort((left, right) => left - right) // 执行当前语句
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const used = new Array(numbers.length).fill(false) // 初始化当前步骤需要的状态
const search = () => { // 初始化当前步骤需要的状态
if (path.length === numbers.length) { // 检查当前分支条件
result.push([...path]) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (let index = 0; index < numbers.length; index += 1) { // 遍历仍需处理的候选状态
if (used[index]) continue // 检查当前分支条件
if (index && numbers[index] === numbers[index - 1] && !used[index - 1]) continue // 检查当前分支条件
used[index] = true // 执行当前语句
path.push(numbers[index]) // 执行当前语句
search() // 执行当前语句
path.pop() // 执行当前语句
used[index] = false // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search() // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏时间 O(n!·n),空间 O(n)。
- 示例:[1,1,2] 得到三种不重复排列。
- 易错点:去重条件是 !used[index-1],写反会错误剪掉跨层合法选择。
💬 面试官追问
- 为什么选择这个解法? 先排序,回溯时用 used 标记下标,并跳过同层中前一个尚未使用的相同值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:去重条件是 !used[index-1],写反会错误剪掉跨层合法选择。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 82 复原 IP 地址
⚡ 30 秒速记
- 核心套路:回溯切出恰好四段,每段长度 1 到 3,并立即校验前导零与数值范围。
- 复杂度:搜索空间有固定上界,额外空间 O(1)。
- 易错边界:0 可以单独成段,01 不合法;剩余字符数应与剩余段数一起剪枝。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「复原 IP 地址」。回溯切出恰好四段,每段长度 1 到 3,并立即校验前导零与数值范围。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function restoreIpAddresses(text) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const parts = [] // 初始化当前步骤需要的状态
const search = start => { // 初始化当前步骤需要的状态
if (parts.length === 4) { // 检查当前分支条件
if (start === text.length) result.push(parts.join('.')) // 检查当前分支条件
return // 执行当前语句
} // 结束当前代码块
for (let end = start; end < Math.min(start + 3, text.length); end += 1) { // 遍历仍需处理的候选状态
const part = text.slice(start, end + 1) // 初始化当前步骤需要的状态
if (part.length > 1 && part[0] === '0') break // 检查当前分支条件
if (Number(part) > 255) break // 检查当前分支条件
parts.push(part) // 执行当前语句
search(end + 1) // 执行当前语句
parts.pop() // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(0) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 搜索空间有固定上界,额外空间 O(1)。
- 示例:25525511135 得到 255.255.11.135 和 255.255.111.35。
- 易错点:0 可以单独成段,01 不合法;剩余字符数应与剩余段数一起剪枝。
💬 面试官追问
- 为什么选择这个解法? 回溯切出恰好四段,每段长度 1 到 3,并立即校验前导零与数值范围。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:0 可以单独成段,01 不合法;剩余字符数应与剩余段数一起剪枝。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 83 分割回文串
⚡ 30 秒速记
- 核心套路:从当前位置枚举结束位置,只有当前片段为回文时才继续递归。
- 复杂度:最坏时间 O(n·2^n),递归栈 O(n)。
- 易错边界:收集答案时必须复制 path;可预处理回文表减少重复判断。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「分割回文串」。从当前位置枚举结束位置,只有当前片段为回文时才继续递归。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function partitionPalindrome(text) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const palindrome = value => value === [...value].reverse().join('') // 初始化当前步骤需要的状态
const search = start => { // 初始化当前步骤需要的状态
if (start === text.length) { // 检查当前分支条件
result.push([...path]) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (let end = start + 1; end <= text.length; end += 1) { // 遍历仍需处理的候选状态
const part = text.slice(start, end) // 初始化当前步骤需要的状态
if (!palindrome(part)) continue // 检查当前分支条件
path.push(part) // 执行当前语句
search(end) // 执行当前语句
path.pop() // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(0) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏时间 O(n·2^n),递归栈 O(n)。
- 示例:aab 得到 [a,a,b] 和 [aa,b]。
- 易错点:收集答案时必须复制 path;可预处理回文表减少重复判断。
💬 面试官追问
- 为什么选择这个解法? 从当前位置枚举结束位置,只有当前片段为回文时才继续递归。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:收集答案时必须复制 path;可预处理回文表减少重复判断。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 84 N 皇后
⚡ 30 秒速记
- 核心套路:逐行放置皇后,用列、主对角线和副对角线集合 O(1) 判断冲突。
- 复杂度:上界 O(n!),空间 O(n)。
- 易错边界:对角线可分别用 row-column 与 row+column 标识;回溯时三组状态都要撤销。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「N 皇后」。逐行放置皇后,用列、主对角线和副对角线集合 O(1) 判断冲突。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function solveNQueens(n) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const board = new Array(n).fill(-1) // 初始化当前步骤需要的状态
const columns = new Set() // 初始化当前步骤需要的状态
const diagonalsA = new Set() // 初始化当前步骤需要的状态
const diagonalsB = new Set() // 初始化当前步骤需要的状态
const search = row => { // 初始化当前步骤需要的状态
if (row === n) { // 检查当前分支条件
result.push(board.map(column => '.'.repeat(column) + 'Q' + '.'.repeat(n - column - 1))) // 执行当前语句
return // 执行当前语句
} // 结束当前代码块
for (let column = 0; column < n; column += 1) { // 遍历仍需处理的候选状态
if (columns.has(column) || diagonalsA.has(row - column) || diagonalsB.has(row + column)) continue // 检查当前分支条件
board[row] = column // 执行当前语句
columns.add(column) // 执行当前语句
diagonalsA.add(row - column) // 执行当前语句
diagonalsB.add(row + column) // 执行当前语句
search(row + 1) // 执行当前语句
columns.delete(column) // 执行当前语句
diagonalsA.delete(row - column) // 执行当前语句
diagonalsB.delete(row + column) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
search(0) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 上界 O(n!),空间 O(n)。
- 示例:n=4 有两种合法棋盘。
- 易错点:对角线可分别用 row-column 与 row+column 标识;回溯时三组状态都要撤销。
💬 面试官追问
- 为什么选择这个解法? 逐行放置皇后,用列、主对角线和副对角线集合 O(1) 判断冲突。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:对角线可分别用 row-column 与 row+column 标识;回溯时三组状态都要撤销。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 85 解数独
⚡ 30 秒速记
- 核心套路:找到下一个空格,尝试 1 到 9;候选同时满足行、列和九宫格约束才递归。
- 复杂度:最坏指数级,空间最多 O(空格数)。
- 易错边界:找到完整解后要向上传递 true 提前停止;回溯必须把格子恢复为点。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「解数独」。找到下一个空格,尝试 1 到 9;候选同时满足行、列和九宫格约束才递归。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function solveSudoku(board) { // 定义本题的核心实现
const valid = (row, column, value) => { // 初始化当前步骤需要的状态
for (let index = 0; index < 9; index += 1) { // 遍历仍需处理的候选状态
if (board[row][index] === value || board[index][column] === value) return false // 检查当前分支条件
const boxRow = Math.floor(row / 3) * 3 + Math.floor(index / 3) // 初始化当前步骤需要的状态
const boxColumn = Math.floor(column / 3) * 3 + index % 3 // 初始化当前步骤需要的状态
if (board[boxRow][boxColumn] === value) return false // 检查当前分支条件
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
const search = () => { // 初始化当前步骤需要的状态
for (let row = 0; row < 9; row += 1) { // 遍历仍需处理的候选状态
for (let column = 0; column < 9; column += 1) { // 遍历仍需处理的候选状态
if (board[row][column] !== '.') continue // 检查当前分支条件
for (let value = 1; value <= 9; value += 1) { // 遍历仍需处理的候选状态
const token = String(value) // 初始化当前步骤需要的状态
if (!valid(row, column, token)) continue // 检查当前分支条件
board[row][column] = token // 执行当前语句
if (search()) return true // 检查当前分支条件
board[row][column] = '.' // 执行当前语句
} // 结束当前代码块
return false // 返回本题要求的结果
} // 结束当前代码块
} // 结束当前代码块
return true // 返回本题要求的结果
} // 结束当前代码块
search() // 执行当前语句
return board // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏指数级,空间最多 O(空格数)。
- 示例:标准 9×9 棋盘原地填充为唯一合法解。
- 易错点:找到完整解后要向上传递 true 提前停止;回溯必须把格子恢复为点。
💬 面试官追问
- 为什么选择这个解法? 找到下一个空格,尝试 1 到 9;候选同时满足行、列和九宫格约束才递归。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:找到完整解后要向上传递 true 提前停止;回溯必须把格子恢复为点。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 86 最长公共子序列
⚡ 30 秒速记
- 核心套路:二维 DP 表示两个前缀的最长公共子序列长度,相等取左上加一,否则取上与左较大值。
- 复杂度:时间 O(mn),空间 O(mn),可压缩为 O(n)。
- 易错边界:子序列不要求连续;行列要多开一格表达空前缀。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「最长公共子序列」。二维 DP 表示两个前缀的最长公共子序列长度,相等取左上加一,否则取上与左较大值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function longestCommonSubsequence(left, right) { // 定义本题的核心实现
const dp = Array.from({ length: left.length + 1 }, () => new Array(right.length + 1).fill(0)) // 初始化当前步骤需要的状态
for (let row = 1; row <= left.length; row += 1) { // 遍历仍需处理的候选状态
for (let column = 1; column <= right.length; column += 1) { // 遍历仍需处理的候选状态
if (left[row - 1] === right[column - 1]) dp[row][column] = dp[row - 1][column - 1] + 1 // 检查当前分支条件
else dp[row][column] = Math.max(dp[row - 1][column], dp[row][column - 1]) // 处理另一种分支
} // 结束当前代码块
} // 结束当前代码块
return dp[left.length][right.length] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(mn),可压缩为 O(n)。
- 示例:abcde 与 ace 的最长公共子序列长度为 3。
- 易错点:子序列不要求连续;行列要多开一格表达空前缀。
💬 面试官追问
- 为什么选择这个解法? 二维 DP 表示两个前缀的最长公共子序列长度,相等取左上加一,否则取上与左较大值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:子序列不要求连续;行列要多开一格表达空前缀。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 87 编辑距离
⚡ 30 秒速记
- 核心套路:dp[i][j] 表示两个前缀的最少操作数,字符不同时从删除、插入、替换三种来源取最小值加一。
- 复杂度:时间 O(mn),空间 O(mn)。
- 易错边界:首行首列分别表示把字符串变为空串所需的连续删除或插入次数。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「编辑距离」。dp[i][j] 表示两个前缀的最少操作数,字符不同时从删除、插入、替换三种来源取最小值加一。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function editDistance(source, target) { // 定义本题的核心实现
const dp = Array.from({ length: source.length + 1 }, (_, row) => new Array(target.length + 1).fill(0).map((value, column) => row ? value : column)) // 初始化当前步骤需要的状态
for (let row = 1; row <= source.length; row += 1) { // 遍历仍需处理的候选状态
dp[row][0] = row // 执行当前语句
for (let column = 1; column <= target.length; column += 1) { // 遍历仍需处理的候选状态
if (source[row - 1] === target[column - 1]) dp[row][column] = dp[row - 1][column - 1] // 检查当前分支条件
else dp[row][column] = 1 + Math.min(dp[row - 1][column], dp[row][column - 1], dp[row - 1][column - 1]) // 处理另一种分支
} // 结束当前代码块
} // 结束当前代码块
return dp[source.length][target.length] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(mn)。
- 示例:horse 转换为 ros 的编辑距离为 3。
- 易错点:首行首列分别表示把字符串变为空串所需的连续删除或插入次数。
💬 面试官追问
- 为什么选择这个解法? dp[i][j] 表示两个前缀的最少操作数,字符不同时从删除、插入、替换三种来源取最小值加一。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:首行首列分别表示把字符串变为空串所需的连续删除或插入次数。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 88 不同路径
⚡ 30 秒速记
- 核心套路:一维 DP 从左到右累加,dp[column] 同时代表来自上方的路径数,更新后代表上方加左方。
- 复杂度:时间 O(mn),空间 O(n)。
- 易错边界:第一行和第一列只有一种走法;组合公式可能溢出 Number 安全整数。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「不同路径」。一维 DP 从左到右累加,dp[column] 同时代表来自上方的路径数,更新后代表上方加左方。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function uniquePaths(rows, columns) { // 定义本题的核心实现
const dp = new Array(columns).fill(1) // 初始化当前步骤需要的状态
for (let row = 1; row < rows; row += 1) { // 遍历仍需处理的候选状态
for (let column = 1; column < columns; column += 1) { // 遍历仍需处理的候选状态
dp[column] += dp[column - 1] // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return dp[columns - 1] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(n)。
- 示例:3×7 网格共有 28 条不同路径。
- 易错点:第一行和第一列只有一种走法;组合公式可能溢出 Number 安全整数。
💬 面试官追问
- 为什么选择这个解法? 一维 DP 从左到右累加,dp[column] 同时代表来自上方的路径数,更新后代表上方加左方。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:第一行和第一列只有一种走法;组合公式可能溢出 Number 安全整数。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 89 带障碍物的不同路径
⚡ 30 秒速记
- 核心套路:一维 DP 扫描网格,障碍格清零,普通格累加左侧路径数。
- 复杂度:时间 O(mn),空间 O(n)。
- 易错边界:起点或终点是障碍时结果为零;障碍后同一行的状态不能沿用旧值。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「带障碍物的不同路径」。一维 DP 扫描网格,障碍格清零,普通格累加左侧路径数。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function uniquePathsWithObstacles(grid) { // 定义本题的核心实现
const dp = new Array(grid[0].length).fill(0) // 初始化当前步骤需要的状态
dp[0] = grid[0][0] ? 0 : 1 // 执行当前语句
for (const row of grid) { // 遍历仍需处理的候选状态
for (let column = 0; column < row.length; column += 1) { // 遍历仍需处理的候选状态
if (row[column]) dp[column] = 0 // 检查当前分支条件
else if (column) dp[column] += dp[column - 1] // 处理另一种分支
} // 结束当前代码块
} // 结束当前代码块
return dp.at(-1) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(n)。
- 示例:3×3 中央有障碍时共有 2 条路径。
- 易错点:起点或终点是障碍时结果为零;障碍后同一行的状态不能沿用旧值。
💬 面试官追问
- 为什么选择这个解法? 一维 DP 扫描网格,障碍格清零,普通格累加左侧路径数。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:起点或终点是障碍时结果为零;障碍后同一行的状态不能沿用旧值。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 90 判断子序列
⚡ 30 秒速记
- 核心套路:用一个指针扫描待匹配串,另一个指针扫描原串,字符相等时才推进待匹配指针。
- 复杂度:时间 O(m+n),空间 O(1)。
- 易错边界:子序列保持相对顺序但不要求连续;空待匹配串永远是子序列。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「判断子序列」。用一个指针扫描待匹配串,另一个指针扫描原串,字符相等时才推进待匹配指针。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isSubsequence(candidate, source) { // 定义本题的核心实现
let matched = 0 // 初始化当前步骤需要的状态
for (const character of source) { // 遍历仍需处理的候选状态
if (character === candidate[matched]) matched += 1 // 检查当前分支条件
if (matched === candidate.length) return true // 检查当前分支条件
} // 结束当前代码块
return matched === candidate.length // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(m+n),空间 O(1)。
- 示例:abc 是 ahbgdc 的子序列,axc 不是。
- 易错点:子序列保持相对顺序但不要求连续;空待匹配串永远是子序列。
💬 面试官追问
- 为什么选择这个解法? 用一个指针扫描待匹配串,另一个指针扫描原串,字符相等时才推进待匹配指针。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:子序列保持相对顺序但不要求连续;空待匹配串永远是子序列。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 91 不同的子序列数量
⚡ 30 秒速记
- 核心套路:dp[j] 表示当前源串前缀组成目标前 j 个字符的方案数,逆序更新避免重复使用当前字符。
- 复杂度:时间 O(mn),空间 O(n)。
- 易错边界:dp[0] 必须为 1;一维压缩时必须从右向左更新。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「不同的子序列数量」。dp[j] 表示当前源串前缀组成目标前 j 个字符的方案数,逆序更新避免重复使用当前字符。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function countDistinctSubsequences(source, target) { // 定义本题的核心实现
const dp = new Array(target.length + 1).fill(0) // 初始化当前步骤需要的状态
dp[0] = 1 // 执行当前语句
for (const sourceCharacter of source) { // 遍历仍需处理的候选状态
for (let index = target.length; index > 0; index -= 1) { // 遍历仍需处理的候选状态
if (sourceCharacter === target[index - 1]) dp[index] += dp[index - 1] // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
return dp[target.length] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(mn),空间 O(n)。
- 示例:rabbbit 组成 rabbit 有 3 种方式。
- 易错点:dp[0] 必须为 1;一维压缩时必须从右向左更新。
💬 面试官追问
- 为什么选择这个解法? dp[j] 表示当前源串前缀组成目标前 j 个字符的方案数,逆序更新避免重复使用当前字符。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:dp[0] 必须为 1;一维压缩时必须从右向左更新。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 92 零钱兑换 II
⚡ 30 秒速记
- 核心套路:外层遍历硬币、内层正序遍历金额,让每种组合只按固定硬币顺序生成一次。
- 复杂度:时间 O(amount·n),空间 O(amount)。
- 易错边界:外层与内层顺序决定统计组合还是排列;dp[0] 必须初始化为 1。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「零钱兑换 II」。外层遍历硬币、内层正序遍历金额,让每种组合只按固定硬币顺序生成一次。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function coinChangeCombinations(amount, coins) { // 定义本题的核心实现
const dp = new Array(amount + 1).fill(0) // 初始化当前步骤需要的状态
dp[0] = 1 // 执行当前语句
for (const coin of coins) { // 遍历仍需处理的候选状态
for (let value = coin; value <= amount; value += 1) { // 遍历仍需处理的候选状态
dp[value] += dp[value - coin] // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
return dp[amount] // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(amount·n),空间 O(amount)。
- 示例:amount=5、coins=[1,2,5] 有 4 种组合。
- 易错点:外层与内层顺序决定统计组合还是排列;dp[0] 必须初始化为 1。
💬 面试官追问
- 为什么选择这个解法? 外层遍历硬币、内层正序遍历金额,让每种组合只按固定硬币顺序生成一次。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:外层与内层顺序决定统计组合还是排列;dp[0] 必须初始化为 1。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 93 使用最小花费爬楼梯
⚡ 30 秒速记
- 核心套路:滚动保存到达前两级台阶的最低花费,当前状态取两种来源的较小值。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:可以从第 0 或第 1 级起步,目标是楼顶而不是最后一阶本身。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「使用最小花费爬楼梯」。滚动保存到达前两级台阶的最低花费,当前状态取两种来源的较小值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minCostClimbingStairs(costs) { // 定义本题的核心实现
let twoBack = 0 // 初始化当前步骤需要的状态
let oneBack = 0 // 初始化当前步骤需要的状态
for (let level = 2; level <= costs.length; level += 1) { // 遍历仍需处理的候选状态
const current = Math.min(oneBack + costs[level - 1], twoBack + costs[level - 2]) // 初始化当前步骤需要的状态
twoBack = oneBack // 执行当前语句
oneBack = current // 执行当前语句
} // 结束当前代码块
return oneBack // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[10,15,20] 的最低花费为 15。
- 易错点:可以从第 0 或第 1 级起步,目标是楼顶而不是最后一阶本身。
💬 面试官追问
- 为什么选择这个解法? 滚动保存到达前两级台阶的最低花费,当前状态取两种来源的较小值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:可以从第 0 或第 1 级起步,目标是楼顶而不是最后一阶本身。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 94 环形房屋打家劫舍
⚡ 30 秒速记
- 核心套路:首尾不能同时选择,把问题拆成不含首项与不含尾项的两个线性打家劫舍。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:单个房屋需要直接返回;切片会产生 O(n) 空间,可改为传索引区间。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「环形房屋打家劫舍」。首尾不能同时选择,把问题拆成不含首项与不含尾项的两个线性打家劫舍。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function robCircular(houses) { // 定义本题的核心实现
if (houses.length === 1) return houses[0] // 检查当前分支条件
const solve = (start, end) => { // 初始化当前步骤需要的状态
let previous = 0 // 初始化当前步骤需要的状态
let current = 0 // 初始化当前步骤需要的状态
for (let index = start; index < end; index += 1) { // 遍历仍需处理的候选状态
;[previous, current] = [current, Math.max(current, previous + houses[index])] // 执行当前语句
} // 结束当前代码块
return current // 返回本题要求的结果
} // 结束当前代码块
return Math.max(solve(0, houses.length - 1), solve(1, houses.length)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[2,3,2] 返回 3,[1,2,3,1] 返回 4。
- 易错点:单个房屋需要直接返回;切片会产生 O(n) 空间,可改为传索引区间。
💬 面试官追问
- 为什么选择这个解法? 首尾不能同时选择,把问题拆成不含首项与不含尾项的两个线性打家劫舍。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:单个房屋需要直接返回;切片会产生 O(n) 空间,可改为传索引区间。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 95 二叉树打家劫舍
⚡ 30 秒速记
- 核心套路:后序遍历每个节点,同时返回“不偷当前节点”和“偷当前节点”两种最优值。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:不能只做奇偶层求和;最优选择取决于每棵子树的局部结构。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树打家劫舍」。后序遍历每个节点,同时返回“不偷当前节点”和“偷当前节点”两种最优值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function robTree(root) { // 定义本题的核心实现
const visit = node => { // 初始化当前步骤需要的状态
if (!node) return [0, 0] // 检查当前分支条件
const left = visit(node.left) // 初始化当前步骤需要的状态
const right = visit(node.right) // 初始化当前步骤需要的状态
const skip = Math.max(...left) + Math.max(...right) // 初始化当前步骤需要的状态
const take = node.value + left[0] + right[0] // 初始化当前步骤需要的状态
return [skip, take] // 返回本题要求的结果
} // 结束当前代码块
return Math.max(...visit(root)) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[3,2,3,null,3,null,1] 的最大收益为 7。
- 易错点:不能只做奇偶层求和;最优选择取决于每棵子树的局部结构。
💬 面试官追问
- 为什么选择这个解法? 后序遍历每个节点,同时返回“不偷当前节点”和“偷当前节点”两种最优值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:不能只做奇偶层求和;最优选择取决于每棵子树的局部结构。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 96 买卖股票的最佳时机 II
⚡ 30 秒速记
- 核心套路:允许多次交易时累加所有相邻上涨差值,等价于每天结束都持有局部最优状态。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:同一天不能同时持有多份股票,但卖出后可再次买入;不需要寻找全局最低点。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「买卖股票的最佳时机 II」。允许多次交易时累加所有相邻上涨差值,等价于每天结束都持有局部最优状态。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function maxProfitUnlimited(prices) { // 定义本题的核心实现
let profit = 0 // 初始化当前步骤需要的状态
for (let day = 1; day < prices.length; day += 1) { // 遍历仍需处理的候选状态
profit += Math.max(0, prices[day] - prices[day - 1]) // 执行当前语句
} // 结束当前代码块
return profit // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[7,1,5,3,6,4] 最大利润为 7。
- 易错点:同一天不能同时持有多份股票,但卖出后可再次买入;不需要寻找全局最低点。
💬 面试官追问
- 为什么选择这个解法? 允许多次交易时累加所有相邻上涨差值,等价于每天结束都持有局部最优状态。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:同一天不能同时持有多份股票,但卖出后可再次买入;不需要寻找全局最低点。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 97 最多两次买卖股票
⚡ 30 秒速记
- 核心套路:维护第一次买入、第一次卖出、第二次买入、第二次卖出四个状态并按天更新。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:状态更新顺序要保持同一天转移语义一致;少于两次交易也应被允许。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「最多两次买卖股票」。维护第一次买入、第一次卖出、第二次买入、第二次卖出四个状态并按天更新。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function maxProfitTwice(prices) { // 定义本题的核心实现
let firstBuy = -Infinity // 初始化当前步骤需要的状态
let firstSell = 0 // 初始化当前步骤需要的状态
let secondBuy = -Infinity // 初始化当前步骤需要的状态
let secondSell = 0 // 初始化当前步骤需要的状态
for (const price of prices) { // 遍历仍需处理的候选状态
firstBuy = Math.max(firstBuy, -price) // 执行当前语句
firstSell = Math.max(firstSell, firstBuy + price) // 执行当前语句
secondBuy = Math.max(secondBuy, firstSell - price) // 执行当前语句
secondSell = Math.max(secondSell, secondBuy + price) // 执行当前语句
} // 结束当前代码块
return secondSell // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[3,3,5,0,0,3,1,4] 最大利润为 6。
- 易错点:状态更新顺序要保持同一天转移语义一致;少于两次交易也应被允许。
💬 面试官追问
- 为什么选择这个解法? 维护第一次买入、第一次卖出、第二次买入、第二次卖出四个状态并按天更新。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:状态更新顺序要保持同一天转移语义一致;少于两次交易也应被允许。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 98 含手续费的股票买卖
⚡ 30 秒速记
- 核心套路:维护持有与空仓两种状态,在卖出转移时统一扣除手续费。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:手续费只能扣一次;更新持有状态时要使用更新前的 cash。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「含手续费的股票买卖」。维护持有与空仓两种状态,在卖出转移时统一扣除手续费。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function maxProfitWithFee(prices, fee) { // 定义本题的核心实现
let hold = -Infinity // 初始化当前步骤需要的状态
let cash = 0 // 初始化当前步骤需要的状态
for (const price of prices) { // 遍历仍需处理的候选状态
const previousCash = cash // 初始化当前步骤需要的状态
cash = Math.max(cash, hold + price - fee) // 执行当前语句
hold = Math.max(hold, previousCash - price) // 执行当前语句
} // 结束当前代码块
return cash // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[1,3,2,8,4,9]、fee=2 的最大利润为 8。
- 易错点:手续费只能扣一次;更新持有状态时要使用更新前的 cash。
💬 面试官追问
- 为什么选择这个解法? 维护持有与空仓两种状态,在卖出转移时统一扣除手续费。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:手续费只能扣一次;更新持有状态时要使用更新前的 cash。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 99 最长连续递增子序列
⚡ 30 秒速记
- 核心套路:线性扫描并维护以当前位置结尾的连续递增长度,断开时重置为一。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:它要求连续,不能使用普通 LIS 的二分尾数组替代题意。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「最长连续递增子序列」。线性扫描并维护以当前位置结尾的连续递增长度,断开时重置为一。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findLengthOfLcis(numbers) { // 定义本题的核心实现
if (!numbers.length) return 0 // 检查当前分支条件
let current = 1 // 初始化当前步骤需要的状态
let best = 1 // 初始化当前步骤需要的状态
for (let index = 1; index < numbers.length; index += 1) { // 遍历仍需处理的候选状态
current = numbers[index] > numbers[index - 1] ? current + 1 : 1 // 执行当前语句
best = Math.max(best, current) // 执行当前语句
} // 结束当前代码块
return best // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[1,3,5,4,7] 的最长连续递增长度为 3。
- 易错点:它要求连续,不能使用普通 LIS 的二分尾数组替代题意。
💬 面试官追问
- 为什么选择这个解法? 线性扫描并维护以当前位置结尾的连续递增长度,断开时重置为一。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:它要求连续,不能使用普通 LIS 的二分尾数组替代题意。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 100 斐波那契数
⚡ 30 秒速记
- 核心套路:只保留前两项滚动计算下一项,避免递归产生大量重复子问题。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:要明确 F(0)=0、F(1)=1;大 n 会超过 Number 安全整数,应使用 BigInt。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「斐波那契数」。只保留前两项滚动计算下一项,避免递归产生大量重复子问题。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function fibonacci(n) { // 定义本题的核心实现
if (n < 2) return n // 检查当前分支条件
let previous = 0 // 初始化当前步骤需要的状态
let current = 1 // 初始化当前步骤需要的状态
for (let index = 2; index <= n; index += 1) { // 遍历仍需处理的候选状态
;[previous, current] = [current, previous + current] // 执行当前语句
} // 结束当前代码块
return current // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:F(10)=55。
- 易错点:要明确 F(0)=0、F(1)=1;大 n 会超过 Number 安全整数,应使用 BigInt。
💬 面试官追问
- 为什么选择这个解法? 只保留前两项滚动计算下一项,避免递归产生大量重复子问题。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:要明确 F(0)=0、F(1)=1;大 n 会超过 Number 安全整数,应使用 BigInt。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 101 二叉树最小深度
⚡ 30 秒速记
- 核心套路:层序遍历按层推进,第一次遇到叶子节点时当前层数就是最小深度。
- 复杂度:时间 O(n),空间 O(w)。
- 易错边界:递归时只有一个子树存在不能取 0 与其深度的最小值;叶子必须左右孩子都为空。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树最小深度」。层序遍历按层推进,第一次遇到叶子节点时当前层数就是最小深度。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function minDepth(root) { // 定义本题的核心实现
if (!root) return 0 // 检查当前分支条件
const queue = [root] // 初始化当前步骤需要的状态
for (let depth = 1; queue.length; depth += 1) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
for (let count = 0; count < size; count += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
if (!node.left && !node.right) return depth // 检查当前分支条件
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[3,9,20,null,null,15,7] 的最小深度为 2。
- 易错点:递归时只有一个子树存在不能取 0 与其深度的最小值;叶子必须左右孩子都为空。
💬 面试官追问
- 为什么选择这个解法? 层序遍历按层推进,第一次遇到叶子节点时当前层数就是最小深度。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:递归时只有一个子树存在不能取 0 与其深度的最小值;叶子必须左右孩子都为空。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 102 判断平衡二叉树
⚡ 30 秒速记
- 核心套路:后序遍历返回子树高度,发现任一子树高度差超过一就用 -1 向上短路。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:若每个节点都重新求高度会退化为 O(n²);平衡要求所有节点都满足。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「判断平衡二叉树」。后序遍历返回子树高度,发现任一子树高度差超过一就用 -1 向上短路。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isBalanced(root) { // 定义本题的核心实现
const height = node => { // 初始化当前步骤需要的状态
if (!node) return 0 // 检查当前分支条件
const left = height(node.left) // 初始化当前步骤需要的状态
if (left < 0) return -1 // 检查当前分支条件
const right = height(node.right) // 初始化当前步骤需要的状态
if (right < 0 || Math.abs(left - right) > 1) return -1 // 检查当前分支条件
return Math.max(left, right) + 1 // 返回本题要求的结果
} // 结束当前代码块
return height(root) >= 0 // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[3,9,20,null,null,15,7] 返回 true。
- 易错点:若每个节点都重新求高度会退化为 O(n²);平衡要求所有节点都满足。
💬 面试官追问
- 为什么选择这个解法? 后序遍历返回子树高度,发现任一子树高度差超过一就用 -1 向上短路。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:若每个节点都重新求高度会退化为 O(n²);平衡要求所有节点都满足。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 103 翻转二叉树
⚡ 30 秒速记
- 核心套路:递归翻转左右子树,再交换当前节点的左右孩子。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:若必须保持原树,应创建新节点而不是原地交换引用。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「翻转二叉树」。递归翻转左右子树,再交换当前节点的左右孩子。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function invertTree(root) { // 定义本题的核心实现
if (!root) return null // 检查当前分支条件
const left = invertTree(root.left) // 初始化当前步骤需要的状态
const right = invertTree(root.right) // 初始化当前步骤需要的状态
root.left = right // 执行当前语句
root.right = left // 执行当前语句
return root // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[4,2,7,1,3,6,9] 翻转为 [4,7,2,9,6,3,1]。
- 易错点:若必须保持原树,应创建新节点而不是原地交换引用。
💬 面试官追问
- 为什么选择这个解法? 递归翻转左右子树,再交换当前节点的左右孩子。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:若必须保持原树,应创建新节点而不是原地交换引用。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 104 判断两棵二叉树是否相同
⚡ 30 秒速记
- 核心套路:同步递归两个节点:同时为空为真,仅一个为空或值不同为假,再比较左右子树。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:不仅要比较节点值,还要比较空节点所在位置所表达的结构。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「判断两棵二叉树是否相同」。同步递归两个节点:同时为空为真,仅一个为空或值不同为假,再比较左右子树。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isSameTree(left, right) { // 定义本题的核心实现
if (!left && !right) return true // 检查当前分支条件
if (!left || !right) return false // 检查当前分支条件
if (left.value !== right.value) return false // 检查当前分支条件
return isSameTree(left.left, right.left) && isSameTree(left.right, right.right) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[1,2,3] 与 [1,2,3] 相同,[1,2] 与 [1,null,2] 不同。
- 易错点:不仅要比较节点值,还要比较空节点所在位置所表达的结构。
💬 面试官追问
- 为什么选择这个解法? 同步递归两个节点:同时为空为真,仅一个为空或值不同为假,再比较左右子树。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:不仅要比较节点值,还要比较空节点所在位置所表达的结构。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 105 二叉树路径总和
⚡ 30 秒速记
- 核心套路:沿根到叶路径递减目标值,在叶子节点检查剩余目标是否等于当前值。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:必须在叶子处判定,不能在中间节点提前命中;负数节点同样适用。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树路径总和」。沿根到叶路径递减目标值,在叶子节点检查剩余目标是否等于当前值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function hasPathSum(root, target) { // 定义本题的核心实现
if (!root) return false // 检查当前分支条件
if (!root.left && !root.right) return root.value === target // 检查当前分支条件
const remaining = target - root.value // 初始化当前步骤需要的状态
return hasPathSum(root.left, remaining) || hasPathSum(root.right, remaining) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:目标 22 在 5→4→11→2 路径上命中。
- 易错点:必须在叶子处判定,不能在中间节点提前命中;负数节点同样适用。
💬 面试官追问
- 为什么选择这个解法? 沿根到叶路径递减目标值,在叶子节点检查剩余目标是否等于当前值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:必须在叶子处判定,不能在中间节点提前命中;负数节点同样适用。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 106 二叉树最近公共祖先
⚡ 30 秒速记
- 核心套路:后序递归:当前节点命中目标就返回自己,左右都返回非空时当前节点就是最近公共祖先。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:比较节点引用而非值;若题目不保证两节点都存在,需要额外记录命中数量。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树最近公共祖先」。后序递归:当前节点命中目标就返回自己,左右都返回非空时当前节点就是最近公共祖先。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function lowestCommonAncestor(root, first, second) { // 定义本题的核心实现
if (!root || root === first || root === second) return root // 检查当前分支条件
const left = lowestCommonAncestor(root.left, first, second) // 初始化当前步骤需要的状态
const right = lowestCommonAncestor(root.right, first, second) // 初始化当前步骤需要的状态
if (left && right) return root // 检查当前分支条件
return left ?? right // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:在 [3,5,1,6,2,0,8] 中,5 与 1 的最近公共祖先是 3。
- 易错点:比较节点引用而非值;若题目不保证两节点都存在,需要额外记录命中数量。
💬 面试官追问
- 为什么选择这个解法? 后序递归:当前节点命中目标就返回自己,左右都返回非空时当前节点就是最近公共祖先。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:比较节点引用而非值;若题目不保证两节点都存在,需要额外记录命中数量。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 107 二叉树右视图
⚡ 30 秒速记
- 核心套路:层序遍历每一层,把该层最后出队的节点值加入答案。
- 复杂度:时间 O(n),空间 O(w)。
- 易错边界:右视图不是简单沿 right 指针走,缺少右孩子时仍可能看到左子树节点。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树右视图」。层序遍历每一层,把该层最后出队的节点值加入答案。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function rightSideView(root) { // 定义本题的核心实现
if (!root) return [] // 检查当前分支条件
const result = [] // 初始化当前步骤需要的状态
const queue = [root] // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
if (index === size - 1) result.push(node.value) // 检查当前分支条件
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[1,2,3,null,5,null,4] 的右视图为 [1,3,4]。
- 易错点:右视图不是简单沿 right 指针走,缺少右孩子时仍可能看到左子树节点。
💬 面试官追问
- 为什么选择这个解法? 层序遍历每一层,把该层最后出队的节点值加入答案。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:右视图不是简单沿 right 指针走,缺少右孩子时仍可能看到左子树节点。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 108 二叉搜索树第 K 小元素
⚡ 30 秒速记
- 核心套路:二叉搜索树中序遍历天然升序,访问到第 k 个节点时返回。
- 复杂度:时间 O(h+k),空间 O(h)。
- 易错边界:k 按 1 开始;频繁查询可在节点上维护子树大小以降到 O(h)。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉搜索树第 K 小元素」。二叉搜索树中序遍历天然升序,访问到第 k 个节点时返回。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function kthSmallest(root, k) { // 定义本题的核心实现
const stack = [] // 初始化当前步骤需要的状态
let current = root // 初始化当前步骤需要的状态
while (current || stack.length) { // 遍历仍需处理的候选状态
while (current) { // 遍历仍需处理的候选状态
stack.push(current) // 执行当前语句
current = current.left // 执行当前语句
} // 结束当前代码块
current = stack.pop() // 执行当前语句
k -= 1 // 执行当前语句
if (k === 0) return current.value // 检查当前分支条件
current = current.right // 执行当前语句
} // 结束当前代码块
throw new RangeError('k 超出节点数量') // 执行当前语句
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(h+k),空间 O(h)。
- 示例:[3,1,4,null,2] 的第 1 小元素为 1。
- 易错点:k 按 1 开始;频繁查询可在节点上维护子树大小以降到 O(h)。
💬 面试官追问
- 为什么选择这个解法? 二叉搜索树中序遍历天然升序,访问到第 k 个节点时返回。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:k 按 1 开始;频繁查询可在节点上维护子树大小以降到 O(h)。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 109 有序数组转换为平衡二叉搜索树
⚡ 30 秒速记
- 核心套路:每次选择区间中点作为根节点,递归构造左右半区。
- 复杂度:时间 O(n),递归栈 O(log n)。
- 易错边界:答案不唯一;中点选左或选右都可以,但区间必须严格缩小。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「有序数组转换为平衡二叉搜索树」。每次选择区间中点作为根节点,递归构造左右半区。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function sortedArrayToBst(numbers, left = 0, right = numbers.length - 1) { // 定义本题的核心实现
if (left > right) return null // 检查当前分支条件
const middle = left + Math.floor((right - left) / 2) // 初始化当前步骤需要的状态
return { // 返回本题要求的结果
value: numbers[middle], // 执行当前语句
left: sortedArrayToBst(numbers, left, middle - 1), // 执行当前语句
right: sortedArrayToBst(numbers, middle + 1, right) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(log n)。
- 示例:[-10,-3,0,5,9] 可构造根为 0 的平衡 BST。
- 易错点:答案不唯一;中点选左或选右都可以,但区间必须严格缩小。
💬 面试官追问
- 为什么选择这个解法? 每次选择区间中点作为根节点,递归构造左右半区。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:答案不唯一;中点选左或选右都可以,但区间必须严格缩小。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 110 二叉树展开为链表
⚡ 30 秒速记
- 核心套路:逆前序遍历(右、左、根),用 previous 指向已展开部分并接到当前节点右侧。
- 复杂度:时间 O(n),递归栈 O(h)。
- 易错边界:展开后所有 left 必须为空,节点顺序是前序遍历而不是中序。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树展开为链表」。逆前序遍历(右、左、根),用 previous 指向已展开部分并接到当前节点右侧。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function flattenTree(root) { // 定义本题的核心实现
let previous = null // 初始化当前步骤需要的状态
const visit = node => { // 初始化当前步骤需要的状态
if (!node) return // 检查当前分支条件
visit(node.right) // 执行当前语句
visit(node.left) // 执行当前语句
node.right = previous // 执行当前语句
node.left = null // 执行当前语句
previous = node // 执行当前语句
} // 结束当前代码块
visit(root) // 执行当前语句
return root // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),递归栈 O(h)。
- 示例:[1,2,5,3,4,null,6] 展开为 1→2→3→4→5→6。
- 易错点:展开后所有 left 必须为空,节点顺序是前序遍历而不是中序。
💬 面试官追问
- 为什么选择这个解法? 逆前序遍历(右、左、根),用 previous 指向已展开部分并接到当前节点右侧。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:展开后所有 left 必须为空,节点顺序是前序遍历而不是中序。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 111 二叉树的所有根到叶路径
⚡ 30 秒速记
- 核心套路:深度优先维护当前路径,在叶子节点把路径序列化并收集。
- 复杂度:时间 O(n·h),递归栈 O(h)。
- 易错边界:只有叶子才形成完整路径;回溯时要移除当前节点。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树的所有根到叶路径」。深度优先维护当前路径,在叶子节点把路径序列化并收集。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function binaryTreePaths(root) { // 定义本题的核心实现
const result = [] // 初始化当前步骤需要的状态
const path = [] // 初始化当前步骤需要的状态
const visit = node => { // 初始化当前步骤需要的状态
if (!node) return // 检查当前分支条件
path.push(node.value) // 执行当前语句
if (!node.left && !node.right) result.push(path.join('->')) // 检查当前分支条件
else { // 处理另一种分支
visit(node.left) // 执行当前语句
visit(node.right) // 执行当前语句
} // 结束当前代码块
path.pop() // 执行当前语句
} // 结束当前代码块
visit(root) // 执行当前语句
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n·h),递归栈 O(h)。
- 示例:[1,2,3,null,5] 得到 1→2→5 与 1→3。
- 易错点:只有叶子才形成完整路径;回溯时要移除当前节点。
💬 面试官追问
- 为什么选择这个解法? 深度优先维护当前路径,在叶子节点把路径序列化并收集。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:只有叶子才形成完整路径;回溯时要移除当前节点。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 112 完全二叉树节点个数
⚡ 30 秒速记
- 核心套路:比较最左路径与最右路径高度,相等说明是满二叉树,可直接用 2^h-1 计算。
- 复杂度:时间 O(log² n),递归栈 O(log n)。
- 易错边界:该优化只适用于完全二叉树;普通二叉树必须完整遍历。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「完全二叉树节点个数」。比较最左路径与最右路径高度,相等说明是满二叉树,可直接用 2^h-1 计算。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function countCompleteNodes(root) { // 定义本题的核心实现
if (!root) return 0 // 检查当前分支条件
let leftHeight = 0 // 初始化当前步骤需要的状态
let rightHeight = 0 // 初始化当前步骤需要的状态
for (let node = root; node; node = node.left) leftHeight += 1 // 遍历仍需处理的候选状态
for (let node = root; node; node = node.right) rightHeight += 1 // 遍历仍需处理的候选状态
if (leftHeight === rightHeight) return 2 ** leftHeight - 1 // 检查当前分支条件
return 1 + countCompleteNodes(root.left) + countCompleteNodes(root.right) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(log² n),递归栈 O(log n)。
- 示例:[1,2,3,4,5,6] 返回 6。
- 易错点:该优化只适用于完全二叉树;普通二叉树必须完整遍历。
💬 面试官追问
- 为什么选择这个解法? 比较最左路径与最右路径高度,相等说明是满二叉树,可直接用 2^h-1 计算。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:该优化只适用于完全二叉树;普通二叉树必须完整遍历。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 113 判断一棵树是否为另一棵树的子树
⚡ 30 秒速记
- 核心套路:遍历主树的每个节点作为候选根,并用相同树判断比较完整结构。
- 复杂度:最坏时间 O(mn),递归栈 O(h)。
- 易错边界:值相同只是候选开始,左右结构也必须完全一致;空子树语义要事先约定。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「判断一棵树是否为另一棵树的子树」。遍历主树的每个节点作为候选根,并用相同树判断比较完整结构。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function isSubtree(root, candidate) { // 定义本题的核心实现
const same = (left, right) => { // 初始化当前步骤需要的状态
if (!left || !right) return left === right // 检查当前分支条件
return left.value === right.value && same(left.left, right.left) && same(left.right, right.right) // 返回本题要求的结果
} // 结束当前代码块
if (!candidate) return true // 检查当前分支条件
if (!root) return false // 检查当前分支条件
return same(root, candidate) || isSubtree(root.left, candidate) || isSubtree(root.right, candidate) // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 最坏时间 O(mn),递归栈 O(h)。
- 示例:主树 [3,4,5,1,2] 包含子树 [4,1,2]。
- 易错点:值相同只是候选开始,左右结构也必须完全一致;空子树语义要事先约定。
💬 面试官追问
- 为什么选择这个解法? 遍历主树的每个节点作为候选根,并用相同树判断比较完整结构。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:值相同只是候选开始,左右结构也必须完全一致;空子树语义要事先约定。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 114 构造最大二叉树
⚡ 30 秒速记
- 核心套路:当前区间最大值作为根,最大值左右两侧分别递归构造左右子树。
- 复杂度:朴素时间 O(n²),递归栈 O(n)。
- 易错边界:严格按原数组相对位置切分;可用单调栈把构造优化为 O(n)。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「构造最大二叉树」。当前区间最大值作为根,最大值左右两侧分别递归构造左右子树。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function constructMaximumBinaryTree(numbers, left = 0, right = numbers.length) { // 定义本题的核心实现
if (left >= right) return null // 检查当前分支条件
let maximum = left // 初始化当前步骤需要的状态
for (let index = left + 1; index < right; index += 1) { // 遍历仍需处理的候选状态
if (numbers[index] > numbers[maximum]) maximum = index // 检查当前分支条件
} // 结束当前代码块
return { // 返回本题要求的结果
value: numbers[maximum], // 执行当前语句
left: constructMaximumBinaryTree(numbers, left, maximum), // 执行当前语句
right: constructMaximumBinaryTree(numbers, maximum + 1, right) // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 朴素时间 O(n²),递归栈 O(n)。
- 示例:[3,2,1,6,0,5] 的根节点为 6。
- 易错点:严格按原数组相对位置切分;可用单调栈把构造优化为 O(n)。
💬 面试官追问
- 为什么选择这个解法? 当前区间最大值作为根,最大值左右两侧分别递归构造左右子树。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:严格按原数组相对位置切分;可用单调栈把构造优化为 O(n)。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 115 二叉搜索树中搜索节点
⚡ 30 秒速记
- 核心套路:利用左小右大的有序性,从根节点迭代选择唯一可能包含目标的子树。
- 复杂度:时间 O(h),空间 O(1)。
- 易错边界:退化链状 BST 的高度可能为 n;重复值放哪一侧必须由树的契约决定。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉搜索树中搜索节点」。利用左小右大的有序性,从根节点迭代选择唯一可能包含目标的子树。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function searchBst(root, target) { // 定义本题的核心实现
let current = root // 初始化当前步骤需要的状态
while (current) { // 遍历仍需处理的候选状态
if (current.value === target) return current // 检查当前分支条件
current = target < current.value ? current.left : current.right // 执行当前语句
} // 结束当前代码块
return null // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(h),空间 O(1)。
- 示例:[4,2,7,1,3] 中搜索 2 返回以 2 为根的子树。
- 易错点:退化链状 BST 的高度可能为 n;重复值放哪一侧必须由树的契约决定。
💬 面试官追问
- 为什么选择这个解法? 利用左小右大的有序性,从根节点迭代选择唯一可能包含目标的子树。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:退化链状 BST 的高度可能为 n;重复值放哪一侧必须由树的契约决定。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 116 向二叉搜索树插入节点
⚡ 30 秒速记
- 核心套路:沿比较结果向左或向右查找空位置,再把新节点连接到最后一个非空父节点。
- 复杂度:时间 O(h),空间 O(1)。
- 易错边界:空树插入应返回新根;重复值是忽略、计数还是固定放一侧必须明确。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「向二叉搜索树插入节点」。沿比较结果向左或向右查找空位置,再把新节点连接到最后一个非空父节点。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function insertIntoBst(root, value) { // 定义本题的核心实现
const node = { value, left: null, right: null } // 初始化当前步骤需要的状态
if (!root) return node // 检查当前分支条件
let current = root // 初始化当前步骤需要的状态
while (true) { // 遍历仍需处理的候选状态
const side = value < current.value ? 'left' : 'right' // 初始化当前步骤需要的状态
if (!current[side]) { // 检查当前分支条件
current[side] = node // 执行当前语句
return root // 返回本题要求的结果
} // 结束当前代码块
current = current[side] // 执行当前语句
} // 结束当前代码块
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(h),空间 O(1)。
- 示例:向 [4,2,7,1,3] 插入 5,成为节点 7 的左孩子。
- 易错点:空树插入应返回新根;重复值是忽略、计数还是固定放一侧必须明确。
💬 面试官追问
- 为什么选择这个解法? 沿比较结果向左或向右查找空位置,再把新节点连接到最后一个非空父节点。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:空树插入应返回新根;重复值是忽略、计数还是固定放一侧必须明确。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 117 N 叉树层序遍历
⚡ 30 秒速记
- 核心套路:队列按层保存节点,每轮先固定当前层长度,再把全部孩子加入队尾。
- 复杂度:时间 O(n),空间 O(w)。
- 易错边界:children 可能为空数组或缺省;不能在本层循环中使用动态变化的 queue.length 作为边界。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「N 叉树层序遍历」。队列按层保存节点,每轮先固定当前层长度,再把全部孩子加入队尾。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function levelOrderNary(root) { // 定义本题的核心实现
if (!root) return [] // 检查当前分支条件
const result = [] // 初始化当前步骤需要的状态
const queue = [root] // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
const level = [] // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
level.push(node.value) // 执行当前语句
queue.push(...(node.children ?? [])) // 执行当前语句
} // 结束当前代码块
result.push(level) // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:根 1 的孩子为 3、2、4,节点 3 的孩子为 5、6,结果为 [[1],[3,2,4],[5,6]]。
- 易错点:children 可能为空数组或缺省;不能在本层循环中使用动态变化的 queue.length 作为边界。
💬 面试官追问
- 为什么选择这个解法? 队列按层保存节点,每轮先固定当前层长度,再把全部孩子加入队尾。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:children 可能为空数组或缺省;不能在本层循环中使用动态变化的 queue.length 作为边界。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 118 二叉树每层平均值
⚡ 30 秒速记
- 核心套路:层序遍历时统计当前层节点数与总和,层结束后写入平均值。
- 复杂度:时间 O(n),空间 O(w)。
- 易错边界:分母必须用本层固定 size,而不是加入下一层节点后变化的队列长度。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树每层平均值」。层序遍历时统计当前层节点数与总和,层结束后写入平均值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function averageOfLevels(root) { // 定义本题的核心实现
if (!root) return [] // 检查当前分支条件
const result = [] // 初始化当前步骤需要的状态
const queue = [root] // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
let sum = 0 // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
sum += node.value // 执行当前语句
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
result.push(sum / size) // 执行当前语句
} // 结束当前代码块
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[3,9,20,null,null,15,7] 得到 [3,14.5,11]。
- 易错点:分母必须用本层固定 size,而不是加入下一层节点后变化的队列长度。
💬 面试官追问
- 为什么选择这个解法? 层序遍历时统计当前层节点数与总和,层结束后写入平均值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:分母必须用本层固定 size,而不是加入下一层节点后变化的队列长度。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 119 二叉树最底层最左边的值
⚡ 30 秒速记
- 核心套路:层序遍历每层时记录第一个出队节点,最后一层记录即为答案。
- 复杂度:时间 O(n),空间 O(w)。
- 易错边界:“最左”按树的结构定义,不是数值最小;根节点存在时答案一定可得。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「二叉树最底层最左边的值」。层序遍历每层时记录第一个出队节点,最后一层记录即为答案。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function findBottomLeftValue(root) { // 定义本题的核心实现
const queue = [root] // 初始化当前步骤需要的状态
let answer = root.value // 初始化当前步骤需要的状态
while (queue.length) { // 遍历仍需处理的候选状态
const size = queue.length // 初始化当前步骤需要的状态
for (let index = 0; index < size; index += 1) { // 遍历仍需处理的候选状态
const node = queue.shift() // 初始化当前步骤需要的状态
if (index === 0) answer = node.value // 检查当前分支条件
if (node.left) queue.push(node.left) // 检查当前分支条件
if (node.right) queue.push(node.right) // 检查当前分支条件
} // 结束当前代码块
} // 结束当前代码块
return answer // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(w)。
- 示例:[2,1,3] 返回 1。
- 易错点:“最左”按树的结构定义,不是数值最小;根节点存在时答案一定可得。
💬 面试官追问
- 为什么选择这个解法? 层序遍历每层时记录第一个出队节点,最后一层记录即为答案。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:“最左”按树的结构定义,不是数值最小;根节点存在时答案一定可得。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 120 只出现一次的数字
⚡ 30 秒速记
- 核心套路:利用 x XOR x 等于零、x XOR 0 等于 x,把全部元素异或后留下唯一值。
- 复杂度:时间 O(n),空间 O(1)。
- 易错边界:该结论依赖其余元素恰好出现两次;JavaScript 位运算会转换为 32 位有符号整数。
回答时先讲状态含义和不变量,再按一次正常流转说明为什么能排除其他候选,最后补复杂度与边界。
# 题目与解题思路
独立实现「只出现一次的数字」。利用 x XOR x 等于零、x XOR 0 等于 x,把全部元素异或后留下唯一值。 演示卡片默认收起,展开后可以切换正常路径和边界路径,使用上一步、下一步、自动播放与进度条观察每一次状态变化。
function singleNumber(numbers) { // 定义本题的核心实现
let result = 0 // 初始化当前步骤需要的状态
for (const value of numbers) result ^= value // 遍历仍需处理的候选状态
return result // 返回本题要求的结果
} // 结束当前代码块
# 复杂度、示例与易错点
- 时间 O(n),空间 O(1)。
- 示例:[4,1,2,1,2] 返回 4。
- 易错点:该结论依赖其余元素恰好出现两次;JavaScript 位运算会转换为 32 位有符号整数。
💬 面试官追问
- 为什么选择这个解法? 利用 x XOR x 等于零、x XOR 0 等于 x,把全部元素异或后留下唯一值。
- 面试时先测哪个边界? 先测空输入或最小输入,再测重复值、极端顺序以及答案不存在的情况;其中最关键的是:该结论依赖其余元素恰好出现两次;JavaScript 位运算会转换为 32 位有符号整数。
- 如何验证实现没有“看起来能跑”的假正确? 除示例外增加对照用例,并核对每轮不变量、输入是否被意外修改,以及最终结果是否满足题意而非只命中一个样例。
- 生产代码还要补什么? 明确非法输入契约、数据规模上限和是否允许原地修改;若输入来自接口,还要在入口完成类型与范围校验。
# 36 综合
# 1 实现一个 sleep 函数,比如 sleep(1000) 意味着等待1000毫秒
⚡ 30 秒速记
- 可以用
Promise包装setTimeout,让sleep(1000)在约定时间后变为已完成状态。 setTimeout到时调用resolve,因此后续操作可以写在.then()中。- 这个实现表达的是异步等待,并不会返回等待期间的业务结果。
- 需要连续执行多步操作时,也可以围绕这个
Promise继续组织异步流程。
可以用 Promise 包装 setTimeout,让 sleep(1000) 在约定时间后变为已完成状态。 setTimeout 到时调用 resolve,因此后续操作可以写在 .then() 中。这个实现表达的是异步等待,并不会返回等待期间的业务结果。需要连续执行多步操作时,也可以围绕这个 Promise 继续组织异步流程。
// 使用 promise来实现 sleep
const sleep = (time) => {
return new Promise(resolve => setTimeout(resolve, time))
}
sleep(1000).then(() => {
// 这里写你的骚操作
})
💬 面试官追问
动画页面调用
await sleep(1000)后,产品认为主线程会停住一秒、用户无法点击;你会如何判断这个说法?该实现不会同步阻塞主线程,而是用
setTimeout安排计时器,await只暂停当前异步函数的后续执行。期间事件循环仍可处理点击和渲染;不过长时间运行的同步任务会推迟回调,因此一秒只是最早可继续的近似时间。搜索框连续触发多个延迟请求,用户清空输入后旧的
sleep(500)仍会继续并发请求,你会给这个实现补什么能力?需要加入取消语义,例如接收
AbortSignal,取消时清除定时器并让等待以约定的错误结束。调用方还应在恢复执行前检查请求是否仍有效;原始Promise本身不会取消计时器,忽略返回值也无法阻止后续逻辑。配置中心把延迟值传成字符串、负数或
NaN,当前sleep(time)是否应该悄悄交给setTimeout转换?公共工具函数最好先限定
time为有限且非负的数值,否则隐式转换会掩盖配置错误,并产生接近立即执行的行为。可以选择抛出TypeError或按业务钳制范围,但必须固定契约;极大延迟还受运行环境计时器能力限制。线上轮询写成
while (true) { await sleep(1000); fetchData(); },接口偶发变慢后请求越积越多,你会先排查sleep还是调用方式?先确认
fetchData()是否被await;若只是启动请求而不等待完成,每轮都会继续创建新请求,sleep只控制启动间隔而不限制并发。应等待上一轮结束或设置并发上限,并为请求增加超时与取消;单独调整休眠时间不能消除堆积。测试负责人要求验证
sleep(1000)必须恰好在第1000ms恢复,你会接受这个断言吗?不应断言恰好在该时刻恢复,因为计时器只保证达到延迟后进入可调度状态,实际执行还取决于事件循环和主线程负载。测试可使用受控假计时器验证注册延迟与状态转换;真实时钟断言只能给合理容差,仍可能受环境抖动影响。
# 2 给定两个数组,写一个方法来计算它们的交集
⚡ 30 秒速记
- 可以用
filter遍历第一个数组,再通过indexOf判断元素是否存在于第二个数组。 - 只有能在第二个数组中找到的元素才会被保留,所以示例会得到
[2, 2]。 - 这种写法会保留第一个数组中的重复项,并不统计第二个数组里每个元素的出现次数。
- 如果期望交集去重或严格匹配重复次数,就不能直接沿用这段逻辑。
可以用 filter 遍历第一个数组,再通过 indexOf 判断元素是否存在于第二个数组。 只有能在第二个数组中找到的元素才会被保留,所以示例会得到 [2, 2]。这种写法会保留第一个数组中的重复项,并不统计第二个数组里每个元素的出现次数。如果期望交集去重或严格匹配重复次数,就不能直接沿用这段逻辑。
例如:给定 nums1 = [1, 2, 2, 1],nums2 = [2, 2],返回 [2, 2]。
function union (arr1, arr2) {
return arr1.filter(item => {
return arr2.indexOf(item) > - 1;
})
}
const a = [1, 2, 2, 1];
const b = [2, 3, 2];
console.log(union(a, b)); // [2, 2]
💬 面试官追问
订单页输入
[2,2]和[2],当前filter实现仍返回[2,2];如果业务定义的是保留双方最小出现次数,这算正确吗?不正确,因为
indexOf只判断第二个数组是否存在该值,不会消耗匹配次数,所以结果完全继承第一个数组的重复数量。应先统计第二个数组的频次,命中后将计数减一;这会增加额外空间,但才能满足多重集交集语义。标签筛选数据各有十万项,代码评审发现每个
arr1元素都执行一次arr2.indexOf,你会保留这版吗?不宜直接保留,因为最坏情况下会反复线性扫描第二个数组,时间复杂度接近
O(nm)。只需集合语义时可预建Set,需要保留重复次数时使用Map计数;两者以额外O(m)空间换取更稳定的线性遍历。数据分析页要返回“不重复的共同用户
ID”,而现有示例刻意返回两个2,前端和接口负责人意见冲突时你先确认什么?先确认交集采用集合语义还是多重集语义,因为两种输出都可能合理,但契约不同。若要求唯一值,应对结果去重或使用
Set;还需约定输出顺序,当前实现保留arr1的顺序,改用其他结构时不能无意改变接口表现。线上数据包含
NaN和结构相同但引用不同的对象,发现交集结果漏项,你会怎样解释indexOf的边界?indexOf无法匹配NaN,对象比较也只认同一引用,因此两个内容相同的独立对象不会相交。基本值场景可考虑使用Set的匹配语义;对象场景应明确稳定键并按键索引,序列化对象可能受属性顺序和循环引用影响。两个已按用户
ID升序排列的百万级数组来自流式接口,内存限制不允许构造完整Map,你会选什么方案?可利用有序性使用双指针:较小值一侧前进,相等时输出并按重复语义移动一侧或两侧,时间为线性且额外空间较小。该方案依赖排序可靠并需要流按顺序到达;若输入无序,预排序会引入额外时间且可能无法满足流式约束。
# 3 异步并发数限制
⚡ 30 秒速记
- 异步并发限制的核心是只维持不超过
count个执行中任务,并在其中一个完成后继续补充任务。 - 代码用
Promise.resolve().then()延后调用迭代函数,避免创建任务时立即执行。 - 达到并发上限后通过
Promise.race()等待任一任务完成,再从doingTasks中移除它并入队下一个任务。 - 最后用
Promise.all()汇总全部任务的结果。
异步并发限制的核心是只维持不超过 count 个执行中任务,并在其中一个完成后继续补充任务。 代码用 Promise.resolve().then() 延后调用迭代函数,避免创建任务时立即执行。达到并发上限后通过 Promise.race() 等待任一任务完成,再从 doingTasks 中移除它并入队下一个任务。最后用 Promise.all() 汇总全部任务的结果。
/**
* 关键点
* 1. new promise 一经创建,立即执行
* 2. 使用 Promise.resolve().then 可以把任务加到微任务队列,防止立即执行迭代方法
* 3. 微任务处理过程中,产生的新的微任务,会在同一事件循环内,追加到微任务队列里
* 4. 使用 race 在某个任务完成时,继续添加任务,保持任务按照最大并发数进行执行
* 5. 任务完成后,需要从 doingTasks 中移出
*/
function limit(count, array, iterateFunc) {
const tasks = []
const doingTasks = []
let i = 0
const enqueue = () => {
if (i === array.length) {
return Promise.resolve()
}
const task = Promise.resolve().then(() => iterateFunc(array[i++]))
tasks.push(task)
const doing = task.then(() => doingTasks.splice(doingTasks.indexOf(doing), 1))
doingTasks.push(doing)
const res = doingTasks.length >= count ? Promise.race(doingTasks) : Promise.resolve()
return res.then(enqueue)
};
return enqueue().then(() => Promise.all(tasks))
}
// test
const timeout = i => new Promise(resolve => setTimeout(() => resolve(i), i))
limit(2, [1000, 1000, 1000, 1000], timeout).then((res) => {
console.log(res)
})
💬 面试官追问
上传页把
limit(2, files, upload)理解成“每秒最多上传两个文件”,但抓包显示任务完成后立即补位;这里限制的究竟是什么?这里限制的是同时处于执行中的任务数,不是单位时间内的请求次数。
Promise.race(doingTasks)在任一任务完成后触发补位,因此快任务可能在一秒内启动很多次;若接口要求速率限制,还需令牌桶、固定窗口或服务端配额控制。批量导入有五千个任务,其中一个任务拒绝后
limit立即失败,但已发出的请求仍在写库;当前实现能做到快速停止吗?它只能停止正常的后续调度链并返回拒绝,已经启动的底层任务不会因
Promise拒绝而自动取消。请求任务应接收统一的AbortSignal,失败时停止补位并主动中止可取消操作;写库等不可撤销动作仍需幂等键或补偿机制。线上偶发失败后监控出现未处理拒绝,同时
doingTasks中的任务没有被移除,你会检查哪一行清理逻辑?应检查
task.then(() => splice(...)),它只在成功时移除任务;task拒绝时生成的doing也会拒绝,清理不会执行。可把删除动作放进成功和失败都会执行的清理分支,并确保拒绝继续按策略传播;错误处理不当还可能造成队列停滞。调用方传入
count为0、负数或小数,产品希望系统自动兜底,你会直接运行当前代码吗?不应直接运行,应在入口要求
count是大于等于1的整数,否则“最大并发数”的语义不成立。当前条件和Promise.race在非法值下可能表现为串行、等待异常或与预期不符;选择抛错比静默修正更容易暴露错误配置。报表页要求无论单个任务成功或失败,都处理完全部输入并按原数组顺序展示结果;当前
Promise.all(tasks)合适吗?不合适,
Promise.all遇到首个拒绝就返回失败,虽然其他已启动任务仍可能继续,却拿不到完整结果。可为每个任务包装成功或失败状态,或最终使用等价于Promise.allSettled的收集方式;代价是调用方必须逐项处理错误,不能再依赖整体快速失败。代码评审有人建议一次性执行
array.map(iterateFunc)后再分批等待,另一人坚持当前延迟创建任务的方式,你支持哪一方?若
iterateFunc一调用就启动异步操作,先执行完整个map会瞬间创建全部任务,并发限制已经失效。当前用Promise.resolve().then延迟调用并在任务完成后补位更符合并发池语义;但仍会保存全部任务结果,大数据流应边消费边释放。
# 4 异步串行 | 异步并行
⚡ 30 秒速记
- 异步串行是让加法任务依次执行,异步并行则把可同时计算的任务成对执行,再递归合并结果。
serialSum用reduce串起Promise,前一次结果会作为下一次的输入。parallelSum每轮通过Promise.all汇总任务,直到只剩一个结果。- 两者结果相同,但并行方案更适合彼此没有依赖的计算;空参数等边界需要另外约定。
异步串行是让加法任务依次执行,异步并行则把可同时计算的任务成对执行,再递归合并结果。 serialSum 用 reduce 串起 Promise,前一次结果会作为下一次的输入。parallelSum 每轮通过 Promise.all 汇总任务,直到只剩一个结果。两者结果相同,但并行方案更适合彼此没有依赖的计算;空参数等边界需要另外约定。
// 字节面试题,实现一个异步加法
function asyncAdd(a, b, callback) {
setTimeout(function () {
callback(null, a + b);
}, 500);
}
// 解决方案
// 1. promisify
const promiseAdd = (a, b) => new Promise((resolve, reject) => {
asyncAdd(a, b, (err, res) => {
if (err) {
reject(err)
} else {
resolve(res)
}
})
})
// 2. 串行处理
async function serialSum(...args) {
return args.reduce((task, now) => task.then(res => promiseAdd(res, now)), Promise.resolve(0))
}
// 3. 并行处理
async function parallelSum(...args) {
if (args.length === 1) return args[0]
const tasks = []
for (let i = 0; i < args.length; i += 2) {
tasks.push(promiseAdd(args[i], args[i + 1] || 0))
}
const results = await Promise.all(tasks)
return parallelSum(...results)
}
// 测试
(async () => {
console.log('Running...');
const res1 = await serialSum(1, 2, 3, 4, 5, 8, 9, 10, 11, 12)
console.log(res1)
const res2 = await parallelSum(1, 2, 3, 4, 5, 8, 9, 10, 11, 12)
console.log(res2)
console.log('Done');
})()
💬 面试官追问
结算页要累加
1,2,3,4,同事把所有promiseAdd(0, n)直接Promise.all后再相加;它与题中的树形并行实现是同一种约束吗?两者都能得到普通数字之和,但前者绕过了“每次加法都必须调用
asyncAdd”的约束,最终本地求和不再是异步加法。题中的实现让每一层两两调用promiseAdd,再递归合并结果;若业务只限制输入调用而不限制归并方式,两种方案才可能等价。报表页需要累计 20 个分片,后一个分片必须以上一次异步加法结果为输入;你会怎样落地串行流程并处理首个值?
可用
reduce构造连续的Promise链,以Promise.resolve(0)作为初始任务,每一步执行promiseAdd(res, now)。这样后一步只会在前一步完成后启动,顺序约束清晰;代价是总耗时随加法次数线性累积,任一步拒绝都会中断后续链路。批处理从十几个数字扩大到十万项,但服务端只允许同时进行 50 次异步加法;题中的
parallelSum还能直接使用吗?不能直接照搬,因为它在每一轮为所有数对立即创建任务,首轮并发量约为输入数量的一半,可能超过服务端限制。应把数对放入并发池,每完成一个任务再补充一个,收齐本轮结果后继续归并;限流会增加总耗时,也需要保存结果顺序。
线上偶发出现
parallelSum()返回不符合预期,日志显示调用方有时传入空数组、有时某次asyncAdd回调错误;你会沿哪条链路排查?先核对输入边界:实现只处理了单参数,没有为空参数设置终止条件,递归可能无法收敛。再确认
asyncAdd的错误是否被promiseAdd转为拒绝,以及Promise.all是否因此提前失败;还应记录每轮参数和任务结果,区分输入问题与回调异常。搜索页要汇总 12 个独立分值,负责人在
serialSum和parallelSum之间犹豫;在每次asyncAdd固定异步等待的前提下你怎么选?没有顺序依赖且允许并发时,应优先树形
parallelSum,它把多次加法分层执行,而不是逐项等待。若外部系统要求严格顺序、限制并发或前一步结果决定后一步是否合法,则选serialSum;并行方案还需承担瞬时任务量和整体失败传播的风险。用户关闭计算弹窗后,已经启动的 30 个
asyncAdd仍继续回调并尝试更新界面;仅让Promise.all不再写状态是否算真正取消?不算,忽略
Promise.all的结果只能阻止界面写回,已经交给setTimeout或外部系统的任务仍会继续运行。需要让底层异步函数提供取消能力,例如保存定时器并清理,或让请求接受AbortSignal;若底层不可取消,只能丢弃过期结果并停止启动后续任务。
# 5 实现有并行限制的 Promise 调度器
⚡ 30 秒速记
- 这个调度器用任务队列和运行计数控制并发,确保同时执行的任务不超过
limit。 add只把创建Promise的函数放进队列,taskStart才启动首批任务,因此任务不会提前执行。- 每个任务完成后,
runCounts减一并调用request补位,所以示例会按2、3、1、4输出。 - 实际使用还要考虑任务失败,否则只写
then时,拒绝的任务可能无法释放并发名额。
这个调度器用任务队列和运行计数控制并发,确保同时执行的任务不超过 limit。 add 只把创建 Promise 的函数放进队列,taskStart 才启动首批任务,因此任务不会提前执行。每个任务完成后,runCounts 减一并调用 request 补位,所以示例会按 2、3、1、4 输出。实际使用还要考虑任务失败,否则只写 then 时,拒绝的任务可能无法释放并发名额。
题目描述:JS 实现一个带并发限制的异步调度器 Scheduler,保证同时运行的任务最多有两个
addTask(1000,"1");
addTask(500,"2");
addTask(300,"3");
addTask(400,"4");
的输出顺序是:2 3 1 4
整个的完整执行流程:
一开始1、2两个任务开始执行
500ms时,2任务执行完毕,输出2,任务3开始执行
800ms时,3任务执行完毕,输出3,任务4开始执行
1000ms时,1任务执行完毕,输出1,此时只剩下4任务在执行
1200ms时,4任务执行完毕,输出4
实现代码如下:
class Scheduler {
constructor(limit) {
this.queue = [];
this.maxCount = limit;
this.runCounts = 0;
}
add(time, order) {
const promiseCreator = () => {
return new Promise((resolve, reject) => {
setTimeout(() => {
console.log(order);
resolve();
}, time);
});
};
this.queue.push(promiseCreator);
}
taskStart() {
for (let i = 0; i < this.maxCount; i++) {
this.request();
}
}
request() {
if (!this.queue || !this.queue.length || this.runCounts >= this.maxCount) {
return;
}
this.runCounts++;
this.queue
.shift()()
.then(() => {
this.runCounts--;
this.request();
});
}
}
const scheduler = new Scheduler(2);
const addTask = (time, order) => {
scheduler.add(time, order);
};
addTask(1000, "1");
addTask(500, "2");
addTask(300, "3");
addTask(400, "4");
scheduler.taskStart();
💬 面试官追问
商品页一次加入
20个预加载任务,并发上限设为2;其中一个任务直接reject,按当前request实现,后面的任务还会继续执行吗?不会可靠地继续调度,因为当前代码只在
.then中递减runCounts并调用下一次request。任务拒绝后该执行槽不会释放,还会产生未处理拒绝;应把释放和续调放入.finally,并另行记录或向上抛出错误。上传页需要动态加入
100个分片任务,并要求调用add后拿到该分片最终结果;你会怎样调整Scheduler.add的接口和队列结构?add应返回一个外层Promise,队列保存任务函数及对应的resolve、reject,真正执行完成后再结算调用方。任务必须以函数形式延迟创建,若传入已启动的Promise,入队前就会执行,并发上限将失去作用。接口网关只允许同时处理
5个请求,但产品要求任意任务失败后立即停止继续发新请求;已启动的请求和队列中的请求分别怎么处理?调度器应进入停止状态并拒绝或清空尚未启动的队列,同时不再补充新任务。已经启动的
Promise无法被拒绝状态自动取消,请求任务需接收同一个AbortSignal并主动响应取消;若底层任务不支持取消,只能忽略其结果并等待资源释放。线上监控显示并发限制为
2,偶发失败后页面一直还有任务处于“等待中”,但网络面板已经没有请求,你会先查哪几个状态和调用链?先核对
runCounts、队列长度以及每个任务是否进入成功、失败和清理分支,重点检查拒绝时是否遗漏递减计数。再给任务编号记录入队、启动、结算和补位事件,以确认是槽位泄漏还是任务本身永不结算;超时只能作为保护,不能替代根因修复。搜索页有
50个互不依赖的请求,架构师主张直接Promise.all,后端要求并发最多2;你如何说明两种方案的行为差异?Promise.all会在创建这些请求后同时等待,不能替代调度器对“何时启动”的控制,并且任一拒绝会让聚合结果快速拒绝。并发池通过保存任务函数、完成一个再启动一个来限制运行数;代价是总耗时可能增加,还需自行定义失败、重试和结果顺序。任务完成日志顺序是
2 3 1 4,但业务要求最终数组仍按提交顺序返回1 2 3 4;调度器应该改执行顺序还是结果收集方式?不应为了结果顺序强行串行执行,完成顺序由耗时和并发补位决定。可在入队时保存索引,任务结算后写入对应位置,全部结束再返回按索引排列的数组;实时日志仍可能是
2 3 1 4,两种顺序需要在接口语义中明确区分。
# 6 图片懒加载
⚡ 30 秒速记
- 图片懒加载可以先展示默认图,等图片进入视口后再把
data-src写入src。 - 示例通过
getBoundingClientRect判断图片顶部或底部是否可见,加载成功后清空data-src,避免重复处理。 - 页面加载和滚动时都要执行检查,滚动监听可以配合
throttle降低调用频率。 - 需要注意,这个判断只覆盖边缘进入视口的情况,完全包住视口的大图可能识别不到。
图片懒加载可以先展示默认图,等图片进入视口后再把 data-src 写入 src。 示例通过 getBoundingClientRect 判断图片顶部或底部是否可见,加载成功后清空 data-src,避免重复处理。页面加载和滚动时都要执行检查,滚动监听可以配合 throttle 降低调用频率。需要注意,这个判断只覆盖边缘进入视口的情况,完全包住视口的大图可能识别不到。
// <img src="default.png" data-src="https://xxxx/real.png">
function isVisible(el) {
const position = el.getBoundingClientRect()
const windowHeight = document.documentElement.clientHeight
// 顶部边缘可见
const topVisible = position.top > 0 && position.top < windowHeight;
// 底部边缘可见
const bottomVisible = position.bottom < windowHeight && position.bottom > 0;
return topVisible || bottomVisible;
}
function imageLazyLoad() {
const images = document.querySelectorAll('img')
for (let img of images) {
const realSrc = img.dataset.src
if (!realSrc) continue
if (isVisible(img)) {
img.src = realSrc
img.dataset.src = ''
}
}
}
// 测试
window.addEventListener('load', imageLazyLoad)
window.addEventListener('scroll', imageLazyLoad)
// or
window.addEventListener('scroll', throttle(imageLazyLoad, 1000))
💬 面试官追问
文章页有一张高度超过视口的长图,滚动到图像中部时它覆盖整个屏幕,但当前
isVisible返回false,原因是什么?当前判断只检查图片顶部或底部边缘是否落在视口内,长图两条边都在视口外时会被误判。可改为判断
position.bottom > 0 && position.top < windowHeight,表示元素区间与视口区间存在交集;还需按需求处理边界恰好相等的情况。瀑布流页面有
2000张图片,当前在每次scroll中遍历全部img并调用getBoundingClientRect,你会怎样落地优化?优先用
IntersectionObserver观察带data-src的图片,进入视口附近时替换src,加载后立即unobserve。若必须保留滚动方案,应节流并从待加载集合中移除已完成项;大量同步布局读取和全量扫描仍可能挤占主线程。电商列表希望图片在进入视口前
300px就开始加载,同时列表放在一个独立滚动容器中;现有窗口高度判断要怎么改?手写方案需要以滚动容器的可视矩形为基准,并把上下边界扩展
300px,不能继续只比较document.documentElement.clientHeight。使用IntersectionObserver时可设置容器为root、预加载距离为rootMargin;距离越大越不易露出占位图,但会增加无效流量。线上反馈部分图片滚到眼前仍是
default.png,刷新后又正常;你会如何区分是可见性判断、事件监听还是资源加载失败?先记录元素的
data-src、矩形位置和触发时机,确认load、scroll回调是否执行且可见性结果是否正确。再检查赋值后的网络请求、响应状态和图片解码错误;当前代码一赋值就清空data-src,失败后无法自然重试,因此应在load成功后清理并在error中保留重试线索。内容团队建议直接给所有图片写
loading="lazy",前端同事坚持保留手写监听;在普通文章页你会怎么选?普通文章页可优先使用浏览器原生
loading="lazy",代码更少,也无需维护滚动监听和可见性计算。手写或IntersectionObserver更适合需要指定提前加载距离、埋点或复杂滚动容器的场景;原生策略的具体触发时机由浏览器决定,不能假设精确阈值。列表图片加载后页面频繁跳动,用户刚点到商品却被挤开;懒加载逻辑之外还要补什么布局约束?
应在真实图片到达前预留稳定尺寸,例如设置
width、height或aspect-ratio,让浏览器提前确定占位空间。懒加载只控制资源启动时机,不能自动避免布局偏移;若图片比例未知,需要由数据端提供尺寸或采用受控容器裁切。
# 7 实现 getValue/setValue 函数来获取path对应的值
⚡ 30 秒速记
getValue应逐层读取路径并在中途缺失时返回默认值,setValue则逐层创建对象,最后写入目标属性。- 示例中的
syncVarIterator用split('.')拆路径,读取异常会回退,写入遇到非对象节点会返回false。 - 因此它能直接处理点分路径,但题目里的
a[0].b.c需要先把方括号路径规范化。 - 后面的
enhancedObject实际借助Proxy递归搜索同名属性,适合便捷读取深层值,却不等同于按指定路径进行读写。
getValue 应逐层读取路径并在中途缺失时返回默认值,setValue 则逐层创建对象,最后写入目标属性。 示例中的 syncVarIterator 用 split('.') 拆路径,读取异常会回退,写入遇到非对象节点会返回 false。因此它能直接处理点分路径,但题目里的 a[0].b.c 需要先把方括号路径规范化。后面的 enhancedObject 实际借助 Proxy 递归搜索同名属性,适合便捷读取深层值,却不等同于按指定路径进行读写。
// 示例
var object = { a: [{ b: { c: 3 } }] }; // path: 'a[0].b.c'
var array = [{ a: { b: [1] } }]; // path: '[0].a.b[0]'
function getValue(target, valuePath, defaultValue) {}
console.log(getValue(object, "a[0].b.c", 0)); // 输出3
console.log(getValue(array, "[0].a.b[0]", 12)); // 输出 1
console.log(getValue(array, "[0].a.b[0].c", 12)); // 输出 12
实现
/**
* 测试属性是否匹配
*/
export function testPropTypes(value, type, dev) {
const sEnums = ['number', 'string', 'boolean', 'undefined', 'function']; // NaN
const oEnums = ['Null', 'Object', 'Array', 'Date', 'RegExp', 'Error'];
const nEnums = [
'[object Number]',
'[object String]',
'[object Boolean]',
'[object Undefined]',
'[object Function]',
'[object Null]',
'[object Object]',
'[object Array]',
'[object Date]',
'[object RegExp]',
'[object Error]',
];
const reg = new RegExp('\\[object (.*?)\\]');
// 完全匹配模式,type应该传递类似格式[object Window] [object HTMLDocument] ...
if (reg.test(type)) {
// 排除nEnums的12种
if (~nEnums.indexOf(type)) {
if (dev === true) {
console.warn(value, 'The parameter type belongs to one of 12 types:number string boolean undefined Null Object Array Date RegExp function Error NaN');
}
}
if (Object.prototype.toString.call(value) === type) {
return true;
}
return false;
}
}
const syncVarIterator = {
getter: function (obj, key, defaultValue) {
// 结果变量
const defaultResult = defaultValue === undefined ? undefined : defaultValue;
if (testPropTypes(obj, 'Object') === false && testPropTypes(obj, 'Array') === false) {
return defaultResult;
}
// 结果变量,暂时指向obj持有的引用,后续将可能被不断的修改
let result = obj;
// 得到知道值
try {
// 解析属性层次序列
const keyArr = key.split('.');
// 迭代obj对象属性
for (let i = 0; i < keyArr.length; i++) {
// 如果第 i 层属性存在对应的值则迭代该属性值
if (result[keyArr[i]] !== undefined) {
result = result[keyArr[i]];
// 如果不存在则返回未定义
} else {
return defaultResult;
}
}
} catch (e) {
return defaultResult;
}
// 返回获取的结果
return result;
},
setter: function (obj, key, val) {
// 如果不存在obj则返回未定义
if (testPropTypes(obj, 'Object') === false) {
return false;
}
// 结果变量,暂时指向obj持有的引用,后续将可能被不断的修改
let result = obj;
try {
// 解析属性层次序列
const keyArr = key.split('.');
let i = 0;
// 迭代obj对象属性
for (; i < keyArr.length - 1; i++) {
// 如果第 i 层属性对应的值不存在,则定义为对象
if (result[keyArr[i]] === undefined) {
result[keyArr[i]] = {};
}
// 如果第 i 层属性对应的值不是对象(Object)的一个实例,则抛出错误
if (!(result[keyArr[i]] instanceof Object)) {
throw new Error('obj.' + keyArr.splice(0, i + 1).join('.') + 'is not Object');
}
// 迭代该层属性值
result = result[keyArr[i]];
}
// 设置属性值
result[keyArr[i]] = val;
return true;
} catch (e) {
return false;
}
},
};
使用promise来实现
创建 enhancedObject 函数
const enhancedObject = (target) =>
new Proxy(target, {
get(target, property) {
if (property in target) {
return target[property];
} else {
return searchFor(property, target); //实际使用时要对value值进行复位
}
},
});
let value = null;
function searchFor(property, target) {
for (const key of Object.keys(target)) {
if (typeof target[key] === "object") {
searchFor(property, target[key]);
} else if (typeof target[property] !== "undefined") {
value = target[property];
break;
}
}
return value;
}
使用 enhancedObject 函数
const data = enhancedObject({
user: {
name: "test",
settings: {
theme: "dark",
},
},
});
console.log(data.user.settings.theme); // dark
console.log(data.theme); // dark
以上代码运行后,控制台会输出以下代码:
dark
dark
通过观察以上的输出结果可知,使用
enhancedObject函数处理过的对象,我们就可以方便地访问普通对象内部的深层属性。
💬 面试官追问
示例页传入
a[0].b.c,实现却只用key.split('.'),结果拿不到数组里的3;你怎么解释并修正这个反例?.分割后得到的首段是a[0],它不会自动解析为属性a和索引0,因此示例与实现并不匹配。应先把点号和方括号路径统一解析为['a','0','b','c']再逐层访问;若要支持带点的属性名或引号下标,则需要更完整的解析规则,不能只靠简单正则替换。配置后台每次渲染要读取数百个深层字段,路径既有
[0].a.b[0]也有user.profile.name,你会怎样落地getValue并处理默认值?先统一解析路径,再从
target逐段迭代;中间值为null、undefined或不可继续取属性时立即返回defaultValue。判断缺失不能只看最终值是否为undefined,否则对象中真实存在但值为undefined的属性会与路径不存在混淆,可按需求结合Object.hasOwn()明确语义。表单引擎调用
setValue(data, 'users[2].profile.name', 'A'),但users和索引2都不存在;要求自动补齐容器时,你会创建数组还是对象?应根据下一段是否为数组索引决定容器:后续段是非负整数时创建数组,否则创建普通对象,因此
users应为数组、users[2]应为对象。稀疏索引会产生空槽,超大索引还可能带来异常数据结构;若业务不接受稀疏数组,就应校验索引并让设置失败。线上所有
getter都突然返回默认值,排查发现代码调用testPropTypes(obj, 'Object'),而函数只在类型参数匹配\[object ...\]时返回结果;你怎么定位根因?根因是调用约定与实现不一致:传入
'Object'不会进入完整匹配分支,函数返回undefined,随后与false的比较也无法完成预期校验。应先用最小用例确认返回值,再统一为Object.prototype.toString.call(obj) === '[object Object]'或直接重写入口判断;修补时还要覆盖数组、null与跨realm对象。安全评审指出外部请求能提交路径
__proto__.polluted,而setValue会自动创建中间对象;在保留通用路径写入能力的前提下你怎么处理?解析路径后应拒绝
__proto__、prototype、constructor等危险片段,并优先只写入自有属性,避免形成原型污染链。还要限制路径深度和片段格式,不能把捕获异常后返回false当成安全机制;白名单字段最稳妥,但会牺牲通用性并增加配置维护成本。有人提议用文中的
Proxy递归搜索替代显式路径,让data.theme自动找到深层字段;当对象里两个模块都存在theme时你会选哪种方案?应保留显式路径,因为递归搜索遇到重名字段时只能依赖遍历顺序,调用者无法确认拿到哪个
theme。文中实现还共享全局value,递归未正确返回结果且连续查询可能残留旧值;Proxy适合定制访问行为,但不能替代具有确定语义的路径解析。
# 8 创建10个标签,点击的时候弹出来对应的序号
⚡ 30 秒速记
- 可以在循环中创建 10 个
a标签,并利用let的块级作用域,让点击回调拿到各自对应的序号。 - 每轮循环都会生成独立的
i,所以事件触发时执行alert(i),不会全部得到同一个值。 - 回调里的
this指向当前点击的a标签,e.preventDefault()用来阻止链接的默认跳转。 - 最后通过
appendChild()把标签依次追加到目标div中。
可以在循环中创建 10 个 a 标签,并利用 let 的块级作用域,让点击回调拿到各自对应的序号。 每轮循环都会生成独立的 i,所以事件触发时执行 alert(i),不会全部得到同一个值。回调里的 this 指向当前点击的 a 标签,e.preventDefault() 用来阻止链接的默认跳转。最后通过 appendChild() 把标签依次追加到目标 div 中。
var a
for(let i=0;i<10;i++){
a=document.createElement('a')
a.innerHTML=i+'<br>'
a.addEventListener('click',function(e){
console.log(this) //this为当前点击的<a>
e.preventDefault() //如果调用这个方法,默认事件行为将不再触发。
//例如,在执行这个方法后,如果点击一个链接(a标签),浏览器不会跳转到新的 URL 去了。我们可以用 event.isDefaultPrevented() 来确定这个方法是否(在那个事件对象上)被调用过了。
alert(i)
})
const d=document.querySelector('div')
d.appendChild(a) //append向一个已存在的元素追加该元素。
}
💬 面试官追问
把循环里的
let i改成var i后,页面上十个标签点击都弹出10;为什么this仍是当前标签,序号却错了?普通事件回调中的
this由事件派发时的调用方式决定,仍指向当前被监听的<a>;而var i只有一个函数级绑定,回调执行时循环已经结束,读取到的是10。可保留let的逐次绑定,或把序号写入dataset;若改用箭头函数,this又不会指向标签。商品筛选页要一次创建 10 个可点击序号,并避免每轮都执行
querySelector('div')和触发布局更新,你会怎么改这段代码?先在循环外缓存容器,再把十个节点追加到
DocumentFragment,最后一次性插入页面;序号可用textContent写入,避免把普通文本交给HTML解析。十个节点未必形成可感知性能问题,但这种结构减少重复查询和零散DOM写入,也让容器不存在时更容易集中处理。需求从固定 10 个标签变成接口返回的 5000 条,并且列表会增删重排;还给每个
<a>单独绑定监听器合适吗?更适合在稳定的父容器上做事件委托,通过
event.target.closest()找到带序号标记的子项,再读取当前数据标识。这样新增和删除节点无需同步管理大量监听器;但必须确认命中的元素属于该容器,并处理嵌套元素点击,否则可能读错目标或响应无关节点。线上点击序号没有跳转,但控制台能看到当前
<a>,监控又提示部分浏览器里编号为空;你会按什么顺序排查?先检查循环生成的文本和闭包变量,再确认监听器是否触发、
event.target与this是否符合预期,以及是否有其他监听器阻止传播或改写节点。preventDefault()只取消链接默认行为,不会保证编号存在;若序号来自dataset,还应检查服务端重渲染或节点复用是否覆盖了属性。设计师坚持用
<a>保持现有样式,但交互只是弹出序号、没有导航地址;在评审会上你会保留链接还是换元素?应优先换成
<button type="button">,因为动作语义不是导航,按钮天然支持键盘激活、焦点和禁用状态,也无需依赖preventDefault()。若受历史样式约束暂时保留<a>,需要补足可聚焦与键盘行为,但这是重复模拟原生能力,维护和无障碍风险都更高。点击标签内部新增图标后,埋点用
event.target记录元素,结果同一序号有时记成<a>、有时记成<svg>;该怎样稳定取得序号?单独绑定监听器时可用
event.currentTarget,它稳定指向注册监听器的<a>,文中普通函数里的this通常也与它一致。事件委托时则用event.target.closest('[data-index]')向上查找;不能直接依赖最内层target,同时要校验查找结果仍位于委托容器内。
# 9 版本号排序的方法
⚡ 30 秒速记
- 版本号可以先按
.拆成多个数字段,再逐段比较,并通过sort()实现降序排列。 - 比较时从第一段开始,当前段相同就继续检查下一段,不同则返回
s2 - s1,因此较大的版本排在前面。 - 如果其中一个版本先比较完,就用分段数量决定顺序,让段数更多的版本靠前。
- 按题目给出的结果,顺序是
['4.3.5','4.3.4.5','2.3.3','0.302.1','0.1.1']。
版本号可以先按 . 拆成多个数字段,再逐段比较,并通过 sort() 实现降序排列。 比较时从第一段开始,当前段相同就继续检查下一段,不同则返回 s2 - s1,因此较大的版本排在前面。如果其中一个版本先比较完,就用分段数量决定顺序,让段数更多的版本靠前。按题目给出的结果,顺序是 ['4.3.5','4.3.4.5','2.3.3','0.302.1','0.1.1']。
题目描述:有一组版本号如下 ['0.1.1', '2.3.3', '0.302.1', '4.2', '4.3.5', '4.3.4.5']。现在需要对其进行排序,排序的结果为 ['4.3.5','4.3.4.5','2.3.3','0.302.1','0.1.1']
arr.sort((a, b) => {
let i = 0;
const arr1 = a.split(".");
const arr2 = b.split(".");
while (true) {
const s1 = arr1[i];
const s2 = arr2[i];
i++;
if (s1 === undefined || s2 === undefined) {
return arr2.length - arr1.length;
}
if (s1 === s2) continue;
return s2 - s1;
}
});
console.log(arr);
💬 面试官追问
发布记录页按这段比较器降序排列
['4.2','4.3.5','4.3.4.5'],产品却发现需求给出的结果里没有4.2,你会怎样判断是排序代码错了还是示例错了?这段比较器不会过滤元素,因此
4.2应当仍在排序结果中,示例少了一项更像题面遗漏。先用包含全部输入且校验长度不变的测试确认,再让产品明确是否存在隐藏过滤规则;排序函数本身不应顺带承担筛选职责。依赖管理页出现
1.01.0、1.1.0和1.1,当前代码把前两项的对应段判为不同却又返回0,还把较长版本排在前面,你会怎么修正规则?先把每段转换为受控的十进制整数再比较,并明确尾部缺失段是否等价于
0。若业务认定三者等价,比较结束后应返回0;若要求展示顺序稳定,还需定义原字符串或段数作为次级规则,不能依赖含糊的前缀处理。制品平台要排序百万条纯数字版本号,单段可能超过
Number.MAX_SAFE_INTEGER,继续使用return s2 - s1会出现什么风险,怎么落地?超长数字段转成
Number后可能丢失精度,使不同版本被比较为相等或顺序错误。可先去除前导零,按数字字符串长度比较,长度相同再按字典序比较;这避免精度问题,但百万级排序仍有拆分和比较开销,应缓存解析结果。线上版本列表偶发顺序抖动,日志里混入空字符串、
1..2、末尾点号和非数字段,排查时你会先看哪里?先记录触发比较的原始值和解析后分段,确认比较器对任意两项都返回稳定、可传递的结果。对空段和非数字段应在排序前校验并选择拒绝、隔离或约定顺序;若直接做减法产生
NaN,比较器契约会被破坏,结果可能不可预测。包管理团队要求支持
1.0.0-alpha、1.0.0和构建元数据,而运营后台只处理点分十进制版本,你会共用这段实现还是拆开?运营后台若契约仅含非负整数段,可保留轻量比较器并补齐校验和前缀规则。包版本涉及预发布标识及构建元数据,已超出当前按点拆分并相减的模型,应采用明确的语义版本规则或成熟实现;强行共用会把两套排序语义混在一起。
# 10 请实现 DOM2JSON 一个函数,可以把一个 DOM 节点输出 JSON 的格式
⚡ 30 秒速记
DOM2JSON本质上是递归遍历DOM树,把每个节点转换成包含标签名和子节点数组的普通对象。- 当前节点通过
tagName记录名称,再初始化children,随后遍历childNodes并递归处理每个子节点。 - 递归结果依次放入
children,最终就能保留原有的父子层级。 - 示例代码使用字段
name,如果需要严格匹配题目展示的JSON格式,可以对应使用tag字段。
DOM2JSON 本质上是递归遍历 DOM 树,把每个节点转换成包含标签名和子节点数组的普通对象。 当前节点通过 tagName 记录名称,再初始化 children,随后遍历 childNodes 并递归处理每个子节点。递归结果依次放入 children,最终就能保留原有的父子层级。示例代码使用字段 name,如果需要严格匹配题目展示的 JSON 格式,可以对应使用 tag 字段。
<div>
<span>
<a></a>
</span>
<span>
<a></a>
<a></a>
</span>
</div>
把上面dom结构转成下面的JSON格式
{
tag: 'DIV',
children: [
{
tag: 'SPAN',
children: [
{ tag: 'A', children: [] }
]
},
{
tag: 'SPAN',
children: [
{ tag: 'A', children: [] },
{ tag: 'A', children: [] }
]
}
]
}
实现代码如下:
function dom2Json(domtree) {
let obj = {};
obj.name = domtree.tagName;
obj.children = [];
domtree.childNodes.forEach((child) => obj.children.push(dom2Json(child)));
return obj;
}
💬 面试官追问
详情页把格式化过的
<div>\n <span></span>\n</div>交给当前dom2Json,结果里出现多个没有name的节点,而且输出字段与约定的tag不一致,你会怎么改?childNodes会包含换行产生的文本节点,而文本节点没有tagName,当前实现也确实输出了name而非示例要求的tag。若目标只描述元素树,应遍历children或过滤nodeType === Node.ELEMENT_NODE,并统一返回{tag, children}。富文本编辑器要求导出文字内容,若简单把遍历从
childNodes改成children,页面中的“购买须知”为什么会丢失,你会怎样设计JSON?children只保留元素节点,所以文字和注释都会被忽略,适合原题却不适合富文本序列化。应按节点类型建立联合结构,例如元素记录tag和children、文本记录type: 'text'与内容;同时明确是否保留空白文本,避免格式化缩进污染数据。组件审计工具还要保存
<input disabled data-id="7">的属性,前端和安全同学对是否收集事件属性有冲突,你会怎么落地?可从元素的
attributes生成普通键值对象,并把它作为attrs放入节点结果,但应先定义允许保存的属性集合。onclick等事件属性、用户输入值及潜在敏感数据不能无条件采集;JSON只是结构描述,后续回放时也不能直接信任并注入页面。页面上有数万层异常嵌套节点,执行递归版后报
Maximum call stack size exceeded,你会如何定位并替换实现?先用节点计数和最大深度确认是深度导致的调用栈溢出,而不是普通节点数量过多。可用显式栈保存源节点和目标
JSON节点,逐层迭代构建;它能规避递归栈限制,但仍会生成同规模对象,内存压力需要另行限制。服务端渲染测试里传入的节点对象没有浏览器全局
Node,但团队又希望同一函数支持真实DOM和测试桩,你会按什么边界取舍?不要把实现强绑定到全局
Node常量,可依据明确传入的节点接口或数值型nodeType分支,并在入口校验tagName、子节点集合等能力。若还要求完整还原DOM,应改用标准序列化方案;原题的简化JSON无法保真表达命名空间、属性和文本。
# 11 分片思想解决大数据量渲染问题
⚡ 30 秒速记
- 大数据量渲染可以拆成多个小批次,并通过
requestAnimationFrame()分帧插入DOM,避免一次性完成全部工作。 - 示例每次创建 20 个
li,当前批次结束后递归处理剩余数据,直到数量归零。 - 这样做的核心是把连续的大任务拆开,让浏览器在不同帧中逐步完成渲染。
- 它更适合结构简单的数据;如果
DOM结构复杂或数据规模很大,通常需要考虑虚拟列表或虚拟表格。
大数据量渲染可以拆成多个小批次,并通过 requestAnimationFrame() 分帧插入 DOM,避免一次性完成全部工作。 示例每次创建 20 个 li,当前批次结束后递归处理剩余数据,直到数量归零。这样做的核心是把连续的大任务拆开,让浏览器在不同帧中逐步完成渲染。它更适合结构简单的数据;如果 DOM 结构复杂或数据规模很大,通常需要考虑虚拟列表或虚拟表格。
题目描述: 渲染百万条结构简单的大数据时 怎么使用分片思想优化渲染
let ul = document.getElementById("container");
// 插入十万条数据
let total = 100000;
// 一次插入 20 条
let once = 20;
//总页数
let page = total / once;
//每条记录的索引
let index = 0;
//循环加载数据
function loop(curTotal, curIndex) {
if (curTotal <= 0) {
return false;
}
//每页多少条
let pageCount = Math.min(curTotal, once);
window.requestAnimationFrame(function () {
for (let i = 0; i < pageCount; i++) {
let li = document.createElement("li");
li.innerText = curIndex + i + " : " + ~~(Math.random() * total);
ul.appendChild(li);
}
loop(curTotal - pageCount, curIndex + pageCount);
});
}
loop(total, index);
扩展思考:对于大数据量的简单 dom 结构渲染可以用分片思想解决 如果是复杂的 dom 结构渲染如何处理?
这时候就需要使用虚拟列表了,虚拟列表和虚拟表格在日常项目使用还是很多的
💬 面试官追问
日志页把十万条
<li>每帧插入20条后,首屏不再长时间卡死,但全部加载完仍然滚动迟钝、内存持续升高,为什么分片没有解决根因?分片只把创建工作摊到多个帧,最终仍会保留十万个真实
DOM节点,因此布局、绘制、内存和滚动成本没有消失。日志页应优先使用虚拟列表,只渲染视口及缓冲区;代价是要处理高度估算、滚动定位和节点复用。商品列表每个卡片包含图片、价格和多个按钮,固定每帧渲染
20条时低端设备仍明显掉帧,你会怎样调整调度策略?固定条数不能代表固定耗时,复杂卡片的单项成本可能远高于简单
<li>。可在每帧记录已消耗时间,接近当前帧预算就停止并把剩余任务留到下一次requestAnimationFrame;预算过小会延长完成时间,过大仍会阻塞交互。搜索页刚开始分片渲染十万条旧结果,用户立刻输入新关键词,旧任务却继续向同一个
<ul>追加内容,你会怎样避免结果串页?为每次搜索建立任务标识或取消状态,帧回调执行前校验当前任务,失效后立即停止递归并清理旧容器。还要在组件卸载时调用
cancelAnimationFrame或让回调安全退出;只清空DOM而不取消任务,旧数据仍会再次写入。监控显示分片列表每次追加后都有频繁布局,虽然每帧只有几十项仍耗时偏高,你会从
DOM写入路径排查什么?先用性能面板确认耗时落在脚本、样式计算还是布局,并检查循环内是否夹杂尺寸读取。每一批可先写入
DocumentFragment,再一次性追加到容器,同时避免写后立即读布局属性;这能降低提交次数,但不能消除最终节点总量的成本。聊天记录要求支持不定高消息、图片加载后高度变化和跳转到指定消息,团队在“继续分片”与“虚拟列表”之间争论,你会怎么选?
持续增长且需要长期滚动的聊天记录更适合虚拟列表,因为分片最终仍会累积全部节点。实现时需维护高度缓存、图片加载后的重新测量和滚动锚定,跳转目标未测量时只能先估算再校正;复杂度明显高于固定高度列表。
# 12 实现一个add方法完成两个大数相加
⚡ 30 秒速记
- 可以把两个大数当作字符串,从末位开始逐位相加,并手动处理进位。
- 先用
padStart把两个字符串补到相同长度,再从右向左计算当前位之和,把个位拼到结果前面,同时用Math.floor(t / 10)保存进位。 - 循环结束后如果仍有进位,需要继续补到结果最前面。
- 这样不会把完整大数转成
Number,因此能处理超出安全整数范围的输入。
可以把两个大数当作字符串,从末位开始逐位相加,并手动处理进位。 先用 padStart 把两个字符串补到相同长度,再从右向左计算当前位之和,把个位拼到结果前面,同时用 Math.floor(t / 10) 保存进位。循环结束后如果仍有进位,需要继续补到结果最前面。这样不会把完整大数转成 Number,因此能处理超出安全整数范围的输入。
// 题目
let a = "9007199254740991";
let b = "1234567899999999999";
function add(a ,b){
//...
}
实现代码如下:
function add(a ,b){
//取两个数字的最大长度
let maxLength = Math.max(a.length, b.length);
//用0去补齐长度
a = a.padStart(maxLength , 0);//"0009007199254740991"
b = b.padStart(maxLength , 0);//"1234567899999999999"
//定义加法过程中需要用到的变量
let t = 0;
let f = 0; //"进位"
let sum = "";
for(let i=maxLength-1 ; i>=0 ; i--){
t = parseInt(a[i]) + parseInt(b[i]) + f;
f = Math.floor(t/10);
sum = t%10 + sum;
}
if(f!==0){
sum = '' + f + sum;
}
return sum;
}
💬 面试官追问
账单页调用
add('999', '1')能得到1000,但传入add('', '12')、add('12a', '3')或数字类型时会产生异常结果,你会把输入契约定成什么?应明确只接收由十进制数字字符组成的非空字符串,并在补齐和逐位计算前完成校验,不合法输入直接抛出可识别异常。数字类型可能在传入前已经丢失精度,不能再转字符串补救;是否允许前导零也应写进返回规范。
订单系统需要计算两个各有百万位的正整数,当前循环不断执行
sum = digit + sum,你担心哪部分成本,怎么调整?逐位加法本身按最大位数线性推进,但反复在字符串头部拼接可能造成大量中间字符串和复制。可把每一位结果从低到高写入数组,结束后反转并
join('');数组同样占用与位数成比例的内存,超大输入仍需设置资源上限。财务同学把需求改成支持
-120加35,继续沿用当前进位循环为什么不够,你会如何拆分?当前实现只识别数字字符,没有符号和借位逻辑,不能直接支持负数。应先解析符号和绝对值,异号时比较绝对值大小并执行大数减法,同号时复用加法;若再加入小数,还需先定义精度和小数位对齐规则。
线上偶发返回带
NaN的字符串,调用链只记录了最终结果,排查这段代码时你会增加哪些观测和测试?先在函数入口记录脱敏后的类型、长度和格式校验结果,在发现非数字字符时中止,而不是让
parseInt把错误传播到每一位。测试应覆盖不同长度、连续进位、全零、前导零和非法字符;不要记录完整超长账号或金额原文。运行环境已经支持
BigInt,基础库负责人认为手写逐位加法应删除,而面试官又要求展示算法,你会怎样取舍?业务只处理整数且环境与序列化链路都支持时,
BigInt更简洁,但输入仍应从字符串构造,且不能与Number混算,JSON也不能直接序列化它。手写版适合证明进位原理或兼容受限环境,生产选型还要看位数上限和接口格式。
# 13 怎么在制定数据源里面生成一个长度为 n 的不重复随机数组 能有几种方法 时间复杂度多少(字节)
⚡ 30 秒速记
- 可以用查重、标记、交换或随机删除四种方式生成不重复随机数组,原实现给出的复杂度分别是
O(n²)、O(n)、O(n)和O(n)。 - 查重法每次用
includes判断是否重复,写法直观,但数据增多后开销更明显。 - 标记法记录已选位置,交换法则把抽中的元素与未抽取区末尾交换,两者都能避免结果重复。
- 我一般更倾向交换法,不过要先复制数据源,并确保
n不超过数据源长度。
可以用查重、标记、交换或随机删除四种方式生成不重复随机数组,原实现给出的复杂度分别是 O(n²)、O(n)、O(n) 和 O(n)。 查重法每次用 includes 判断是否重复,写法直观,但数据增多后开销更明显。标记法记录已选位置,交换法则把抽中的元素与未抽取区末尾交换,两者都能避免结果重复。我一般更倾向交换法,不过要先复制数据源,并确保 n 不超过数据源长度。
第一版 时间复杂度为 O(n^2)
function getTenNum(testArray, n) {
let result = [];
for (let i = 0; i < n; ++i) {
const random = Math.floor(Math.random() * testArray.length);
const cur = testArray[random];
if (result.includes(cur)) {
i--;
break;
}
result.push(cur);
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 10);
第二版 标记法 / 自定义属性法 时间复杂度为 O(n)
function getTenNum(testArray, n) {
let hash = {};
let result = [];
let ranNum = n;
while (ranNum > 0) {
const ran = Math.floor(Math.random() * testArray.length);
if (!hash[ran]) {
hash[ran] = true;
result.push(ran);
ranNum--;
}
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 10);
第三版 交换法 时间复杂度为 O(n)
function getTenNum(testArray, n) {
const cloneArr = [...testArray];
let result = [];
for (let i = 0; i < n; i++) {
debugger;
const ran = Math.floor(Math.random() * (cloneArr.length - i));
result.push(cloneArr[ran]);
cloneArr[ran] = cloneArr[cloneArr.length - i - 1];
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 14);
值得一提的是操作数组的时候使用交换法 这种思路在算法里面很常见
最终版 边遍历边删除 时间复杂度为 O(n)
function getTenNum(testArray, n) {
const cloneArr = [...testArray];
let result = [];
for (let i = 0; i < n; ++i) {
const random = Math.floor(Math.random() * cloneArr.length);
const cur = cloneArr[random];
result.push(cur);
cloneArr.splice(random, 1);
}
return result;
}
const testArray = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14];
const resArr = getTenNum(testArray, 14);
💬 面试官追问
抽奖页用第一版从
14个奖品中抽10个,命中重复项时执行了i--后又break,结果经常不足10个,你会怎样修正?break会直接结束整个for循环,i--无法让下一轮重试,因此结果长度会不足。这里至少应改为continue,并先校验n不超过可抽取数量;不过越接近抽满时,重复重试越多,运行次数并不稳定。题库数组存的是题目对象,第二版标记随机下标后却把
ran放进结果,页面最终展示一串数字,你会如何修复并说明“不重复”的含义?若需求是从数据源抽取元素,结果应放入
testArray[ran],哈希只负责记录已使用的下标。按下标去重允许数据源中的相同值被抽中多次;若业务要求值唯一,必须先定义对象的唯一键并校验可用唯一项数量。运营要从一百万条数据中随机取十条,复制整个数组的交换法和反复重试的标记法发生选型冲突,你会倾向哪一个?
当
n远小于数据源长度时,下标标记法只保存少量已选位置,通常比完整复制数组更节省额外内存,碰撞概率也较低。它的循环次数不是严格固定;若要求确定的O(n)次选择,可使用基于映射的部分洗牌,但实现更复杂。评审会上有人声称“边遍历边
splice”版本是O(n),当需要从十万项中抽取大部分元素时,你会怎样回应?循环虽然执行
n次,但数组中间位置的splice需要搬移后续元素,因此总成本不能只按循环次数算作O(n)。抽取比例较高时可采用交换法或完整洗牌,避免每轮搬移;代价是复制并维护整个数据源。广告实验要求每个候选项被抽中的机会一致,线上却有人把
Math.random()换成按权重返回的函数并继续使用交换法,你会检查什么?均匀随机交换依赖每轮在剩余区间内等概率选择下标,带权函数会改变抽样分布,不能再宣称无放回均匀抽样。先通过可控随机源做边界测试并检查区间是否包含所有剩余位置;若需求确为加权无放回,应另行定义算法和权重更新规则。
# 14 查找数组公共前缀(美团)
⚡ 30 秒速记
- 可以把数组第一个字符串作为基准,逐步扩大前缀,并用
startsWith检查其他字符串是否都匹配。 - 每次取
str.slice(0, index + 1),只要某个元素为空或不再以该片段开头,就返回上一次已经确认的前缀。 - 比如
flower、flow和flight检查到第三个字符时失败,因此结果是fl。 - 如果第一个字符串为空,循环不会执行,最终会直接返回空字符串。
可以把数组第一个字符串作为基准,逐步扩大前缀,并用 startsWith 检查其他字符串是否都匹配。 每次取 str.slice(0, index + 1),只要某个元素为空或不再以该片段开头,就返回上一次已经确认的前缀。比如 flower、flow 和 flight 检查到第三个字符时失败,因此结果是 fl。如果第一个字符串为空,循环不会执行,最终会直接返回空字符串。
题目描述
编写一个函数来查找字符串数组中的最长公共前缀。
如果不存在公共前缀,返回空字符串 ""。
示例 1:
输入:strs = ["flower","flow","flight"]
输出:"fl"
示例 2:
输入:strs = ["dog","racecar","car"]
输出:""
解释:输入不存在公共前缀。
答案
const longestCommonPrefix = function (strs) {
const str = strs[0];
let index = 0;
while (index < str.length) {
const strCur = str.slice(0, index + 1);
for (let i = 0; i < strs.length; i++) {
if (!strs[i] || !strs[i].startsWith(strCur)) {
return str.slice(0, index);
}
}
index++;
}
return str;
};
💬 面试官追问
搜索页传入
["flower","flow",""],产品认为空字符串应被忽略,但当前代码直接返回"";这是算法错误还是需求冲突?这是输入语义未统一,不应直接归因于算法错误;按题意,空字符串参与比较时,最长公共前缀必然是
""。若产品要忽略空值,应在调用前过滤并明确全为空时的结果,否则会掩盖上游数据缺失。批量导入页面一次校验十万条字符串,当前实现反复执行
slice和startsWith,你会怎样改写并评估复杂度?应先以第一项为候选前缀,逐项缩短候选,或按字符位置横向比较,避免每增长一个字符都创建新的切片。比较量受字符串总字符数约束,但具体耗时仍受前缀长度和字符串分布影响,需要用真实数据基准验证。
接口把输入从普通英文扩展到
emoji和组合字符,页面要求按用户看到的字符返回公共前缀,当前按length和slice处理是否可靠?当前实现按
UTF-16码元切分,可能截断代理对,也可能把组合字符拆开,因此不满足按可见字符处理的要求。可先用Intl.Segmenter按字素簇分段再比较;代价是实现与运行环境要求更高,缺少支持时需引入兼容方案。线上偶发报错显示
Cannot read properties of undefined,日志里输入可能是[]、null或含非字符串元素,你会从哪里定位?报错首先指向
strs[0]或后续字符串方法调用,应记录输入类型、数组长度及异常元素位置,复现空数组和非字符串成员。函数入口要明确契约:非法输入抛错还是返回"";不宜无条件String化,否则会把数据错误变成看似合法的前缀。代码评审中一方主张先排序,只比较首尾字符串;另一方坚持逐项扫描,面向无序的百万级输入你支持哪种方案?
仅为求公共前缀时更倾向逐项扫描,因为排序会改变输入或复制数组,并引入额外比较成本。首尾法适合数据本来已有序或排序结果还会复用的场景;若输入以流形式到达,维护并逐步缩短候选前缀更自然。
# 15 判断括号字符串是否有效(小米)
⚡ 30 秒速记
- 判断括号字符串是否有效,适合用栈保存左括号,遇到右括号时检查它是否与最近的左括号匹配。
- 字符串长度为奇数时不可能完全配对,可以直接返回
false;遍历时左括号入栈,右括号则通过映射表和pop的结果比较。 - 像
(]会因为类型不匹配而立即失败,()[]{}则能依次配对。 - 遍历结束后还要确认栈为空,否则说明仍有左括号没有闭合。
判断括号字符串是否有效,适合用栈保存左括号,遇到右括号时检查它是否与最近的左括号匹配。 字符串长度为奇数时不可能完全配对,可以直接返回 false;遍历时左括号入栈,右括号则通过映射表和 pop 的结果比较。像 (] 会因为类型不匹配而立即失败,()[]{} 则能依次配对。遍历结束后还要确认栈为空,否则说明仍有左括号没有闭合。
题目描述
给定一个只包括 '(',')','{','}','[',']' 的字符串 s ,判断字符串是否有效。
有效字符串需满足:
- 左括号必须用相同类型的右括号闭合。
- 左括号必须以正确的顺序闭合。
示例 1:
输入:s = "()"
输出:true
示例 2:
输入:s = "()[]{}"
输出:true
示例 3:
输入:s = "(]"
输出:false
答案
const isValid = function (s) {
if (s.length % 2 === 1) {
return false;
}
const regObj = {
"{": "}",
"(": ")",
"[": "]",
};
let stack = [];
for (let i = 0; i < s.length; i++) {
if (s[i] === "{" || s[i] === "(" || s[i] === "[") {
stack.push(s[i]);
} else {
const cur = stack.pop();
if (s[i] !== regObj[cur]) {
return false;
}
}
}
if (stack.length) {
return false;
}
return true;
};
💬 面试官追问
表单校验传入
"([)]",左右括号数量完全相等,但产品同学认为应该通过;你怎样用当前实现说明反例?该字符串不能通过,因为有效性不仅要求数量相等,还要求最近打开的括号最先闭合。扫描到
)时栈顶是[,与映射期望的]不符,应立即返回false;仅做计数会漏掉交叉嵌套。编辑器需要在用户每次输入时校验一段几十万字符的模板,直接从头运行
isValid会造成长任务,你会怎样落地?单次完整校验仍是线性扫描,栈空间最坏与未闭合左括号数量同阶;每次按键都全量重算会重复劳动。可做防抖、放到
Worker,或按文本分块维护括号摘要,但增量方案更复杂,跨块嵌套与撤销操作必须正确合并。语法高亮器把输入扩展为包含普通字符、字符串字面量和注释,当前
else分支会把任何非左括号都当右括号,应该怎样调整约束?若普通字符允许出现,当前实现会错误弹栈并返回
false,需要先明确只忽略普通字符,还是还要识别字符串和注释中的括号。前者可仅处理六种括号;后者已接近词法分析,必须维护引号、转义和注释状态,不能只改映射表。线上监控发现输入
")"与"(()"都返回false,但日志无法区分失败原因;你会怎样补充排查能力而不改变布尔接口?可在内部校验器返回失败位置、实际字符、期望字符和剩余栈,再由现有
isValid只取布尔值,保持调用方兼容。对")"会记录空栈遇到右括号,对"(()"会记录扫描结束仍有未闭合项;详细内容应限制长度,避免日志膨胀。团队争论用正则反复删除
()、[]、{},还是保留栈实现;用于服务端校验大文本时你选哪个?应保留栈实现,它一次扫描即可验证嵌套顺序,也能自然报告首个错误位置。反复替换虽然代码短,但通常需要多轮创建新字符串,深层嵌套时开销更难控制;只有输入很短且只追求临时代码简洁时才值得考虑。
# 16 实现一个padStart()或padEnd()的polyfil
⚡ 30 秒速记
- 实现
padStart()时,先算出目标长度与原字符串长度的差值,再循环取padString的字符补到字符串开头。 - 如果原字符串已经达到目标长度,就直接返回;
padString默认使用空格,填充超出目标长度时要及时停止。 padEnd()的逻辑相同,只需把填充字符追加到末尾。- 它适合补齐日期或金额格式,但要留意填充串长度不固定的情况。
实现 padStart() 时,先算出目标长度与原字符串长度的差值,再循环取 padString 的字符补到字符串开头。 如果原字符串已经达到目标长度,就直接返回;padString 默认使用空格,填充超出目标长度时要及时停止。padEnd() 的逻辑相同,只需把填充字符追加到末尾。它适合补齐日期或金额格式,但要留意填充串长度不固定的情况。
String.prototype.padStart 和 String.prototype.padEnd是ES8中新增的方法,允许将空字符串或其他字符串添加到原始字符串的开头或结尾。我们先看下使用语法:
String.padStart(targetLength,[padString])
用法:
'x'.padStart(4, 'ab') // 'abax'
'x'.padEnd(5, 'ab') // 'xabab'
// 1. 若是输入的目标长度小于字符串原本的长度则返回字符串本身
'xxx'.padStart(2, 's') // 'xxx'
// 2. 第二个参数的默认值为 " ",长度是为1的
// 3. 而此参数可能是个不确定长度的字符串,若是要填充的内容达到了目标长度,则将不要的部分截取
'xxx'.padStart(5, 'sss') // ssxxx
// 4. 可用来处理日期、金额格式化问题
'12'.padStart(10, 'YYYY-MM-DD') // "YYYY-MM-12"
'09-12'.padStart(10, 'YYYY-MM-DD') // "YYYY-09-12"
polyfill实现:
String.prototype.myPadStart = function (targetLen, padString = " ") {
if (!targetLen) {
throw new Error('请输入需要填充到的长度');
}
let originStr = String(this); // 获取到调用的字符串, 因为this原本是String{},所以需要用String转为字符串
let originLen = originStr.length; // 调用的字符串原本的长度
if (originLen >= targetLen) return originStr; // 若是 原本 > 目标 则返回原本字符串
let diffNum = targetLen - originLen; // 10 - 6 // 差值
for (let i = 0; i < diffNum; i++) { // 要添加几个成员
for (let j = 0; j < padString.length; j++) { // 输入的padString的长度可能不为1
if (originStr.length === targetLen) break; // 判断每一次添加之后是否到了目标长度
originStr = `${padString[j]}${originStr}`;
}
if (originStr.length === targetLen) break;
}
return originStr;
}
console.log('xxx'.myPadStart(16))
console.log('xxx'.padStart(16))
还是比较简单的,而padEnd的实现和它一样,只需要把第二层for循环里的${padString[j]}${orignStr}换下位置就可以了。
💬 面试官追问
订单页执行
"xxx".myPadStart(5, "sss")得到"ssxxx",但执行"x".myPadStart(4, "ab")时你如何证明填充截断方向没有写反?目标需要补三个字符,原生语义应先重复填充串得到足够内容,再从其开头截取
"aba",结果是"abax"。当前逐字符前插会反转多字符填充的累积顺序,可能得到错误结果,因此不能用单字符示例证明正确。旧浏览器项目准备把实现挂到
String.prototype,代码评审担心枚举污染和重复覆盖,你会怎样部署这个polyfill?应先检测原生
String.prototype.padStart是否存在,只在缺失时定义,并用Object.defineProperty设置为不可枚举、可配置和可写。直接赋值会让方法出现在某些属性遍历中,也可能覆盖原生实现;工程上还要统一由兼容层加载,避免多份补丁竞争。财务格式化传入
targetLen为0、负数、字符串数字或极大值,当前if (!targetLen)直接抛错是否符合原生语义?不符合严格
polyfill的目标,0或负长度通常应在长度转换后直接返回原字符串,而不是因为假值抛错。实现应按规范化后的整数长度判断,并处理不可接受的超大结果;若只是业务辅助函数,也必须把更严格的参数契约写清楚。线上页面在调用
"a".myPadStart(5, "")后卡死,采样显示循环持续运行但字符串长度不变,你怎样定位并修复?空填充串使内层循环一次也不执行,而外层循环仍按差值反复运行;规模更大时会表现为明显阻塞。入口应在字符串化
padString后检测长度为零并直接返回原字符串,同时为目标长度转换和结果大小设置合理保护。一位同事主张继续双层循环,另一位建议用
repeat后slice;在长填充串和较大目标长度下你倾向哪种实现?更倾向计算缺口后使用
padString.repeat(Math.ceil(diff / padString.length)).slice(0, diff),再与原串拼接,语义更直观且避免逐字符反复创建字符串。它会一次分配较大的中间字符串,因此目标长度不可信时仍需限制;兼容环境也要确认repeat可用。
# 17 设计一个方法提取对象中所有value大于2的键值对并返回最新的对象
⚡ 30 秒速记
- 可以先用
Object.entries()把对象转成键值对数组,过滤出值大于2的项,再通过Object.fromEntries()生成新对象。 - 这样不会直接修改原对象,筛选条件也集中在
filter()中,代码比较直观。 - 例如
{ a: 1, b: 3, c: 4 }会得到{ b: 3, c: 4 }。 - 使用时要确认运行环境支持
Object.fromEntries()。
可以先用 Object.entries() 把对象转成键值对数组,过滤出值大于 2 的项,再通过 Object.fromEntries() 生成新对象。 这样不会直接修改原对象,筛选条件也集中在 filter() 中,代码比较直观。例如 { a: 1, b: 3, c: 4 } 会得到 { b: 3, c: 4 }。使用时要确认运行环境支持 Object.fromEntries()。
实现:
var obj = { a: 1, b: 3, c: 4 }
foo(obj) // { b: 3, c: 4 }
方法有很多种,这里提供一种比较简洁的写法,用到了ES10的Object.fromEntries():
var obj = { a: 1, b: 3, c: 4 }
function foo (obj) {
return Object.fromEntries(
Object.entries(obj).filter(([key, value]) => value > 2)
)
}
var obj2 = foo(obj) // { b: 3, c: 4 }
console.log(obj2)
// ES8中 Object.entries()的作用:
var obj = { a: 1, b: 2 }
var entries = Object.entries(obj); // [['a', 1], ['b', 2]]
// ES10中 Object.fromEntries()的作用:
Object.fromEntries(entries); // { a: 1, b: 2 }
💬 面试官追问
风控配置对象是
{a: 3, b: "4", c: null},页面只想保留数值字段;照源码里的value > 2会出现什么语义问题?宽松比较会把字符串
"4"转成数字后保留下来,而null不会通过,这可能与“只保留数值字段”的业务要求冲突。若契约限定数值,应先检查typeof value === "number",并决定是否排除NaN和无穷值,避免隐式转换吞掉脏数据。管理后台每秒处理数万条扁平对象并生成新对象,
Object.entries().filter()再Object.fromEntries()带来多层临时数组,你会怎样改写?可用
Object.keys或for...of Object.entries(obj)单次遍历,把符合条件的自有可枚举字符串键写入结果对象,减少filter产生的中间数组。优化是否必要要由分配与耗时采样决定;直接循环会牺牲一些声明式可读性。需求改为递归筛选嵌套对象,但数组要保持结构、对象中被删空的分支也要移除;原方案还能直接扩展吗?
原方案只处理对象第一层,不能直接满足递归、数组保形和空分支清理这三个约束。需要先定义叶子值比较规则,再分别遍历数组与普通对象并自底向上裁剪;若输入可能有循环引用,还要用
WeakSet检测,否则递归会失控。线上发现返回对象缺少一个
Symbol键,且某个继承属性也没有进入结果;你会如何判断这是缺陷还是预期?Object.entries只枚举对象自身、可枚举的字符串键,因此忽略Symbol和继承属性是既定行为。应先核对接口是否承诺保留这些属性;若要包含Symbol可改用Reflect.ownKeys并检查描述符,而继承属性通常不应悄然复制。安全评审要求结果对象不能受
__proto__等特殊键影响,同时还要保留普通数据键;你会保留Object.fromEntries还是手写赋值?Object.fromEntries以数据属性方式构造结果,比对普通对象执行result[key] = value更不容易触发继承的__proto__设置器。若改成循环,可使用Object.create(null)或Object.defineProperty;前者没有常规原型方法,可能影响下游序列化与类型判断。
# 18 实现一个拖拽
⚡ 30 秒速记
- 拖拽的核心是在
mousedown时记录鼠标与元素左上角的偏移量,再在mousemove中根据鼠标位置更新元素的left和top。 - 事件绑在
document上,鼠标移出元素后仍能继续拖动;松开鼠标时要清理移动和抬起事件。 - 为了不让元素跑出视口,还要结合视口尺寸和元素宽高限制坐标范围。
- 元素本身需要使用绝对定位。
拖拽的核心是在 mousedown 时记录鼠标与元素左上角的偏移量,再在 mousemove 中根据鼠标位置更新元素的 left 和 top。 事件绑在 document 上,鼠标移出元素后仍能继续拖动;松开鼠标时要清理移动和抬起事件。为了不让元素跑出视口,还要结合视口尺寸和元素宽高限制坐标范围。元素本身需要使用绝对定位。
<style>
html, body {
margin: 0;
height: 100%;
}
#box {
width: 100px;
height: 100px;
background-color: red;
position: absolute;
top: 100px;
left: 100px;
}
</style>
<div id="box"></div>
window.onload = function () {
var box = document.getElementById('box');
box.onmousedown = function (ev) {
var oEvent = ev || window.event; // 兼容火狐,火狐下没有window.event
var distanceX = oEvent.clientX - box.offsetLeft; // 鼠标到可视区左边的距离 - box到页面左边的距离
var distanceY = oEvent.clientY - box.offsetTop;
document.onmousemove = function (ev) {
var oEvent = ev || window.event;
var left = oEvent.clientX - distanceX;
var top = oEvent.clientY - distanceY;
if (left <= 0) {
left = 0;
} else if (left >= document.documentElement.clientWidth - box.offsetWidth) {
left = document.documentElement.clientWidth - box.offsetWidth;
}
if (top <= 0) {
top = 0;
} else if (top >= document.documentElement.clientHeight - box.offsetHeight) {
top = document.documentElement.clientHeight - box.offsetHeight;
}
box.style.left = left + 'px';
box.style.top = top + 'px';
}
box.onmouseup = function () {
document.onmousemove = null;
box.onmouseup = null;
}
}
}
💬 面试官追问
页面向下滚动后拖动绝对定位的方块,鼠标指针与元素逐渐错位;当前用
clientX配合offsetLeft,坐标系哪里冲突了?clientX是视口坐标,而offsetLeft相对offsetParent,滚动、边框或非根定位容器都会让两者不在同一坐标系。可用getBoundingClientRect计算指针偏移,并把移动坐标转换到定位容器;容器滚动时还要纳入其滚动量。看板页有几十个可拖卡片,同时要支持鼠标、触控笔和手机触摸,你会怎样替换源码中的事件绑定?
应优先统一为
PointerEvents,在元素上监听pointerdown,移动期间通过setPointerCapture持续接收对应pointerId的事件,并在结束或取消时清理。还需配置合适的touch-action,否则浏览器滚动手势可能与拖拽竞争;旧环境才考虑分别适配鼠标和触摸。产品把边界从整个视口改为一个可滚动、带内边距且经过
transform的画布,原来的clientWidth - offsetWidth还能用吗?不能直接沿用,因为边界应以画布内容区或指定可拖区域为准,且
transform后视觉尺寸与布局尺寸可能不同。应基于容器和元素的getBoundingClientRect统一计算可视边界;若画布缩放,还要把指针位移按缩放比例换算。线上偶发出现松开鼠标后方块仍跟随移动,尤其是在元素外释放或窗口失焦时,你会检查哪些监听器?
源码把
mouseup绑在box上,指针在元素外释放时事件可能收不到,导致document.onmousemove未清理。应把结束监听放到document或使用指针捕获,并同时处理pointercancel、窗口失焦及组件卸载;清理函数要能重复执行。性能评审发现拖动时每个
mousemove都写left、top,复杂页面持续触发布局;改用transform是否一定更好?高频移动通常更适合在
requestAnimationFrame中合并更新,并用transform: translate(...)改变视觉位置,减少布局链上的影响。但最终位置、碰撞检测和持久化仍需统一坐标模型,且大量元素提升合成层会增加内存,不能无条件使用will-change。无障碍负责人指出卡片只能用指针拖动,键盘用户无法排序;你会怎样把拖拽与相邻的交互语义串起来?
应提供可聚焦的拖拽手柄和键盘操作,例如进入移动模式后用方向键调整位置,并通过可感知文本反馈当前位置或排序结果。视觉拖动与数据顺序必须由同一状态更新;仅补
tabindex不足以表达抓取、移动和放置流程。
# 19 基于Promise.all实现Ajax的串行和并行
⚡ 30 秒速记
- 并行请求可以把多个
Ajax请求放进Promise.all(),串行请求则要等上一个异步请求成功后再执行下一个。 Promise.all()会同时启动任务,并在全部成功后按原顺序返回结果,只要一个失败,整体就进入失败分支。- 请求较多时,我会用任务队列或多个执行链限制同时运行的数量,最后再用
Promise.all()汇总。 - 队列还要考虑结果顺序和单个任务失败时的处理方式。
并行请求可以把多个 Ajax 请求放进 Promise.all(),串行请求则要等上一个异步请求成功后再执行下一个。 Promise.all() 会同时启动任务,并在全部成功后按原顺序返回结果,只要一个失败,整体就进入失败分支。请求较多时,我会用任务队列或多个执行链限制同时运行的数量,最后再用 Promise.all() 汇总。队列还要考虑结果顺序和单个任务失败时的处理方式。
基于Promise.all实现Ajax的串行和并行
- 串行:请求是异步的,需要等待上一个请求成功,才能执行下一个请求
- 并行:同时发送多个请求「
HTTP请求可以同时进行,但是JS的操作都是一步步的来的,因为JS是单线程」,等待所有请求都成功,我们再去做什么事情?
Promise.all([
axios.get('/user/list'),
axios.get('/user/list'),
axios.get('/user/list')
]).then(results => {
console.log(results);
}).catch(reason => {
});
Promise.all并发限制及async-pool的应用
并发限制指的是,每个时刻并发执行的promise数量是固定的,最终的执行结果还是保持与原来的
const delay = function delay(interval) {
return new Promise((resolve, reject) => {
setTimeout(() => {
// if (interval === 1003) reject('xxx');
resolve(interval);
}, interval);
});
};
let tasks = [() => {
return delay(1000);
}, () => {
return delay(1003);
}, () => {
return delay(1005);
}, () => {
return delay(1002);
}, () => {
return delay(1004);
}, () => {
return delay(1006);
}];
/* Promise.all(tasks.map(task => task())).then(results => {
console.log(results);
}); */
let results = [];
asyncPool(2, tasks, (task, next) => {
task().then(result => {
results.push(result);
next();
});
}, () => {
console.log(results);
});
const delay = function delay(interval) {
return new Promise((resolve, reject) => {
setTimeout(() => {
resolve(interval);
}, interval);
});
};
let tasks = [() => {
return delay(1000);
}, () => {
return delay(1003);
}, () => {
return delay(1005);
}, () => {
return delay(1002);
}, () => {
return delay(1004);
}, () => {
return delay(1006);
}];
JS实现Ajax并发请求控制的两大解决方案
tasks:数组,数组包含很多方法,每一个方法执行就是发送一个请求「基于Promise管理」
function createRequest(tasks, pool) {
pool = pool || 5;
let results = [],
together = new Array(pool).fill(null),
index = 0;
together = together.map(() => {
return new Promise((resolve, reject) => {
const run = function run() {
if (index >= tasks.length) {
resolve();
return;
};
let old_index = index,
task = tasks[index++];
task().then(result => {
results[old_index] = result;
run();
}).catch(reason => {
reject(reason);
});
};
run();
});
});
return Promise.all(together).then(() => results);
}
/* createRequest(tasks, 2).then(results => {
// 都成功,整体才是成功,按顺序存储结果
console.log('成功-->', results);
}).catch(reason => {
// 只要有也给失败,整体就是失败
console.log('失败-->', reason);
}); */
function createRequest(tasks, pool, callback) {
if (typeof pool === "function") {
callback = pool;
pool = 5;
}
if (typeof pool !== "number") pool = 5;
if (typeof callback !== "function") callback = function () {};
//------
class TaskQueue {
running = 0;
queue = [];
results = [];
pushTask(task) {
let self = this;
self.queue.push(task);
self.next();
}
next() {
let self = this;
while (self.running < pool && self.queue.length) {
self.running++;
let task = self.queue.shift();
task().then(result => {
self.results.push(result);
}).finally(() => {
self.running--;
self.next();
});
}
if (self.running === 0) callback(self.results);
}
}
let TQ = new TaskQueue;
tasks.forEach(task => TQ.pushTask(task));
}
createRequest(tasks, 2, results => {
console.log(results);
});
💬 面试官追问
商品详情页要先拿商品信息,再用其中的
shopId请求店铺信息;同事把两个axios.get一起放进Promise.all,为什么第二个请求拿不到参数?这两个请求存在数据依赖,不能直接并行启动,应先
await商品请求,再根据返回的shopId发店铺请求。Promise.all适合彼此独立、只要求统一等待的任务;强行并行会让第二个请求在参数尚未产生时执行。报表页一次要拉取
200个互不依赖的接口,直接执行Promise.all(tasks.map(task => task()))有什么工程风险,你会怎么改?直接映射会立即启动全部
200个请求,无法限制同一时刻的并发量,应使用固定数量的工作循环或任务队列,例如把并发上限设为pool。每个任务完成后再补入下一项,并按原索引写入结果;上限需要结合服务端容量和浏览器环境确定。并发池要求最终结果与任务数组顺序一致,但当前代码在每个任务完成后执行
results.push(result),慢请求排在前面时会发生什么?push保存的是完成顺序,因此慢请求会被后完成的结果挤到后面,无法对应原任务位置。取任务时应记录oldIndex,完成后写入results[oldIndex];代价是结果数组在执行期间可能存在空位,不能把中间状态当成完整结果使用。文件列表页限制并发为
3,第一个工作循环遇到拒绝后,外层Promise.all已进入catch,但网络面板里仍有请求继续发出,先排查哪里?先检查其他工作循环是否仍在递归调用
run(),因为一个工作Promise拒绝只会让外层快速失败,不会自动停止已启动或其他循环中的任务。需要共享停止标记以阻止继续取任务;若还要终止网络请求,则任务本身必须支持AbortSignal,否则只能忽略后续结果。批量保存页面既要求“任一失败就提示整体失败”,又希望展示每一项的成功或失败状态,该选
Promise.all还是逐项收集?单独使用
Promise.all只能快速得到首个拒绝,不能直接提供完整的逐项状态,因此更适合严格的整体成功语义。若页面必须展示每项结果,应让任务自行转换为状态对象或使用等价的全量收集方案,再由业务判断整体状态;代价是必须明确部分成功后的补偿和重试规则。
# 20 修改嵌套层级很深对象的 key
⚡ 30 秒速记
- 不能用递归时,可以先用
JSON.stringify把对象转成字符串,删除下划线后再用JSON.parse还原。 - 这种写法不受嵌套深度影响,代码也比较短,转换失败时可以捕获异常并返回原对象。
- 需要注意,
replace(/_/g, "")会处理整个JSON字符串,所以属性值里的下划线也会被删掉。 - 若允许递归,则可以遍历每层的
key,生成新键后删除旧键。
不能用递归时,可以先用 JSON.stringify 把对象转成字符串,删除下划线后再用 JSON.parse 还原。 这种写法不受嵌套深度影响,代码也比较短,转换失败时可以捕获异常并返回原对象。需要注意,replace(/_/g, "") 会处理整个 JSON 字符串,所以属性值里的下划线也会被删掉。若允许递归,则可以遍历每层的 key,生成新键后删除旧键。
// 有一个嵌套层次很深的对象,key 都是 a_b 形式 ,需要改成 ab 的形式,注意不能用递归。
const a = {
a_y: {
a_z: {
y_x: 6
},
b_c: 1
}
}
// {
// ay: {
// az: {
// yx: 6
// },
// bc: 1
// }
// }
方法1:序列化 JSON.stringify + 正则匹配
const regularExpress = (obj) => {
try {
const str = JSON.stringify(obj).replace(/_/g, "");
return JSON.parse(str);
} catch (error) {
return obj;
}
};;
方法2:递归
const recursion = (obj) => {
const keys = Object.keys(obj);
keys.forEach((key) => {
const newKey = key.replace(/_/g, "");
obj[newKey] = recursion(obj[key]);
delete obj[key];
});
return obj;
};
💬 面试官追问
配置中心有个深层对象,只要求把属性名里的
_删除;同事用JSON.stringify(obj).replace(/_/g, ''),结果字符串值"user_name"也变成了"username",问题出在哪?正则作用于整段序列化文本,无法区分属性名和字符串值,所以它会误改业务数据。只有确认所有下划线都允许删除时才能采用这种捷径;否则应遍历对象结构,仅转换键名,并为数组、空值和非普通对象分别处理。
接口返回约
20层嵌套的普通JSON,题目明确禁止递归,你会怎样把所有a_b键改成ab,同时避免调用栈继续加深?使用显式栈或队列保存待处理节点及其目标容器,每次弹出一个对象,转换当前层键名,再把子对象压入容器继续处理。这样遍历深度由堆上的数据结构承载,不依赖函数调用栈;仍需防范输入规模过大造成的内存占用。
订单对象里除了普通对象还有数组,数组元素内部也有
sku_id;现有Object.keys方案直接给数组重命名键,会得到什么问题?数组的索引键不应执行去下划线转换,但数组元素中的对象仍需要继续遍历。实现时应先用
Array.isArray分流,保留数组结构并逐项处理;若把数组一律当普通对象重建,可能破坏其原型、长度语义及调用方对数组的判断。线上转换后某个字段消失,原对象同时存在
a_b和ab,两者转换后都会写到ab,你如何定位并处理?这是键名归一化后的冲突,后写入的值会覆盖先写入的值,删除旧键还会让问题更隐蔽。转换前应检测目标键是否已经存在并记录完整路径,再选择报错、保留原键或按业务规则合并;没有明确规则时不应静默覆盖。
团队在“序列化加正则”和“显式遍历”之间争论:输入保证来自后端标准
JSON,而且对象可能很深,你会怎么选?即使输入是标准
JSON,整段替换仍会修改字符串值,因此只有业务确认值中的_也应删除时才安全。显式遍历代码更长,但能只改键、处理冲突并保持结果结构;序列化方案还会创建大字符串,失败时返回原对象也可能掩盖数据未转换的事实。


